Opgesteld door: Openzeka Teknoloji A.Ş. — officiële Embedded Compute-distributeur van NVIDIA voor Türkiye & MEA, en NVIDIA Elite Partner
Een technische gids over hardwarearchitectuur, formaat en betrouwbaarheid
Doelgroep: ontwikkelaars die LLM’s serveren, MLOps-teams en praktijkdeskundigen Gepubliceerd: oktober 2026
Inhoudsopgave
- 1. Kort overzicht
- 2. Wat levert kwantisatie op?
- 3. Waarom verbetert kwantisatie de prestaties?
- 4. GPU-architectuur en kwantisatieformaat
- 5. Kwantisatieformaten
- 6. “4-bit = 4-bit” is niet waar
- 7. Waarom is NVFP4 anders?
- 8. GPU-architectuur × formaat: de juiste koppeling
- 9. Ampere: verwar INT4 niet met FP8
- 10. Ada en Hopper: de sterke positie van FP8
- 11. Blackwell: FP8 of NVFP4?
- 12. Mixed-precision kwantisatie
- 13. Waarom is kalibratie belangrijk?
- 14. Hoe kiest u een betrouwbaar gequantiseerd checkpoint?
- 15. Wat moet een goede modelkaart vermelden?
- 16. Hoe leest u een benchmark?
- 17. Praktijkvoorbeelden
- 18. PTQ of QAT?
- 19. De kwantisatiekeuzestroom
- 20. Veelgemaakte fouten
- 1. Zonder noodzaak naar 4-bit terwijl de hardware genoeg is voor het originele model
- 2. De benchmark van het originele model toekennen aan het gequantiseerde model
- 3. Zeggen dat “4-bit = 4-bit”
- 4. Native hardwareversnelling verwarren met softwaresupport
- 5. Alleen tokens/s meten
- 6. De KV-cache vergeten
- 7. Kalibratie-informatie negeren
- 8. Alleen op de algemene benchmark vertrouwen
- 21. Samenvattende beslistabel
- 22. Snelle opdrachtenreferentie
- 23. De kwaliteit van kwantisatie beoordelen
- 24. Woordenlijst
- 25. Conclusie
- 26. Bronnen
1. Kort overzicht
Met kwantisatie kunnen de gewichten van een LLM — en waar nodig activatie- en KV-cachegegevens — met een lagere precisie (de breedte van de numerieke voorstelling, dus het aantal bits) worden weergegeven. Dat verlaagt het geheugenverbruik, de vraag naar geheugenbandbreedte en, op geschikte hardware, de rekenkosten.
Waar kwantisatie vroeger vooral gold als “de noodgreep wanneer het model niet in het geheugen past”, worden formaten als FP8 en FP4 inmiddels in hardware versneld op moderne GPU’s. Bovendien geven veel modelontwikkelaars officieel, vooraf gequantiseerde checkpoints direct vrij.
Maar kwantisatie op zich betekent niet “minder bits = sneller”.
De juiste keuze ligt op het snijvlak van vier factoren:
Workload × Kwantisatieformaat × GPU-architectuur × Betrouwbaarheid van checkpoints
Drie kernregels
1. Als de modeleigenaar een officieel gequantiseerd checkpoint levert, beoordeel dat dan als eerste.
Dat maakt het niet automatisch het checkpoint van de hoogste kwaliteit; maar wat betreft kwantatiemethode, formaat en beoogde runtime is het meestal het betrouwbaarste startpunt.
2. Het formaat moet bij de GPU-architectuur passen.
Bijvoorbeeld:
- Ampere → op INT4/INT8 gebaseerde methoden
- Ada → FP8
- Hopper → FP8
- Blackwell → FP8 / NVFP4 / MXFP4
Dat een formaat zonder native Tensor Core-ondersteuning “alleen maar draait”, wil nog niet zeggen dat het snel draait.
3. De benchmark van het originele model is niet de benchmark van het gequantiseerde checkpoint.
De score van het BF16-model mag niet automatisch worden overgenomen voor het FP8- of FP4-checkpoint van datzelfde model.
Voor een gequantiseerd checkpoint moeten bovendien worden gecontroleerd:
- de gebruikte kwantatiemethode,
- het kalibratieproces,
- de benchmarkresultaten,
- de runtime,
- de GPU,
- de generatie-instellingen
2. Wat levert kwantisatie op?
Kwantisatie heeft drie fundamentele effecten:
- De modelgewichten worden kleiner
- De vraag naar geheugenbandbreedte daalt
- Rekenen met lage precisie via Tensor Cores wordt versneld op geschikte hardware
Hoeveel elk effect oplevert, hangt af van de workload.
2.1 Geheugenverbruik
In het ideale geval is het geheugen voor gewichten ongeveer:
Aantal parameters × bytes per parameter
Bijvoorbeeld:
| Precisie (bitbreedte) | Bits | 7B | 70B | 405B |
|---|---|---|---|---|
| BF16 / FP16 | 16 | ~14 GB | ~140 GB | ~810 GB |
| FP8 / INT8 | 8 | ~7 GB | ~70 GB | ~405 GB |
| 4-bit | 4 | ~3.5 GB | ~35 GB | ~202 GB |
Dit zijn alleen de ideale maten van de gewichten.
Het werkelijke GPU-geheugen is de som van:
Gewichten + KV-cache + activaties + runtime-overhead + kwantisatiemetadata
Vergeet bij MoE-modellen ook niet dat het totale aantal parameters en het aantal actieve parameters verschillen.
2.2 KV-cachekwantisatie is een aparte beslissing
Gewichtskwantisatie en KV-cachekwantisatie zijn niet hetzelfde.
Bijvoorbeeld:
BF16 weights + BF16 KV
BF16 weights + FP8 KV
FP8 weights + FP8 KV
NVFP4 weights + FP8 KV
NVFP4 weights + NVFP4 KV
zijn volledig verschillende deploymentprofielen.
Bij lange context en hoge gelijktijdigheid kan de KV-cache een behoorlijke hoeveelheid GPU-geheugen verbruiken. Daarom moeten
Weight quantization
        +
KV Cache quantization
samen worden bekeken.
FP8 KV-cache kan met een geschikte runtime en modelarchitectuur het KV-geheugen (het KV-cachegeheugen) ongeveer halveren; maar het effect op de aandachtkwaliteit moet per model en implementatie worden geverifieerd.
“Het is een belangrijke geheugenoptimalisatie bij lange context; het effect op de modelkwaliteit moet worden gecontroleerd.”
3. Waarom verbetert kwantisatie de prestaties?
Het fundamentele doel van kwantisatie is het geheugenverbruik en de dataverplaatsing te verminderen door modelgewichten met een lagere precisie op te slaan, en — waar hardware en kernels dat ondersteunen — de reken-doorvoer te verhogen.
De inferentieprestaties van een LLM worden grofweg begrensd door twee fundamentele bronnen:
- Geheugenbandbreedte: hoe snel de GPU modelgewichten en andere gegevens kan verplaatsen
- Rekendoorvoer: hoe snel de GPU matrixberekeningen kan uitvoeren met versnellende eenheden als Tensor Cores
Kwantisatie kan op beide punten voordeel geven.
3.1 Voordeel van geheugenbandbreedte
Wanneer modelgewichten met een lagere precisie worden bewaard, wordt het model kleiner.
Voor een model van ongeveer 70B parameters bijvoorbeeld:
| Precisie (bitbreedte) | Geschatte omvang gewichten |
|---|---|
| FP16 / BF16 | ~140 GB |
| FP8 / INT8 | ~70 GB |
| 4-bit | ~35 GB |
Deze krimp helpt niet alleen de VRAM-capaciteit. Omdat de GPU de modelgewichten tijdens inferentie door het geheugen moet verplaatsen, betekenen kleinere gewichten minder geheugenverkeer.
Dit kan vooral tellen bij lage gelijktijdigheid en decode-zware workloads: bij het produceren van één enkele token kan het lezen van de gewichten uit het geheugen een flinke kostenpost zijn vergeleken met de berekening die ermee wordt gedaan.
Vereenvoudigd:
Minder bits → kleiner model → minder dataverplaatsing → meer doorvoerpotentieel bij geheugengebonden workloads
De werkelijke doorvoer hangt echter af van de kernelopbouw, batchgrootte, KV-cache, GPU-architectuur en runtime. Een theoretische berekening van de geheugenbandbreedte mag daarom niet als echte inferentiedoorvoer worden beschouwd.
3.2 Voordeel van rekendoorvoer
Op moderne GPU’s is het voordeel van formaten met lage precisie niet alleen dat er minder gegevens worden verplaatst.
De Tensor Cores van een GPU voeren razendsnelle matrixberekeningen uit in specifieke precisieformaten. Als het gebruikte kwantisatieformaat op hardwareniveau wordt versneld, kan lagere precisie dus ook hogere rekendoorvoer opleveren.
Bijvoorbeeld:
- FP16/BF16 → matrixberekeningen met hoge precisie op Tensor Cores
- FP8 → lagere precisie en hoge Tensor Core-doorvoer
- FP4/NVFP4 → zeer hoge Tensor Core-doorvoer met lage precisie op architecturen als Blackwell
Daarom kan FP8 of FP4 een belangrijk voordeel geven, zelfs als de workload rekengebonden is.
Kortom:
Kwantisatie maakt het model niet alleen kleiner; waar de hardwaresupport bestaat, benut het ook de hogere rekenkracht van de GPU met lage precisie.
3.3 Effect van gelijktijdigheid en batchgrootte
Naarmate gelijktijdigheid en batchgrootte toenemen, worden meer tokens parallel verwerkt op hetzelfde model. De Tensor Cores van de GPU worden dan beter gevoed en het aandeel van rekendoorvoer in de totale prestatie kan groeien.
De bron van het kwantisatievoordeel kan dus per workload verschillen:
| Workload | Belangrijkste voordeel van kwantisatie |
|---|---|
| Eén gebruiker / lage gelijktijdigheid | Minder geheugenverkeer |
| Gemiddeld-hoge gelijktijdigheid | Voordeel in geheugen én rekenkracht |
| Grote batch / hoge doorvoer | Tensor Core-doorvoer is belangrijker |
| Rekengebonden workload | Tensor Core-doorvoer met lage precisie |
| Geheugengebonden workload | Minder gegevens verplaatsen |
Kwantisatie kan met de juiste hardware- en softwaresupport zowel de vraag naar geheugenbandbreedte verlagen als de inferentiedoorvoer verhogen door de rekenkracht van de GPU met lage precisie te benutten.
4. GPU-architectuur en kwantisatieformaat
Een kwantisatieformaat mag niet op zichzelf worden beoordeeld. De prestaties van hetzelfde precisieformaat kunnen per GPU-architectuur sterk verschillen.
De fundamentele reden is dat GPU’s formaten met lage precisie op verschillende niveaus ondersteunen.
4.1 Waarom is hardwaresupport belangrijk?
Dat een formaat de modelgewichten kleiner maakt, op zich garandeert het nog geen hoge prestaties.
Beschouw twee verschillende situaties:
Situatie A — rechtstreeks versneld door de hardware
Quantized weights
       ↓
Native GPU Tensor Core
       ↓
High throughput
Situatie B — extra conversie / speciale kernel nodig
Quantized weights
       ↓
Dequantization / conversion
       ↓
FP16/BF16 compute
       ↓
Extra cost
In het tweede geval kan het model minder VRAM gebruiken, maar blijft het volledige rekenvoordeel mogelijk uit.
Daarom moet men zich bij de kwantisatiekeuze niet alleen afvragen:
“Hoeveel bits?”
maar ook:
“Hoe wordt dit formaat op mijn GPU berekend?”
4.2 Algemene aanpak per GPU-generatie
| GPU-architectuur | Belangrijkste precisieondersteuning | Algemene aanpak |
|---|---|---|
| Ampere | FP16/BF16, INT8/INT4 | INT4/INT8-kwantisatie en geoptimaliseerde kernels zijn sterke keuzes |
| Ada Lovelace | FP16/BF16, FP8 | FP8 en kwantisatie met weinig bits te overwegen |
| Hopper | FP16/BF16, FP8 | FP8 is een sterke optie voor native versnelling |
| Blackwell | FP16/BF16, FP8, FP4/NVFP4 | FP8 en vooral NVFP4 zijn belangrijke opties |
Het doel hier is niet te zeggen dat “een nieuw formaat niet draait op een oudere GPU”. Software- en runtimesupport kan toestaan dat verschillende formaten worden gebruikt. Maar native Tensor Core-ondersteuning kan wat betreft prestaties een doorslaggevend voordeel geven.
4.3 FP8: de gebalanceerde keuze tussen geheugen en rekenwerk
Op architecturen als Hopper en Blackwell brengt FP8 twee belangrijke voordelen samen:
- Minder modelgeheugen dan FP16/BF16
- Door hardware versnelde, hoge Tensor Core-doorvoer
FP8 is dus niet alleen een formaat om het model in de VRAM te krijgen.
Vooral in inferentiesystemen met hoge gelijktijdigheid en een sterke focus op doorvoer:
Kleinere geheugenvoetafdruk + hogere rekendoorvoer met lage precisie
kunnen samen worden gerealiseerd.
Een van de belangrijke voordelen van FP8 ten opzichte van 4-bitformaten is de hogere numerieke precisie. Als het behoud van kwaliteit cruciaal is en het model goed met FP8 overweg kan, kan het een sterke voorkeur zijn.
4.4 FP4 / NVFP4: het hardwarevoordeel op Blackwell
Met de Blackwell-architectuur zijn formaten uit de FP4-klasse belangrijker geworden.
NVFP4 in het bijzonder mag niet alleen als een “4-bitmodel” worden beoordeeld. Het doel van het formaat is het geheugenvoordeel van smalle bitbreedtes te combineren met de Tensor Core-ondersteuning van Blackwell voor lage precisie.
NVFP4 kan dus in twee richtingen voordeel geven:
De geheugenkant
FP16 → FP8 → FP4
 ↓       ↓      ↓
Less model memory
Less data movement
De rekenkant
FP16/BF16
    ↓
FP8
    ↓
FP4 / NVFP4
    ↓
Blackwell low-precision Tensor Core throughput
Bij de afweging van NVFP4 op Blackwell is het dus niet genoeg te zeggen:
“Het model gebruikt minder VRAM omdat het 4-bit is.”
Het punt dat telt is:
NVFP4 kan zowel bij geheugengebonden als bij rekengebonden workloads voordeel geven door laag geheugenverbruik te combineren met de native rekenkracht van Blackwell met lage precisie.
4.5 De basisregel bij kwantisatiekeuze
Bij het kiezen van een kwantisatieformaat moeten vier factoren samen worden gewogen:
1. Modelkwaliteit
Hoeveel van de accuracy, perplexity en taakprestaties van het model blijft er over na kwantisatie?
2. Geheugenvoetafdruk
Hoeveel belasting leggen het model en de KV-cache op het GPU-geheugen?
3. Hardwareversnelling
Ondersteunt de GPU dit precisieformaat native via Tensor Cores of een andere speciale versneller?
4. Runtime- en kernelsupport
Hoe efficiënt voeren vLLM, SGLang, TensorRT-LLM, llama.cpp of welke inferentiestack u ook draait dit formaat uit?
Het formaat met het laagste aantal bits is dus niet automatisch het snelste.
De juiste keuze:
wordt gemaakt door modelkwaliteit + geheugenvoetafdruk + native hardwareversnelling + runtime- en kernelsupport samen te wegen.
5. Kwantisatieformaten
| Formaat / methode | Typisch gebruik | Belangrijkste voordeel |
|---|---|---|
| GGUF | llama.cpp / CPU+GPU | Flexibiliteit, brede hardwaresupport |
| GPTQ | NVIDIA inference | Veelgebruikte weight-only kwantisatie |
| AWQ | NVIDIA inference | Activation-aware gewichtskwantisatie |
| EXL2 | NVIDIA / ExLlama | Afweging kwaliteit-snelheid met variabele bpw |
| INT8 / SmoothQuant | Inference | Sterke optie bij de stap naar lage precisie |
| NF4 / bitsandbytes | QLoRA / fine-tuning | Ecosysteem voor training / fine-tuning |
| FP8 | Ada / Hopper / Blackwell | Native versnelling met lage precisie |
| NVFP4 | Blackwell | Zeer weinig geheugen + native FP4-versnelling |
| MXFP4 | Blackwell en ondersteunende platforms | Open MX-standaard, gericht op draagbaarheid |
6. “4-bit = 4-bit” is niet waar
Twee kwantatiemethoden met dezelfde nominale bitbreedte kunnen andere kwaliteit of prestaties geven.
Bijvoorbeeld:
INT4
AWQ
GPTQ
NF4
MXFP4
NVFP4
vallen allemaal in de “4-bit”-klasse, toch kunnen ze verschillen in:
- getalvoorstelling,
- scaling,
- blokgrootte,
- kalibratie,
- weight-only- of weight+activation-benadering,
- kernel,
- hardwareversnelling
Vandaar:
“4-bitmodel”
is op zich geen voldoende technische omschrijving.
Een nauwkeuriger omschrijving:
“NVFP4, een voor Blackwell geoptimaliseerd 4-bit zwevendekomaformaat met FP8-scaling over microblokken van 16 elementen”
moet ook de details van het formaat bevatten, zoals hier.
7. Waarom is NVFP4 anders?
NVIDIA NVFP4 is het 4-bit zwevendekomaformaat dat voor Blackwell is ontworpen.
De basisaanpak is:
FP4 values
    +
FP8 micro-scale
    +
FP32 tensor-level scale
In NVFP4 worden FP4-waarden geschaald met een FP8-schaal over microblokken van 16 elementen. Daarnaast wordt op tensorniveau een FP32-schaal gebruikt.
Deze aanpak beoogt de kwantatiefout te verkleinen ten opzichte van een eenvoudige FP4-voorstelling.
Volgens gegevens die NVIDIA heeft gepubliceerd kan NVFP4 een modelvoetafdruk opleveren die ongeveer 1,8× kleiner is dan FP8 en ongeveer 3,5× kleiner dan FP16; de werkelijke checkpointomvang hangt af van de metadata en het gebruikte mixed-precision recipe.
Dus:
NVFP4 = niet zomaar “4 bits”.
Het echte verschil is de combinatie:
4-bitvoorstelling + fijnmazige scaling + hardwareversnelling
8. GPU-architectuur × formaat: de juiste koppeling
Dit is een van de belangrijkste beslissingspunten.
| GPU-architectuur | Voorkeursopties | Noot |
|---|---|---|
| Pascal | GGUF Q4/Q5/Q6 | Geen moderne FP8/FP4 Tensor Core-functies |
| Turing | INT8 / INT4-methoden | Geen native FP8 Tensor Core-ondersteuning |
| Ampere | INT4 / INT8, AWQ/GPTQ | A100 ondersteunt native INT4/INT8 Tensor Cores |
| Ada | FP8, INT4 | Native FP8 Tensor Core-ondersteuning |
| Hopper | FP8 | FP8 + Transformer Engine is een sterke keuze |
| Blackwell | NVFP4 / FP8 / MXFP4 | Native FP4- en FP8-versnelling |
“Voorkeur” betekent hier niet dat het formaat voor elk model automatisch het beste is.
Model, runtime en workload moeten afzonderlijk worden beoordeeld.
9. Ampere: verwar INT4 niet met FP8
Ampere is vooral belangrijk om deze reden:
A100 / RTX 30
        ↓
Native INT4 / INT8 Tensor Core
        ↓
AWQ / GPTQ / Marlin-style INT4 deployments
De A100 ondersteunt INT4 Tensor Cores.
FP8 daarentegen is een precisie die haar intrede deed met Hopper en ook op Ada wordt ondersteund.
Dus op Ampere mag men niet aannemen:
“Er is een FP8-bestand, dus het zal sneller zijn.”
Een runtime kan een FP8-checkpoint op een bepaalde manier uitvoeren; maar native hardwareversnelling en support op softwareniveau zijn niet hetzelfde.
Voor 4-bit deployments op Ampere:
AWQ/GPTQ + een geschikte geoptimaliseerde kernel
is in de meeste gevallen het verstandigere startpunt.
10. Ada en Hopper: de sterke positie van FP8
Ada Lovelace biedt FP8-versnelling via Tensor Cores.
Hopper tilt FP8 verder met de Transformer Engine.
Dus:
Ada
 → FP8 is a serious option

Hopper
 → FP8 is a strong default for production inference
Maar niet van:
“FP8 is altijd 2× sneller dan FP16.”
Cijfers als 2× kunnen theoretische of piekvoordelen uitdrukken onder specifieke kernel- en doorvoeromstandigheden. De werkelijke LLM-doorvoer varieert met modelarchitectuur, batch, sequentielengte en runtime.
11. Blackwell: FP8 of NVFP4?
Op Blackwell is de kernvraag niet langer alleen:
“Kan ik het model tot 4-bit verkleinen?”
De betere vraag is:
“Wat past voor dit model beter wat betreft kwaliteit, geheugen en doorvoer: FP8 of FP4?”
FP8
Voordelen:
- hogere numerieke precisie
- doorgaans lagere kwantatiefout
- native versnelling op Blackwell
- een sterke optie bij workloads waarin kwaliteit cruciaal is
NVFP4
Voordelen:
- kleinere voetafdruk van de gewichten
- minder geheugenverkeer
- native FP4-versnelling op Blackwell
- het voordeel dat grotere modellen in kleinere GPU-clusters passen
Praktische aanpak
FP8
 ↓
Benchmark
 ↓
NVFP4
 ↓
Benchmark
 ↓
Compare quality + latency + throughput + VRAM
De uitkomst:
Quality difference acceptable
        → NVFP4

Quality critical
        → FP8
Deze beslissing moet per model worden genomen.
12. Mixed-precision kwantisatie
Moderne gequantiseerde checkpoints bewaren niet alle gewichten in hetzelfde format.
Er kan bijvoorbeeld een recipe als dit worden gebruikt:
MLP                 → NVFP4
Attention           → FP8
lm_head             → NVFP4 / higher precision
critical layers     → higher precision
De achterliggende gedachte is:
Niet elke laag is even gevoelig voor kwantatiefouten.
Een goede kwantisatiepipeline kan er dus als volgt uitzien:
Model
  ↓
Calibration
  ↓
Layer sensitivity analysis
  ↓
Mixed-precision recipe
  ↓
Quantization
  ↓
Benchmark
Dus alleen zeggen:
“Het model is 4-bit.”
is niet genoeg. Wat werkelijk telt is:
- welke lagen zijn gequantiseerd?
- welke precisie is gebruikt?
- wat is de blokgrootte?
- hoe is de scaling gedaan?
- wat is de kalibratiedataset?
- wat is het kalibratiealgoritme?
13. Waarom is kalibratie belangrijk?
Bij PTQ (Post-Training Quantization, kwantisatie na de training) moet de kalibratiedataset de werkelijke gebruiksverdeling van het model representeren.
Bijvoorbeeld, keuzes als deze hebben meer zin:
General chat model
    → general text calibration

Coding model
    → coding-weighted calibration

Agent model
    → tool-use / instruction / reasoning calibration
Het kalibratieproces kan beïnvloeden waar en hoe kwantatiefouten ontstaan.
Vandaar:
Zelfde model + zelfde 4-bitformaat ≠ zelfde kwaliteit
14. Hoe kiest u een betrouwbaar gequantiseerd checkpoint?
Bij het kiezen van een gequantiseerd model is de betrouwbaarheid van de bron cruciaal.
Voorkeursvolgorde
1. Het officiële checkpoint van de modeleigenaar
Dit is het beste startpunt.
2. Het checkpoint dat is vrijgegeven door de hardware- of inferenceleverancier
Bijvoorbeeld checkpoints op basis van NVIDIA Model Optimizer, waarvan de benchmark- en kalibratiedetails openlijk worden vermeld.
3. Quants van de framework- of inferencegemeenschap
Die kunnen goed uitpakken; maar de metadata- en benchmarkkwaliteit moeten apart worden gecontroleerd.
4. Kwantisatie uit de gemeenschap
Door de gemeenschap gemaakte kwantisatiebestanden mogen in productie niet worden gebruikt zonder verificatie van hun bron en productieproces.
Het risico hier is niet alleen een lage kwantisatiekwaliteit. Een gequantiseerd modelbestand mag niet als betrouwbaar worden beschouwd zonder verificatie van:
- wie het heeft geproduceerd,
- uit welk basismodel het is afgeleid,
- met welke kwantatiemethode en gereedschap het is gemaakt,
- welke kalibratiegegevens zijn gebruikt,
- of de integriteit van het modelbestand behouden is,
- of het compatibel is met de gebruikte runtime en kernels
Vooral in productiesystemen vormen modellen en kwantisatieartefacten van onbekende herkomst een risico in de toeleveringsketen. Aangezien modelgewichten en de bijbehorende bestanden de fundamentele invoer zijn van de inferentiepipeline die ze uitvoert, mag een betrouwbaarheidsbesluit niet alleen op een benchmarkscore worden gebaseerd.
Bekende uitgevers — een startlijst
De onderstaande rekeningen zijn startpunten die opvallen door hun productieproces en de transparantie van hun modelkaart. De naam van een uitgever is geen kwaliteitsgarantie; het geeft aan waar u de zoektocht kunt beginnen:
| Uitgever | Type | Typische formaten | Link(s) |
|---|---|---|---|
| NVIDIA (Model Optimizer) | Hardware- / productieleverancier | NVFP4, FP8 (mixed recipe) | HF nvidia · TensorRT-Model-Optimizer |
| RadixArk | SGLang-ecosysteem | NVFP4, blockwise FP8, MLX 4-bit, DSpark draft | HF RadixArk · cookbook.sglang.ai |
| Inferact | vLLM-ecosysteem | NVFP4, MXFP4, W4A4, EAGLE3 / DSpark draft | HF Inferact · inferact.ai |
| Red Hat AI | Inferenceleverancier | FP8, INT4 (AWQ/GPTQ) | HF RedHatAI |
| Intel | Hardware- / runtimeleverancier | INT8 / INT4 | HF OpenVINO · HF Intel · neural-compressor · openvino |
| ggml-org | Formaat-ecosysteem (llama.cpp) | GGUF | HF ggml-org |
| ISTA-DASLab | Universitair onderzoekslab — bron van GPTQ, SparseGPT, AQLM, QuIP# | GPTQ / MatGPTQ, NVFP4 (MoESQ), GGUF (GSQ-RCO), 2-bit (AQLM / QuIP#) | HF ISTA-DASLab · github.com/IST-DASLab |
LM Studio (lmstudio-community) |
Officiële modelpool van een lokale inferentieruntime | GGUF, MLX (4/6/8-bit) | HF lmstudio-community · lmstudio.ai |
| bartowski | Bekende uitgever uit de gemeenschap | GGUF, EXL2 | HF bartowski |
| unsloth | Ecosysteem voor training + quants | 4-bit dynamische kwantisatie, GGUF | HF unsloth |
Drie regels:
- De volgorde verandert niet: het officiële quant van de modeleigenaar → hardware-/inferenceleverancier → bekende uitgever → uw eigen quant (dezelfde voorkeursvolgorde als hierboven).
- De checklist staat vast: hoe bekend de uitgever ook is, zonder verificatie van de modelkaartlijst in §15 gaat er niets naar productie.
- De lijst veroudert: dit is een momentopname als startlijst; controleer elke keer de huidige activiteit van de uitgever en de transparantie van diens kaart.
Noot: Hetzelfde model kan door verschillende uitgevers worden gepubliceerd (bijv.
Qwen3.8-27B-NVFP4bestaat bij NVIDIA, RadixArk en Inferact). Vergelijking van uitgevers moet dan met het kwaliteitskader uit §23 gebeuren. RadixArk en Inferact publiceren niet alleen quants maar ook drafts voor speculatieve decodering (DSpark / EAGLE3).
15. Wat moet een goede modelkaart vermelden?
Een goed gequantiseerd checkpoint moet de onderstaande informatie zo volledig mogelijk geven. Niet alles weegt echter even zwaar; begin de beoordeling bij deze drie niveaus.
Kritiek — de basis die geverifieerd moet worden
Noot: Wat twee quants van elkaar scheidt is niet het nominale aantal bits maar de methode + scaling + kalibratie + recipe (§6, §13). De gemeten samenvatting van dat verschil is “een benchmarkvergelijking met het originele model” — het waardevolste item op de lijst, en zonder de omstandigheden (§16) betekenisloos.
- Basismodel
- Identiteit van producent / uitgever
- Kwantatiemethode (met vermelding van de precisie van gewichten en activaties)
- Benchmarkvergelijking met het originele model (met de omstandigheden: het enige meetbare bewijs van het kwaliteitsverschil tussen twee quants — §16)
Beslissend — hiermee beslist u wat in twijfel blijft
Technische details van de kwantisatie:
- Kalibratiedataset + algoritme + aantal voorbeelden (bij QAT-modellen in plaats daarvan het training-/post-training recipe en de kwantatiesimulatie — zie §17.4)
- Precisie van de gewichten
- Precisie van de activaties
- Precisie van de KV-cache (alleen verplicht als de benchmark of het aanbevolen deployment met een specifieke KV-precisie is gedraaid — het is op zich geen checkpointeigenschap maar een deploymentbeslissing: §2.2)
- Mixed-precision recipe
- Blok- / groepsgrootte
Benchmarkomstandigheden:
- Evaluatiedatasets
- Generatie-instellingen
- Contextlengte
- Geteste GPU + runtime
Compatibiliteit / schaal:
- Ondersteunde GPU-architecturen
- Tensor parallelism
Aanvullend — ze bepalen de technische kwaliteit niet, maar hun afwezigheid geeft praktische problemen
- Kwantisatiebibliotheek + versie
- Bestandsintegriteit (commit hash / checksum) + releasedatum
- Licentie
Hoe meer van deze informatie ontbreekt, hoe moeilijker het wordt om een gequantiseerd checkpoint zelfstandig te beoordelen.
16. Hoe leest u een benchmark?
Bij de beoordeling van de benchmark van een gequantiseerd model mag niet alleen naar de score zelf worden gekeken.
Bijvoorbeeld:
BF16     → 88.92
NVFP4    → 88.01
betekent op zichzelf weinig.
Deze zaken moeten ook gelijk zijn:
- benchmarkversion
- promptopmaak
- systeemprompt
- temperature
- top_p
- max_new_tokens
- contextlengte
- reasoning mode
- toolconfiguratie
Anders kunnen twee benchmarks niet rechtstreeks worden vergeleken.
De meest betrouwbare aanpak is:
BF16 baseline
      ↓
same benchmark
      ↓
same generation settings
      ↓
same runtime
      ↓
quantized model
      ↓
same benchmark
17. Praktijkvoorbeelden
De voorbeelden staan voor vier basisscenario’s, naar de herkomst van de gequantiseerde vorm:
- Dubbele uitgave — origineel BF16; de leverancier geeft daarnaast zijn eigen officiële FP8 vrij.
- Directe uitgave met weinig bits — het originele model komt al gequantiseerd uit.
- Kwantisatie door derden — de hardware-/inferenceleverancier quantiseert een model dat als BF16 is uitgegeven.
- 4-bit via QAT — kwantisatie treedt het trainingsstadium binnen.
Deze scenario’s komen overeen met de voorkeursvolgorde in §14: 1 en 2 → het officiële checkpoint van de modeleigenaar, 3 → het checkpoint van de hardware-/inferenceleverancier, 4 → de modeleigenaar (productie met QAT).
17.1 Scenario 1 — origineel BF16 + officiële FP8: Qwen3.8-27B
Qwen/Qwen3.8-27B is een model met 27B parameters.
Daarnaast heeft Qwen ook het
Qwen/Qwen3.8-27B-FP8
checkpoint vrijgegeven.
Het FP8-checkpoint gebruikt:
- fine-grained FP8
- blokgrootte 128
- BF16 + FP8 tensorlayout
De modelkaart van Qwen vermeldt dat de prestatiecijfers dicht bij die van het originele model liggen.
Les:
Het officiële FP8-deploymentcheckpoint vergelijken met de BF16-baseline binnen dezelfde modelfamilie is een sterke start voor de beoordeling van kwantisatie.
17.2 Scenario 2 — directe FP8-uitgave: GLM-5.3
zai-org/GLM-5.3 is een model in de 753B-klasse en is in zijn modelrepository als FP8 gelabeld, samen met de tensortypen BF16, F8_E4M3 en F32.
Wat hier telt:
Kwantisatie is niet langer alleen iets wat de gemeenschap achteraf toepast.
Modelleveranciers kunnen direct checkpoints met lage precisie uitgeven.
Les:
De precisie waarin een model wordt uitgegeven, wordt onderdeel van de deploymentarchitectuur.
17.3 Scenario 3 — kwantisatie door derden (NVIDIA): Qwen3.8-27B-NVFP4
nvidia/Qwen3.8-27B-NVFP4 is een deploymentcheckpoint dat met NVIDIA Model Optimizer is gemaakt.
Zijn modelkaart vermeldt deze details expliciet:
- Model Optimizer v0.48.0
- gemengde NVFP4/FP8
- NVFP4 → MLP +
lm_head - FP8 → self-attention + linear-attention
- 2.048 kalibratievoorbeelden
- Local-Hessian-kalibratie
- Nemotron-Post-Training-Dataset-v3
- vLLM
- Grace Blackwell GB300
De BF16- en NVFP4-resultaten zijn bovendien op dezelfde benchmarkset vergeleken.
| Benchmark | BF16 | NVFP4 |
|---|---|---|
| GPQA Diamond | 88.92 | 88.01 |
| Terminal-Bench | 75.56 | 74.02 |
| AA-LCR | 72.63 | 73.38 |
| MMMU-Pro | 75.14 | 74.86 |
| SciCode | 47.93 | 48.41 |
| IFBench | 80.07 | 78.93 |
De echte les is belangrijker dan de losse scores:
Het kwantatierecipe + kalibratie + de evaluatiemethode zijn openlijk gedocumenteerd.
Daardoor kan het checkpoint zelfstandig worden onderzocht en gereproduceerd.
17.4 Scenario 4 — 4-bit met QAT: Kimi K3
moonshotai/Kimi-K3 gebruikt:
- 2.8T total parameters
- 104B activated parameters
- 1M context
- MXFP4 weights
- MXFP8 activations
- Quantization-Aware Training (vanaf de SFT-fase)
De inferentieruntimes die de kaart aanbeveelt: vLLM, SGLang en TokenSpeed.
Het punt dat telt:
De modelleverancier maakt het model met quantization-aware training vanaf de SFT-fase, in plaats van kwantisatie achteraf toe te passen, en geeft het uit als MXFP4 / MXFP8. Hier is kwantisatie geen “compressiestap” na de training; het is een ontwerpbeslissing op de weg naar uitgave.
Dit voorbeeld verandert meerdere aannames tegelijk:
1. De aanname “origineel = BF16, gequantiseerd = afgeleide” gaat niet meer op.
De officiële uitgave van dit model is al 4-bit. Er is geen “terug naar BF16 om de kwaliteit te redden”; het referentiecheckpoint zelf is gequantiseerd.
2. Kwantisatie is niet langer het laatste redmiddel; bij sommige modellen is het de enige officiële vorm.
Dit is het sterkste voorbeeld van de stap “is er een officiële FP8/FP4-uitgave?” in de keuzestroom van §19: de geproduceerde gequantiseerde vorm van het model ís het model.
3. Het onderwerp is niet alleen gewichtskwantisatie.
Samen genomen zijn MXFP4 weights + MXFP8 activations kwantisatie van gewichten én activaties (full-tensor); het extreme voorbeeld van het onderscheid weight-only / weight+activation uit §6, anders dan de weight-only-benadering van AWQ/GPTQ.
4. MXFP4 is de open OCP-standaard.
Het is een voorbeeld van het draagbaarheidsdoel uit §5: een open familie van formaten die u niet aan één leverancier bindt. De motivatie van Moonshot AI is precies dezelfde; de kaart vermeldt dat de keuze voor MXFP4 / MXFP8 is gemaakt voor “brede hardwarecompatibiliteit”.
5. Kwaliteitsvalidatie wordt omgekeerd gelezen.
De vraag is niet “hoeveel heeft 4-bit verloren?” maar “is de trainingsconditie met 4 bits die de leverancier heeft getraind voldoende voor mijn workload?” Het antwoord komt uit de modelkaartbenchmark die u als in §16 leest, en uit uw eigen workloadtest in productie.
Les:
PTQ en QAT zijn niet hetzelfde.
PTQ:
BF16 model
   ↓
training completed
   ↓
quantization
QAT:
Quantized operating conditions
        ↓
part of the training / post-training process
        ↓
quantized model
Twee lessen komen daar nog bij:
Weinig bits is niet altijd een “compromis”. Bij QAT is 4-bit de beoogde bedrijfsconditie; de kwaliteit wordt daarvoor geoptimaliseerd. Het beeld “weinig bits = aanvaard verlies” geldt niet voor deze klasse modellen.
De checklist voor de modelkaart (§15) leest bij QAT-modellen anders. In plaats van een “kalibratiedataset” zoekt u het training-/post-training recipe en de in de training gebruikte kwantatiesimulatie; de kalibratiestroom uit §13 is specifiek voor PTQ.
18. PTQ of QAT?
| Kenmerk | PTQ | QAT |
|---|---|---|
| Toe te passen na de training | Ja | Nee / training nodig |
| Kosten | Lager | Hoger |
| Snel voor deployment | Ja | Langer proces |
| Kalibratie nodig | Meestal ja | Hangt van het recipe af |
| Zeer lage precisie | Moeilijker | Kan voordeliger zijn |
| Modelkwaliteit optimaliseren | Beperkt | Sterker |
| Praktisch voor bestaand model | Zeer geschikt | Duurder |
Voor deployment in productie is voor de meeste gebruikers PTQ het praktischer startpunt.
Maar bij zeer lage precisie of de uitrol van frontiermodellen kan QAT een belangrijke optie worden.
19. De kwantisatiekeuzestroom
Het praktische beslisproces hoort er als volgt uit te zien:
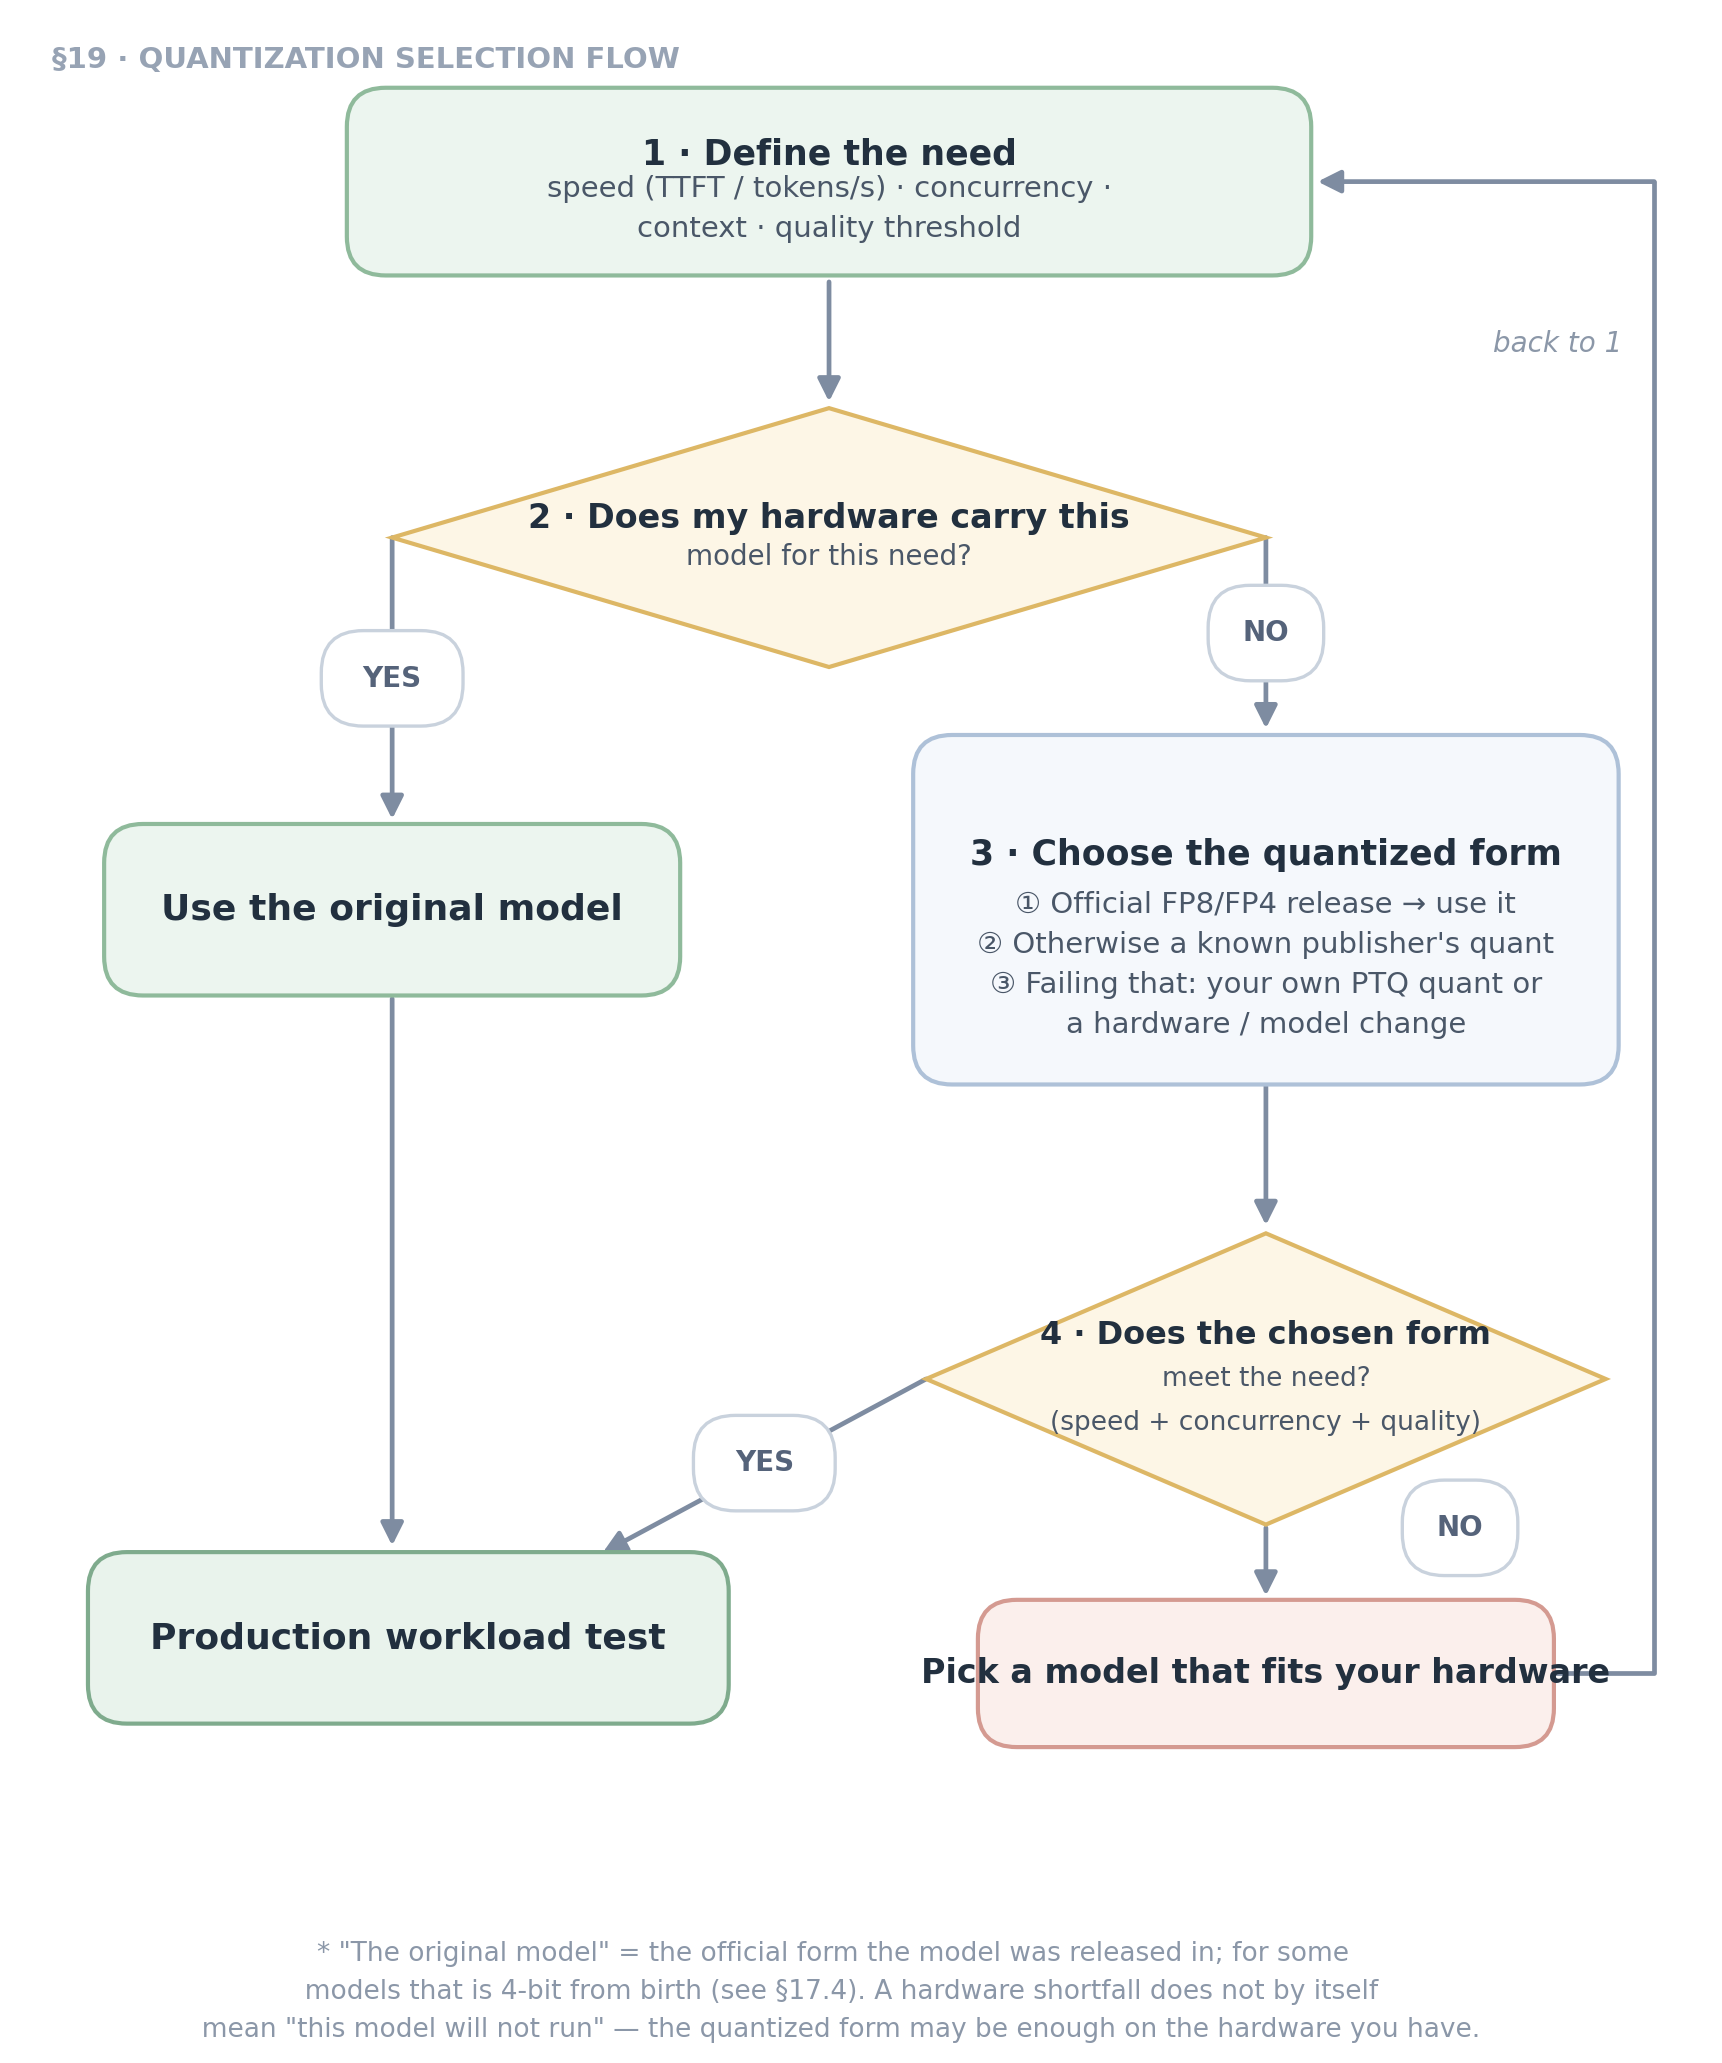
- Bepaal de behoefte: benodigde snelheid (TTFT / tokens/s), gelijktijdigheid, context, kwaliteitsdrempel.
- Draagt mijn hardware dit model voor deze behoefte?
- Ja → gebruik het originele model → workloadtest in productie.
- Nee → ga naar stap 3.
- Kies de gequantiseerde vorm:
- Als het model een officiële FP8/FP4-uitgave heeft → gebruik die.
- Anders het quant van een bekende uitgever (NVIDIA, bekende framework-/gemeenschapsuitgevers) gebruiken (zie §14).
- Als die er niet is → uw eigen quant (PTQ) of een hardware-/modelwissel.
- Levert de gekozen vorm wat de behoefte vraagt? (snelheid + gelijktijdigheid + kwaliteit)
- Ja → workloadtest in productie.
- Nee → kies een model dat bij uw hardware past en begin opnieuw bij stap 1.
Noot: “Origineel model” = de officiële vorm waarin het model is uitgegeven; bij sommige modellen is dat vanaf de geboorte 4-bit (zie §17.4).
Het basisprincipe:
Een tekort aan hardware betekent op zich niet “met dit model lukt het niet”. De gequantiseerde vorm van het model kan op de aanwezige hardware de benodigde snelheid en gelijktijdigheid geven; het doel is niet de laagste bits te kiezen, maar de behoefte te dekken met een precisie waarin de hardware sterk is.
Als echter hoge doorvoer of capaciteit het doel is, kan lagere precisie economisch de betere keuze zijn.
20. Veelgemaakte fouten
1. Zonder noodzaak naar 4-bit terwijl de hardware genoeg is voor het originele model
Lagere precisie is niet altijd beter. Als de hardware genoeg is voor het originele model — snelheid, gelijktijdigheid enz. — hoeft u niet voor niets te kwantiseren (zie §19).
2. De benchmark van het originele model toekennen aan het gequantiseerde model
Een BF16-resultaat:
is het resultaat van het BF16-checkpoint.
Het gequantiseerde checkpoint moet apart worden geverifieerd.
3. Zeggen dat “4-bit = 4-bit”
AWQ, GPTQ, NF4, MXFP4 en NVFP4 zijn niet hetzelfde.
4. Native hardwareversnelling verwarren met softwaresupport
Dat een runtime een formaat accepteert, wil niet zeggen dat de GPU dat formaat native versnelt.
5. Alleen tokens/s meten
Hogere doorvoer betekent geen betere deployment.
Ook TTFT, ITL, latentie en gelijktijdigheid moeten worden gemeten.
6. De KV-cache vergeten
Vooral bij lange context is de precisie van de KV-cache net zo belangrijk als gewichtskwantisatie.
7. Kalibratie-informatie negeren
Verschillende kalibratierecipes van hetzelfde format kunnen verschillende resultaten geven.
8. Alleen op de algemene benchmark vertrouwen
Als het werkelijke gebruik van het model code is, test dan code; is het een agent, test dan agentic gebruik; is het RAG, test dan de retrievalprestaties bij lange context.
21. Samenvattende beslistabel
| Scenario | Startvoorkeur |
|---|---|
| Kwaliteit cruciaal | BF16 / FP8 |
| Ada | Evalueer FP8 altijd |
| Hopper production serving | FP8 + een geschikte KV-cacheprecisie |
| Ampere 4-bit | AWQ/GPTQ + geoptimaliseerde INT4-kernel |
| Blackwell, maximale capaciteit / doorvoer | Evalueer NVFP4 |
| Blackwell, kwaliteit voorop | FP8 |
| Multi-vendor deployment | MXFP4 / ondersteunde gemeenschappelijke formaten |
| Lange context | Gewichtskwantisatie + KV-cacheprecisie samen |
| Fine-tuning / QLoRA | NF4 / een geschikte trainingsprecisie |
| Kritiek production deployment | Officieel checkpoint + uw eigen workloadbenchmark |
Noot: Stel eerst de vergelijking hardware × behoefte op (zie §19): als uw hardware het model voor uw behoefte draagt, gebruik dan het originele model; zo niet, bekijk dan de gequantiseerde vormen.
22. Snelle opdrachtenreferentie
FP8
vllm serve <model> \
  --quantization fp8 \
  --kv-cache-dtype fp8
NVIDIA NVFP4
vllm serve <model-nvfp4> \
  --kv-cache-dtype fp8_e4m3
AWQ / GPTQ
vllm serve <model-awq-or-gptq>
GGUF
llama-server \
  -m model-Q4_K_M.gguf \
  -ngl 99
Kwantisaties vergelijken
BF16 baseline
        ↓
FP8
        ↓
NVFP4 / INT4
        ↓
same benchmark
        ↓
same production workload
23. De kwaliteit van kwantisatie beoordelen
Er mag niet één universele drempel worden gebruikt.
Een algemene regel als:
“Als MMLU meer dan 1% daalt, is de kwantisatie mislukt.”
bijvoorbeeld klopt niet.
Een verlies van 1% kan in sommige workloads aanvaardbaar zijn, terwijl in sommige kritieke code- of redeneertoepassingen zelfs een heel kleine daling ertoe doet.
De juistere aanpak is samen wegen:
Quality loss
      ×
Business impact
      ×
Performance gain
      ×
Memory saving
Bijvoorbeeld bij een resultaat als:
FP8
Quality = 100
VRAM = 100
Speed = 1.0

NVFP4
Quality = 99.2
VRAM = 55
Speed = 1.7
kan NVFP4 de verstandigere keuze zijn.
Maar als het resultaat is:
Quality = 95
kan voor dezelfde deployment FP8 de voorkeur krijgen.
De juiste drempel komt dus uit:
de minimale kwaliteit die de workload kan accepteren + de benodigde prestaties + de beschikbare VRAM
24. Woordenlijst
BF16 / FP16 Doorgaans de referentieformaten met hoge precisie.
FP8 Een familie van 8-bit zwevendekomaformaten. Er zijn varianten als E4M3 en E5M2.
NVFP4 Het 4-bit zwevendekomaformaat dat voor NVIDIA Blackwell is ontworpen. Het gebruikt fine-grained scaling.
MXFP4 Het 4-bit zwevendekomaformaat uit de OCP Microscaling-formatfamilie.
MXFP8 Het 8-bit zwevendekomaformaat uit de OCP Microscaling-formatfamilie. Het heeft de voorkeur voor gegevens als activaties die een hogere numerieke precisie vragen; bijvoorbeeld de combinatie MXFP4 weights + MXFP8 activations (zie §17.4).
AWQ Activation-aware Weight Quantization. Vooral gangbaar bij weight-only INT4-deployments.
GPTQ Een methode voor gewichtskwantisatie na de training.
EXL2 De benadering met variabele bits per weight uit het ExLlama-ecosysteem.
GGUF Het modelbestandsformaat uit het llama.cpp-ecosysteem.
KV-cache De cache die tijdens attention de Key/Value-representatie van eerdere tokens bewaart.
PTQ Post-Training Quantization. Kwantisatie toepassen nadat de training is voltooid.
QAT Quantization-Aware Training. De effecten van kwantisatie tijdens de training in het model opnemen.
Kalibratie Het meetproces op representatieve gegevens om de kwantisatieparameters vast te stellen.
Blokgrootte / groepsgrootte Bepaalt op welke granulariteit kwantatiescaling of parametergroepering wordt toegepast.
Perplexity Een van de basismetingen van de voorspellingsprestaties van een taalmodel.
Precisie De vorm die aangeeft met hoeveel bits numerieke waarden (gewichten, activaties, KV-cache) worden weergegeven: “hogere precisie” = meer bits. In het Turks heet dit ook hassasiyet; maar het mag niet worden verward met de accuracy van het model. Lagere precisie gebruikt minder bits; dat betekent niet automatisch een slechter model.
MMLU / GSM8K / GPQA Benchmarks waarmee verschillende vaardigheidsgebieden worden gemeten.
25. Conclusie
Kwantisatie moet men noch bagatelliseren, noch beoordelen als “altijd sneller”.
In moderne LLM-deployment is kwantisatie:
een fundamenteel technisch instrument dat optimaliseert tussen geheugencapaciteit, geheugenbandbreedte, Tensor Core-doorvoer en deploymentkosten.
De juiste keuze kan niet alleen op het aantal bits worden gebaseerd.
Deze vier vragen moeten samen worden gesteld:
1. At which precision was the model released?

2. Which precision does the GPU accelerate natively?

3. How was the quantization produced, with which calibration recipe?

4. What do quality and performance look like in my real workload?
Hun uitkomst kiest de ideale deployment:
de precisie met de laagste kosten die aan de behoefte voldoet, efficiënt door de GPU wordt versneld en waarvan het kwaliteitsverlies is gemeten.
Dus de juiste aanpak van kwantisatie is:
“Kies het laagste aantal bits.”
Nee — het moet zijn:
“Behoud de kwaliteit die mijn workload nodig heeft, kies de precisie waarin de hardware sterk is en verifieer die op een echte deployment.”
26. Bronnen
- Z.ai — GLM-5.3 Model Card
- Qwen — Qwen3.8-27B Model Card
- Qwen — Qwen3.8-27B-FP8 Model Card
- NVIDIA — Qwen3.8-27B-NVFP4 Model Card
- NVIDIA Model Optimizer — Local-Hessian Quantization
- NVIDIA — Introducing NVFP4 for Efficient and Accurate Low-Precision Inference
- NVIDIA — Hopper Architecture
- NVIDIA — Ada Lovelace Architecture
- NVIDIA — A100 Architecture / Specifications
- NVIDIA TensorRT-LLM — Quantization Hardware Support
- Moonshot AI — Kimi K3 Model Card
- OCP Microscaling Formats — MXFP4 / MXFP8