Opgesteld door: Openzeka Teknoloji A.Ş. — officiële Embedded Compute-distributeur van NVIDIA voor Türkiye & MEA, en NVIDIA Elite Partner
Testplatform: 4× NVIDIA DGX Spark (GB10) · Model: DeepSeek-V4.1-Flash (763B) · Rapportdatum: september 2026
Inhoud
- 1. Inleiding
- 2. Modelarchitectuur
- 3. Hardware
- 4. vLLM-build en patchketen
- 5. Configuratie
- 6. Prestatieresultaten
- 7. Vergelijkende analyse
- 8. SLO en capaciteit
- 9. Conclusie
- Bijlage A: Instructies voor het bouwen van de Docker-image
- Bijlage B: Rijbereiken van Engram
- Bijlage C: Verificatiecommando’s
1. Inleiding
DeepSeek-V4.1-Flash is een multimodaal Mixture-of-Experts-model (MoE) met 552B backboneparameters.
De Hugging Face-checkpoint bevat 763B parameters: 552B backbone + 196B Engram conditional memory (volgens het technische rapport van het model) + ~15B voor de vision-encoder, de MLP-projector en het DSpark-draftmodel.
Het model wordt geleverd met kwantisatie (quantization) van de gewichten (weights) in MXFP8 dense + MXFP4 voor de experts en een FP4-KV-cache (E2M1), en ondersteunt contexten van maximaal één miljoen tokens.
Dit rapport beschrijft de deployment van dit model op 4× NVIDIA DGX Spark (GB10) met tensorparallellisme (tensor parallelism, TP=4).
DGX Spark is een mini-supercomputer met 128 GB unified LPDDR5X-geheugen en een bandbreedte (bandwidth) van 273 GB/s. Dat een datacentermodel van 763B op deze hardware kan draaien, is mogelijk dankzij tensorparallellisme over meerdere nodes en vooral de Engram-on-disk-techniek.
Twee aspecten maken dit werk het documenteren waard:
- Het model is van datacenterklasse. DeepSeek-V4.1-Flash wordt normaal gesproken geserveerd op DGX-B300 en hardware van vergelijkbare klasse. 4× DGX Spark vertegenwoordigt de schaalbare edge van de architectuur.
- 7 patches specifiek voor SM 12.1a. De standaard nightly-image van vLLM heeft ontbrekende of defecte codepaden voor SM 12.1a (GB10) — Engram-on-disk, FlashInfer sparse attention, SWA-blokgrootte, paginagroottes voor attention — die met patches uit de community worden verholpen.
Dit is een deploymenthandleiding, geen benchmarkvergelijking. De benchmarkresultaten worden gepresenteerd in sectie 6.
2. Modelarchitectuur
2.1 Overzicht
DeepSeek-V4.1-Flash introduceert een architectuur die de voetafdruk van de KV-cache drastisch verkleint. De belangrijkste specificaties:
| Component | Waarde |
|---|---|
| Backboneparameters | 552B |
| Totaal aantal parameters in de checkpoint | 763B (geverifieerd op HF) |
| Actieve parameters per token (prefill) | 8B |
| Actieve parameters per token (decode) | 16B |
| Engram conditional memory | 196B (spaarzaam benaderd via opzoeking op basis van tokens) |
| Gedeelde / gerouteerde experts | 1 / 384 (6 actief per token) |
| Maximale context | 1,000,000 tokens |
| Kwantisatie van de gewichten | MXFP8 dense + MXFP4-experts (blok 32×32, ue8m0-schaal) |
| Kwantisatie van de KV-cache | FP4 (E2M1, runtime — architectuurkenmerk van CSA2) |
| Grootte van de checkpoint | 510 GB (48 safetensors-bestanden — onder de theoretische 763 GB door de FP4-gewichten van de experts en gemengde precisie) |
2.2 Causal Encoder-Decoder-architectuur (CED)
Het model is een Transformer met 40 lagen, georganiseerd als een causale encoder van 20 lagen gevolgd door een decoder van 20 lagen. Het belangrijkste voordeel van CED: de globale KV-cache van de decoder wordt geprojecteerd uit de laatste verborgen toestanden (hidden states) van de encoder, in plaats van afgeleid uit de eigen verborgen toestanden van elke decoderlaag. Daardoor worden tijdens prefill slechts 8B parameters geactiveerd en tijdens decode 16B — een aanzienlijke kostenefficiëntie voor agentische workloads met veel invoer.
SWA Bounded Replay reconstrueert ontbrekende KV-toestanden door alleen de meest recente n_win tokens opnieuw af te spelen, in plaats van de KV-toestanden die nodig zijn voor Sliding Window Attention (SWA) in persistente opslag te bewaren. Daardoor hoeven SWA-KV-toestanden niet naar persistente opslag te worden geschreven, en wordt de persistente opslagvoetafdruk van de KV-cache teruggebracht tot ongeveer 1/8 van die van DeepSeek-V4-Flash.
2.3 Compressed Sparse Attention 2 (CSA2)
CSA2 kent elke attention-laag een van drie statische modi toe — Full, Reindex of Reuse — om de hoofd-KV en de indexer-K tussen lagen te delen en Top-K-indices van sparse attention te hergebruiken. In de decoder beperkt een Hierarchical Sparse Indexer latere indexeringslagen bovendien tot een kandidatenpool die door de eerste laag in Full Mode is opgebouwd, waardoor de kosten van diepere indexers begrensd blijven, onafhankelijk van de contextlengte (context length).
In combinatie met FP4-caching van de hoofd-KV (E2M1-formaat, één E4M3-schaal per 16 kanalen) brengen deze ontwerpen de voetafdruk van de globale KV-cache terug tot 890 bytes per token — ongeveer 1/4 van DeepSeek-V4-Flash.
2.4 Engram conditional memory
De Engram-laag van 196B wordt spaarzaam benaderd via opzoeking op basis van tokens. Deze deployment gebruikt de modus Engram-on-disk: Engram-rijen worden op de lokale schijf van elke node opgeslagen in plaats van in het GPU-geheugen, en naar behoefte in het GPU-geheugen klaargezet. Daardoor past het model van 763B binnen 4× 128 GB (in totaal 512 GB) unified memory.
Voor het opzoekmechanisme van de embeddings, het geheugenbudget en de interpretatie van de resultaten van offloading, zie Conditional memory en offloading bij LLM-inferentie.
2.5 Speculatieve decodering met DSpark
DSpark is een mechanisme voor speculatieve decodering (speculative decoding) dat semi-autoregressieve draftgeneratie combineert met verificatie die op basis van betrouwbaarheid wordt ingepland. Deze deployment gebruikt een diepte van k=5 — bij elke decodestap worden 5 tokens vooruit voorspeld en geverifieerd. Geverifieerde tokens worden aan de uitvoer toegevoegd; afgewezen tokens worden opnieuw gegenereerd.
3. Hardware
| Component | Waarde |
|---|---|
| GPU | Blackwell-architectuur (GB10), SM 12.1a (CC 12.1), 48 SM’s |
| GPU-geheugen | 128 GB unified LPDDR5X (gedeeld door CPU+GPU) |
| Geheugenbandbreedte | ~273 GB/s (unified) |
| FP4-piek (met sparsity) | ~1 PFLOP |
| CPU | Arm met 20 cores (10× Cortex-X925 + 10× Cortex-A725) |
| Verbinding tussen nodes | NVIDIA ConnectX-7, 200 Gb/s RDMA (QSFP) |
| Opslag | 4× NVMe-SSD (4× 4 TB verdeeld over 4 nodes) |
| Netwerktopologie | 200 GbE-switch (geen NVLink; all-reduce via Ethernet) |
Cruciaal architectonisch gegeven: er is geen NVLink tussen de DGX Sparks. TP=4 in deze deployment is tensorparallellisme over meerdere nodes via een ConnectX-7-netwerk van 200 GbE — elke all-reduce-bewerking loopt via een 200 GbE-switch over de Ethernet-fabric.
4. vLLM-build en patchketen
In de standaard nightly-image van vLLM ontbreken binnen de codepaden van DeepSeek-V4.1-Flash de paden voor SM 12.1a (GB10). Deze sectie documenteert de buildketen en de 7 patches die zijn toegepast om de aangepaste Docker-image (vllm-dsv41:latest, 33.8 GB) te maken.
4.1 Basisimage en vLLM-branch
- Basisimage:
vllm/vllm-openai:nightly-8a728663c1c3eeace834a95f5654fa653cc1998c - vLLM-branch: uitgecheckt via
build/fetch_vllm_branch.sh, commite47aa780b - Bronrepository: tonyd2wild/DeepSeek-V4.1-Flash-vLLM-DGX-Spark (boot10-configuratie)
4.2 Overlay-buildketen
De build bestaat uit 5 overlaylagen en een patchlaag. Elke overlay bouwt voort op de vorige:
| Stap | Naam | Inhoud |
|---|---|---|
| 1 | C-extensie | _C_stable_libtorch + _moe_C_stable_libtorch — gecompileerd voor SM 12.1a (build_stable_ext.sh in de container v41build) |
| 2 | overlay1 | Basisimage + boom van de vLLM-branch (vllm/vllm/) + 2 .so-bestanden |
| 3 | overlay3 | FlashInfer 0.7.0rc1 (07869c61) gecompileerd |
| 4 | overlay4 | CUTLASS mxfp8_gemm_sm120 vooraf gebouwd (MAX_JOBS=4) |
| 5 | overlay5 | sparse_mla_sm120 vooraf gebouwd + verificatie (HIT/HIT) |
| 6 | patchlaag | 7 patchbestanden in de image ingebouwd + ENTRYPOINT [] toegevoegd |
Belangrijk: de Dockerfile moet
COPY vllm/vllm/gebruiken (nietvllm/) —vllm/is een git-repository, het Python-pakket staat ondervllm/vllm/.
4.3 Patches
De volgende 7 patches zijn in de image ingebouwd:
| # | Bestand | Mountpad | Functie |
|---|---|---|---|
| 1 | engram.py |
models/deepseek_v4_1/common/engram.py |
Engram-on-disk, correctie van de rank-offset |
| 2 | model_state.py |
models/deepseek_v4_1/nvidia/model_state.py |
Engram klaarzetten vóór de forward pass (veilig voor CUDA graphs) |
| 3 | weight_utils.py |
model_executor/model_loader/weight_utils.py |
Engram-tabellen overslaan bij het laden |
| 4 | attention.py |
models/deepseek_v4_1/attention.py |
Paginagroottes voor SM 12.1a |
| 5 | flashinfer_sparse.py |
models/deepseek_v4_1/nvidia/flashinfer_sparse.py |
Pagina’s met 64 toestanden |
| 6 | sparse_swa.py |
v1/attention/backends/mla/sparse_swa.py |
Hook voor de SWA-blokgrootte |
| 7 | sparse_attn_indexer.py |
model_executor/layers/sparse_attn_indexer.py |
top_k_per_row_decode voor SM 12.1a |
4.4 Optimalisaties
- OMP_NUM_THREADS=1 — toegevoegd aan de recipe (vermindert contentie door spin-wait)
- Buildartefacten opgeruimd — overlay1/3/4/5, basisimage en buildcache verwijderd (~258 GB teruggewonnen)
5. Configuratie
5.1 sparkrun-recipe
De sparkrun-recipe (deepseek-v41-flash-tp4.yaml) bevat de volgende parameters:
| Parameter | Waarde | Beschrijving |
|---|---|---|
tensor_parallel |
4 | 4 nodes × 1 GPU |
gpu_memory_utilization |
0.80 | 80% GMU |
max_model_len |
300000 | Context van 300K (onder 1M, beperkt door het geheugen) |
max_num_seqs |
8 | Maximaal 8 gelijktijdige sequenties |
max_num_batched_tokens |
8192 | Batchgrootte voor prefill |
block_size |
128 | Blokgrootte van de KV-cache |
distributed-executor-backend |
mp | Multiprocess-backend |
5.2 Configuratie van speculatieve decodering
{
  "method": "dspark",
  "num_speculative_tokens": 5,
  "draft_sample_method": "probabilistic",
  "rejection_sample_method": "block",
  "enable_adaptive_verification": false
}
Met een DSpark-diepte van k=5 worden bij elke decodestap 5 tokens vooruit voorspeld.
5.3 Configuratie van Engram-on-disk
DSV41_ENGRAM_DISK=1
DSV41_ENGRAM_DISK_THREADS=32
DSV41_ENGRAM_DISK_CHUNK=16
Engram-rijen worden op schijf opgeslagen, parallel ingelezen met 32 threads en in chunks van 16 in het GPU-geheugen klaargezet.
5.4 Startcommando
sparkrun run /home/nvidia/.cordatus-sparkrun/recipes/deepseek-v41-flash-tp4.yaml \
  --hosts 192.168.1.153,192.168.1.147,192.168.1.166,192.168.1.148 \
  --foreground
5.5 Serving-parameters
Het model wordt geserveerd met de thinking-modus uitgeschakeld ("thinking": false) en met ondersteuning voor tool calling en multimodaliteit (vision) ingeschakeld:
--default-chat-template-kwargs '{"thinking": false}'--tool-call-parser deepseek_v41 --enable-auto-tool-choice--reasoning-parser deepseek_v41--limit-mm-per-prompt '{"image":4}'--compilation-configmet CUDA graphs (modusFULL_AND_PIECEWISE)
6. Prestatieresultaten
6.1 Benchmarktabel
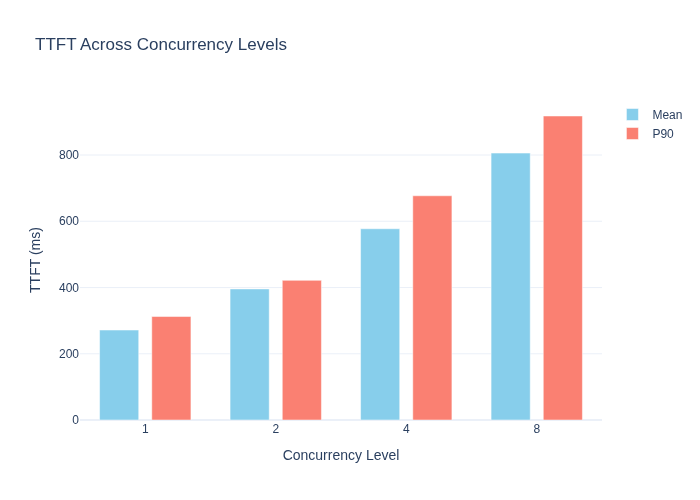
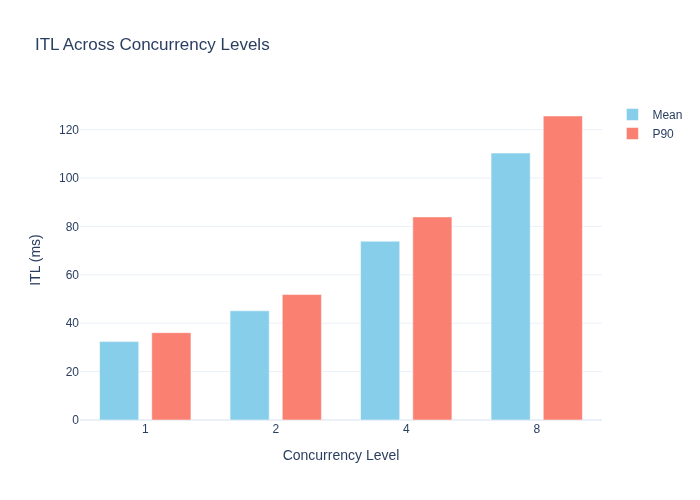
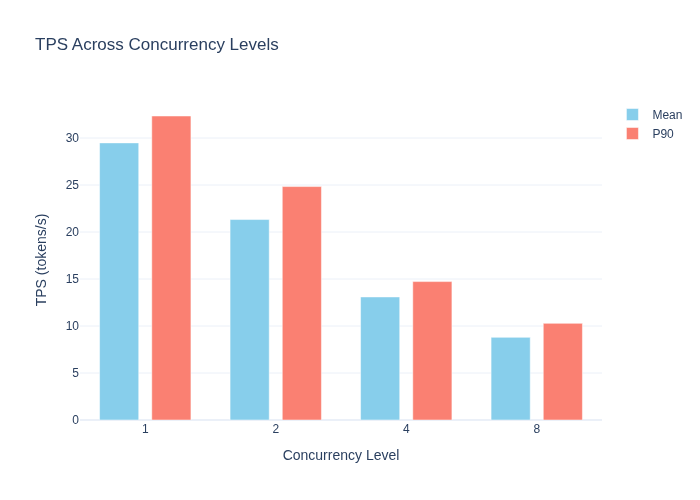
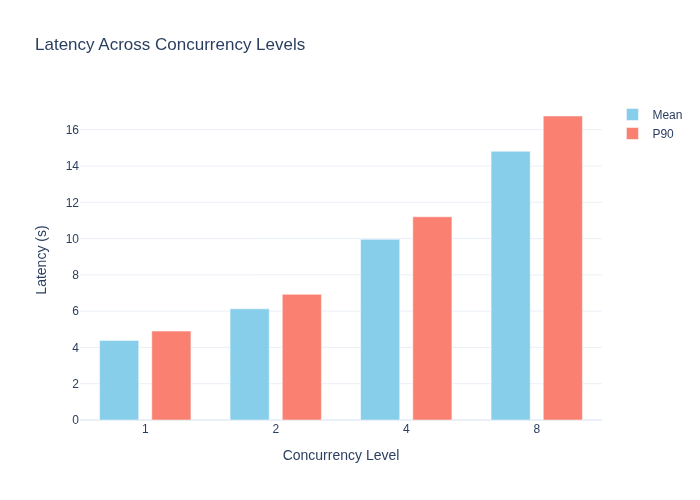
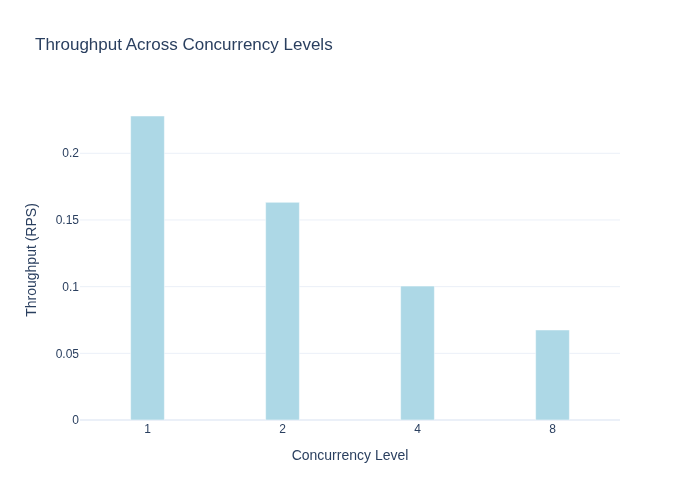
De metingen zijn uitgevoerd met CordatusAI/llm-benchmark (2e run, na JIT-opwarming).
| Gelijktijdigheid | TTFT (ms) | ITL (ms) | TPS (tok/s) | Latentie (s) | Doorvoer (RPS) |
|---|---|---|---|---|---|
| 1 | 271.63 | 32.39 | 29.48 | 4.39 | 0.23 |
| 2 | 395.75 | 45.12 | 21.32 | 6.13 | 0.16 |
| 4 | 577.41 | 73.86 | 13.09 | 9.96 | 0.10 |
| 8 | 805.89 | 110.28 | 8.79 | 14.81 | 0.07 |
6.2 Grafieken
6.3 Beoordeling
- 29.5 tok/s bij C=1 is voldoende voor interactief gebruik en ligt boven de drempel (threshold) voor leessnelheid (~15 tok/s).
- TTFT stijgt zoals verwacht naarmate de gelijktijdigheid (concurrency) toeneemt (272→806 ms, ~3x) — prefill is rekengebonden (compute-bound).
- De daling van TPS weerspiegelt de toenemende concurrentie om geheugenbandbreedte naarmate de GPU verzadiging nadert (29.5→8.8 tok/s, ~70% daling).
- Max C = 2 bij de standaarddoelen van de Benchmark Explorer (TTFT≤1000ms, TPS≥20) — chatcapaciteit 8, agentische capaciteit 3.
6.4 Acceptatie bij DSpark
De effectiviteit van speculatieve decodering met DSpark wordt gemeten aan de hand van de acceptatieverhouding en het draftpercentage:
| Type prompt | Gemiddelde acceptatie | Draftpercentage |
|---|---|---|
| Proza (bench) | 2.1–2.3 | 22% |
| Code | 4.9–5.3 | 80–86% |
De hoge acceptatie van DSpark k=5 bij codeprompts (4.9-5.3 / 5) komt doordat code meer gestructureerde, patroonmatige en voorspelbare tokenreeksen bevat, wat bijdraagt aan deze hoge acceptatieverhouding. Bij dit type antwoorden stijgt ook de TPS.
7. Vergelijkende analyse
7.1 Vergelijking met DGX-B300
DeepSeek-V4.1-Flash is in de LLM Inference Benchmark Explorer ook gemeten op zowel DGX-B300 (8× Blackwell Ultra, TP=4) als configuraties met 4× DGX Spark.
Deze resultaten mogen niet worden beoordeeld als een directe één-op-éénvergelijking van hardware. De parameters voor speculatieve decodering en de ondersteunde contextlengtes verschillen tussen de twee configuraties: de Spark-zijde gebruikt k=5 en een context van 300K, terwijl de B300-zijde k=3 en een context van 1M gebruikt. Het gemeten verschil in TPS weerspiegelt daarom het gecombineerde effect van hardware, geheugensysteem en configuratie van de inferentieserver.
| Gelijktijdigheid | TPS 4× Spark TP4 | TPS B300 TP4 | B300 / Spark |
|---|---|---|---|
| 1 | 29.48 | 284.54 | 9.65× |
| 2 | 21.32 | 294.56 | 13.82× |
| 4 | 13.09 | 252.60 | 19.30× |
| 8 | 8.79 | 209.41 | 23.83× |
In deze meetreeks leverde de B300-configuratie bij C=1 ongeveer 9.65× de geaggregeerde TPS van de Spark-configuratie, en bij C=8 ongeveer 23.83×.
De fundamentele verschillen op hardwareniveau zijn als volgt:
| Kenmerk | DGX-B300 | 4× DGX Spark |
|---|---|---|
| Geheugentype | HBM3e | LPDDR5X unified memory |
| Geheugenbandbreedte | Zeer hoog, klasse TB/s | ~273 GB/s / systeem |
| GPU-interconnect | Verbinding op basis van NVLink met hoge bandbreedte | 200 GbE RDMA |
| GPU-architectuur | Blackwell Ultra | GB10 |
| Schaaldoel | Datacenter / inferentie met hoge dichtheid | Desktop/edge en ontwikkeling |
Vooral bij grote MoE-modellen hebben niet alleen de totale geheugencapaciteit, maar ook de geheugenbandbreedte en de communicatiecapaciteit tussen GPU’s een aanzienlijke invloed op de prestaties. Dat het model op 4× DGX Spark kan draaien, betekent daarom niet dat hetzelfde model op DGX-B300 een vergelijkbaar doorvoerniveau zal bereiken.
Conclusie: 4× DGX Spark kan worden gebruikt om grootschalige MoE-modellen te draaien en kan worden overwogen voor ontwikkeling, prototyping, modelvalidatie en deploymentscenario’s met lage tot gemiddelde gelijktijdigheid. De gemeten doorvoerresultaten mogen echter niet worden opgevat als vervanging van systemen van datacenterklasse zoals DGX-B300. Deze twee platforms hebben verschillende gebruiksdoelen op het gebied van geheugenbandbreedte, interconnect en schaalcapaciteit.
8. SLO en capaciteit
Bij de standaarddoelen van de Benchmark Explorer (TTFT≤1000ms, TPS≥20 tok/s) levert deze configuratie Max C = 2 op:
| SLO | Drempel | Status bij C=2 |
|---|---|---|
| TTFT | ≤ 1000 ms | 396 ms ✓ |
| TPS | ≥ 20 tok/s | 21.32 tok/s ✓ |
Waarschuwing: bij C=4 daalt de TPS tot 13.09 en komt daarmee onder de drempel van 20 tok/s. Voor interactieve chatdiensten worden 1-2 gelijktijdige gebruikers aanbevolen; voor hogere belasting verdient datacenterhardware (B300/GB300) de voorkeur.
9. Conclusie
- DeepSeek-V4.1-Flash (763B) kan draaien op 4× DGX Spark — wat het plafond van de schaalbaarheid van kantoorvriendelijke mini-supercomputers laat zien.
- 7 patches voor SM 12.1a zijn verplicht — de standaard nightly-image van vLLM mist codepaden voor GB10 (SM 12.1a) in de paden voor Engram-on-disk, FlashInfer sparse attention en SWA.
- Engram-on-disk zorgt ervoor dat het model in het geheugen past — door de conditional memory van 196B naar schijf te offloaden, past het model van 763B binnen in totaal 512 GB unified memory.
- DSpark k=5 is effectief bij codeprompts, met een draftpercentage van 80-86%; bij prompts in natuurlijke taal in platte tekst/prozavorm daalt dit tot 22%.
- 29.5 tok/s bij C=1 is voldoende voor ontwikkeling en prototyping; voor serving in productie is hardware van B300-klasse ~10× sneller.
- Deze configuratie is een ontwikkelplatform, geen alternatief voor een datacenter. Dat een model van 763B op kantoorhardware kan draaien, laat de grenzen zien van deployment aan de edge en on-premises.
Bijlage A: Instructies voor het bouwen van de Docker-image
Deze bijlage bevat de volledige instructies om de image vllm-dsv41:latest vanaf nul te bouwen. Alle commando’s worden uitgevoerd op de head-node (192.168.1.153).
A.1 De repository klonen
cd /home/nvidia
git clone https://github.com/tonyd2wild/DeepSeek-V4.1-Flash-vLLM-DGX-Spark.git
cd DeepSeek-V4.1-Flash-vLLM-DGX-Spark
A.2 De vLLM-branch uitchecken
bash build/fetch_vllm_branch.sh /home/nvidia/vllm
# commit e47aa780b
rm -f vllm && cp -a /home/nvidia/vllm ./vllm
A.3 C-extensies bouwen
docker run -d --name v41build --gpus all --network host --entrypoint sleep \
  -v /tmp/v41build-src:/src vllm/vllm-openai:nightly-8a728663c1c3eeace834a95f5654fa653cc1998c 7200
docker exec v41build pip install cmake ninja -q
bash build/build_stable_ext.sh
docker cp v41build:/src/build/_C_stable_libtorch.abi3.so build/
docker cp v41build:/src/build/_moe_C_stable_libtorch.abi3.so build/
A.4 Overlayketen
# overlay1: base + vLLM tree + 2 .so files
docker build -t vllm-dsv41:overlay1 -f build/Dockerfile.overlay1 .

# overlay3: FlashInfer 0.7.0rc1
bash build/build_overlay3.sh

# overlay4: CUTLASS mxfp8_gemm_sm120
bash build/build_overlay4.sh

# overlay5: sparse_mla_sm120 + verify
cp build/prewarm5.py build/verify5.py /tmp/
bash build/build_overlay5.sh
A.5 Patchlaag
FROM vllm-dsv41:overlay5
COPY DeepSeek-V4.1-Flash-vLLM-DGX-Spark/patch/engram.py /usr/local/lib/python3.12/dist-packages/vllm/models/deepseek_v4_1/common/engram.py
COPY DeepSeek-V4.1-Flash-vLLM-DGX-Spark/patch/model_state.py /usr/local/lib/python3.12/dist-packages/vllm/models/deepseek_v4_1/nvidia/model_state.py
COPY DeepSeek-V4.1-Flash-vLLM-DGX-Spark/patch/weight_utils.py /usr/local/lib/python3.12/dist-packages/vllm/model_executor/model_loader/weight_utils.py
COPY DeepSeek-V4.1-Flash-vLLM-DGX-Spark/patch/attention.py /usr/local/lib/python3.12/dist-packages/vllm/models/deepseek_v4_1/attention.py
COPY DeepSeek-V4.1-Flash-vLLM-DGX-Spark/patch/flashinfer_sparse.py /usr/local/lib/python3.12/dist-packages/vllm/models/deepseek_v4_1/nvidia/flashinfer_sparse.py
COPY DeepSeek-V4.1-Flash-vLLM-DGX-Spark/patch/sparse_swa.py /usr/local/lib/python3.12/dist-packages/vllm/v1/attention/backends/mla/sparse_swa.py
COPY DeepSeek-V4.1-Flash-vLLM-DGX-Spark/patch/sparse_attn_indexer.py /usr/local/lib/python3.12/dist-packages/vllm/model_executor/layers/sparse_attn_indexer.py
ENTRYPOINT []
cd /home/nvidia && docker build -t vllm-dsv41:latest -f Dockerfile.patches .
A.6 Distributie naar de workers
sparkrun distribueert de image automatisch, maar als handmatige distributie nodig is:
docker save vllm-dsv41:latest | ssh nvidia@192.168.1.147 docker load
docker save vllm-dsv41:latest | ssh nvidia@192.168.1.166 docker load
docker save vllm-dsv41:latest | ssh nvidia@192.168.1.148 docker load
Bijlage B: Rijbereiken van Engram
In de modus Engram-on-disk houdt elke rank (node) verschillende rijbereiken op zijn lokale schijf:
| Rank | Node | Rijen laag 1 | Rijen laag 14 |
|---|---|---|---|
| 0 | 153 (head) | [0, 96000564) | [0, 96003054) |
| 1 | 147 | [96000564, 192001740) | [96003054, 192007016) |
| 2 | 166 | [192001740, 288003654) | [192007016, 288011564) |
| 3 | 148 | [288003654, 384006168) | [288011564, 384016682) |
In totaal ~384M rijen, gelijkmatig verdeeld over 4 ranks.
Bijlage C: Verificatiecommando’s
Statuscontrole van de API
curl http://192.168.1.153:8000/v1/models
Eenvoudige test
curl http://192.168.1.153:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"deepseek-v4.1-flash","max_tokens":50,
       "messages":[{"role":"user","content":"Count from 1 to 10."}]}'
Openzeka Teknoloji A.Ş. — openzeka.com · Tel: +90 312 266 2055
Üniversiteler Mah. Şehit Mustafa Tayyarcan Cad. Tepe Binası No:5 İç Kapı No:315, 06800 Çankaya/Ankara, Türkiye
Dit rapport is opgesteld op basis van metingen die zijn uitgevoerd met de tool CordatusAI/llm-benchmark. Deploymentrecipe aangepast op basis van de boot10-configuratie van tonyd2wild/DeepSeek-V4.1-Flash-vLLM-DGX-Spark. Rapportdatum: september 2026