Hazırlayan: Openzeka Teknoloji A.Ş. — NVIDIA Türkiye & MEA Resmî Embedded Compute Distribütörü ve NVIDIA Elite Partner
Test platformu: 4× NVIDIA DGX Spark (GB10) · Model: DeepSeek-V4.1-Flash (763B) · Rapor tarihi: Eylül 2026
İçindekiler
- 1. Giriş
- 2. Model Mimarisi
- 3. Donanım
- 4. vLLM Build ve Patch Zinciri
- 5. Yapılandırma
- 6. Performans Sonuçları
- 7. Karşılaştırmalı Analiz
- 8. SLO ve Kapasite
- 9. Sonuç
- Ek A: Docker Image Build Talimatları
- Ek B: Engram Row Range’leri
- Ek C: Doğrulama Komutları
1. Giriş
DeepSeek-V4.1-Flash, 552B omurga parametresine sahip çok modlu bir Mixture-of-Experts (MoE) modelidir.
Hugging Face checkpoint’i 763B parametre içerir: 552B omurga + 196B Engram koşullu bellek (modelin teknik raporuna göre) + ~15B görsel kodlayıcı, MLP projektörü ve DSpark draft modeli.
Model, MXFP8 dense + MXFP4 expert ağırlık nicelemesi ve FP4 (E2M1) KV önbelleği ile gelir ve 1M token’a kadar bağlam destekler.
Bu rapor, söz konusu modelin 4× NVIDIA DGX Spark (GB10) platformunda tensor-parallel (TP=4) dağıtımını anlatır.
DGX Spark, 128 GB birleşik LPDDR5X bellek ve 273 GB/s bant genişliği ile bir mini süper bilgisayardır. 763B’lik bir veri merkezi modelinin bu donanımda çalıştırılması, çoklu düğüm tensor parallelism ve özellikle Engram-on-disk tekniği sayesinde mümkün olmaktadır.
Bu çalışmayı belgelemeye değer kılan iki özellik:
- Model, veri merkezi sınıfında. DeepSeek-V4.1-Flash normalde DGX-B300 ve benzeri sınıfı donanımda servis edilir. 4× DGX Spark, mimarinin ölçeklenebilir ucunu temsil eder.
- 7 SM 12.1a’ya özgü patch. vLLM’in stock nightly imajında SM 12.1a (GB10) için eksik veya hatalı olan kod yolları — Engram-on-disk, FlashInfer sparse attention, SWA block size, attention page sizes — topluluk patch’leri ile düzeltilmiştir.
Bu çalışma bir dağıtım rehberidir, bir benchmark karşılaştırması değildir. Benchmark sonuçları Bölüm 6’da sunulmuştur.
2. Model Mimarisi
2.1 Genel Bakış
DeepSeek-V4.1-Flash, önceki nesillere kıyasla KV önbellek ayak izini dramatik biçimde küçülten bir mimari sunar. Önemli özellikler:
| Bileşen | Değer |
|---|---|
| Omurga parametreleri | 552B |
| Toplam checkpoint parametreleri | 763B (HF doğrulaması) |
| Prefill başına aktif parametre | 8B |
| Decode başına aktif parametre | 16B |
| Engram koşullu bellek | 196B (token tabanlı lookup ile seyrek erişim) |
| Paylaşılan expert / yönlendirilen expert | 1 / 384 (token başına 6 aktif) |
| Maksimum bağlam | 1.000.000 token |
| Ağırlık nicelemesi | MXFP8 dense + MXFP4 experts (block 32×32, ue8m0 scale) |
| KV önbellek nicelemesi | FP4 (E2M1, runtime — CSA2 mimari özelliği) |
| Checkpoint boyutu | 510 GB (48 safetensors dosyası — FP4 expert ağırlıkları ve karışık hassasiyet nedeniyle teorik 763 GB’ın altında) |
2.2 Causal Encoder-Decoder (CED) Mimarisi
Model, 40 katmanlı bir Transformer olup 20 katmanlı causal encoder + 20 katmanlı decoder olarak yapılandırılmıştır. CED’nin temel avantajı: decoder’ın global KV önbelleği, her decoder katmanının kendi hidden state’inden değil, encoder’ın son hidden state’inden türetilir. Bu, prefill sırasında yalnızca 8B parametre, decode sırasında 16B parametre aktive edilmesini sağlar — özellikle input-ağır agentic iş yükleri için maliyet verimliliği önemli.
SWA Bounded Replay, Sliding Window Attention (SWA) için gereken KV durumlarını kalıcı depolamada saklamak yerine, yalnızca en son n_win token’ı yeniden işleyerek eksik KV durumlarını yeniden oluşturur. Böylece SWA KV durumlarının kalıcı depolamaya aktarılmasına gerek kalmaz ve DeepSeek-V4-Flash’a kıyasla kalıcı KV önbelleğinin depolama ayak izi yaklaşık 1/8’e düşer.
2.3 Compressed Sparse Attention 2 (CSA2)
CSA2, her attention katmanına üç statik moddan birini atar: Full, Reindex veya Reuse. Bu modlar, ana KV ve indexer K’yı katmanlar arasında paylaşır ve Top-K sparse-attention indekslerini yeniden kullanır. Decoder’da, bir Hierarchical Sparse Indexer daha sonraki indeksleme katmanlarını ilk Full Mode katmanının oluşturduğu aday havuzuyla sınırlar; daha derin indeksleme maliyetini bağlam uzunluğundan bağımsız kılar.
FP4 ana KV önbelleği (E2M1 formatı, 16 kanal başına bir E4M3 ölçeği) ile birleştiğinde, global KV önbellek ayak izi token başına 890 byte‘a iner — DeepSeek-V4-Flash’ın yaklaşık 1/4’ü.
2.4 Engram Koşullu Bellek
196B parametrelik Engram katmanı, token tabanlı lookup ile seyrek erişilir. Bu çalışmada Engram-on-disk modu kullanılmıştır: Engram satırları GPU belleğinde değil, her düğümün yerel diskinde tutulur ve ihtiyaç duyulduğunda GPU belleğine stage’lenir. Bu, 763B’lik modelin 4× 128 GB (512 GB toplam) birleşik belleğe sığmasını sağlar.
Embedding arama mekanizması, bellek bütçesi ve taşıma sonuçlarının değerlendirmesi için LLM Çıkarımında Engram Offloading rehberine bakınız.
2.5 DSpark Speculative Decoding
DSpark, yarı-otoregresif draft üretimi ve güvenlik tabanlı doğrulama ile çalışan bir speculative decoding mekanizmasıdır. Bu çalışmada k=5 derinliği kullanılmıştır — her decode adımında 5 token önceden tahmin edilir ve doğrulanır. Doğrulanan token’lar çıktıya eklenir, reddedilenler yeniden üretilir.
3. Donanım
| Bileşen | Değer |
|---|---|
| GPU | Blackwell mimarisi (GB10), SM 12.1a (CC 12.1), 48 SM |
| GPU belleği | 128 GB unified LPDDR5X (CPU+GPU paylaşımlı) |
| Bellek bant genişliği | ~273 GB/s (unified) |
| FP4 tepe (seyreklik ile) | ~1 PFLOP |
| CPU | 20 çekirdekli Arm (10× Cortex-X925 + 10× Cortex-A725) |
| Node interconnect | NVIDIA ConnectX-7, 200 Gb/s RDMA (QSFP) |
| Depolama | 4× NVMe SSD (4× 4 TB, 4 düğüm genelinde) |
| Ağ topolojisi | 200 GbE switch (NVLink yok; all-reduce Ethernet üzerinden) |
Kritik mimari gerçek: DGX Spark’lar arasında NVLink yoktur. Bu çalışmadaki TP=4, ConnectX-7 200 GbE ağı üzerinden multi-node tensor parallelism‘dir — her all-reduce işlemi 200 GbE switch üzerinden Ethernet ağını geçer.
4. vLLM Build ve Patch Zinciri
vLLM’in stock nightly imajı, SM 12.1a (GB10) için DeepSeek-V4.1-Flash kod yollarında eksiklikler içerir. Bu bölüm, özel Docker imajı (vllm-dsv41:latest, 33.8 GB) oluşturmak için uygulanan build zincirini ve 7 patch’i belgeler.
4.1 Temel İmaj ve vLLM Branch
- Base image:
vllm/vllm-openai:nightly-8a728663c1c3eeace834a95f5654fa653cc1998c - vLLM branch:
build/fetch_vllm_branch.shile checkout edildi, commite47aa780b - Kaynak repo: tonyd2wild/DeepSeek-V4.1-Flash-vLLM-DGX-Spark (boot10 config)
4.2 Overlay Build Zinciri
Build, 5 overlay katmanı ve bir patch katmanından oluşur. Her overlay, bir öncekinin üzerine inşa eder:
| Adım | İsim | İçerik |
|---|---|---|
| 1 | C extension | _C_stable_libtorch + _moe_C_stable_libtorch — SM 12.1a için derlendi (build_stable_ext.sh ile v41build container’ında) |
| 2 | overlay1 | Base image + vLLM branch tree (vllm/vllm/) + 2 adet .so |
| 3 | overlay3 | FlashInfer 0.7.0rc1 (07869c61) derlendi |
| 4 | overlay4 | CUTLASS mxfp8_gemm_sm120 prebuilt (MAX_JOBS=4) |
| 5 | overlay5 | sparse_mla_sm120 prebuilt + verify (HIT/HIT) |
| 6 | patch layer | 7 patch dosyası image’a gömüldü + ENTRYPOINT [] eklendi |
Önemli not: Dockerfile’da
COPY vllm/vllm/(vllm/ değil, vllm/vllm/) kullanılmalıdır —vllm/bir git repo, Python packagevllm/vllm/altında bulunur.
4.3 Patch’ler
Aşağıdaki 7 patch, image’a gömülmüştür:
| # | Dosya | Mount yolu | İşlev |
|---|---|---|---|
| 1 | engram.py |
models/deepseek_v4_1/common/engram.py |
Engram-on-disk, rank-offset fix |
| 2 | model_state.py |
models/deepseek_v4_1/nvidia/model_state.py |
Engram staging before forward (CUDA graph safe) |
| 3 | weight_utils.py |
model_executor/model_loader/weight_utils.py |
Engram tablolarını load’ta skip |
| 4 | attention.py |
models/deepseek_v4_1/attention.py |
SM 12.1a page sizes |
| 5 | flashinfer_sparse.py |
models/deepseek_v4_1/nvidia/flashinfer_sparse.py |
64-state pages |
| 6 | sparse_swa.py |
v1/attention/backends/mla/sparse_swa.py |
SWA block size hook |
| 7 | sparse_attn_indexer.py |
model_executor/layers/sparse_attn_indexer.py |
SM 12.1a top_k_per_row_decode |
4.4 Optimizasyonlar
- OMP_NUM_THREADS=1 — reçeteye eklendi (spin-wait contention’ı azaltır)
- Build kalıntıları temizlendi — overlay1/3/4/5, base image, build cache silindi (~258 GB kazanç)
5. Yapılandırma
5.1 sparkrun Reçetesi
sparkrun reçetesi (deepseek-v41-flash-tp4.yaml) aşağıdaki parametreleri içerir:
| Parametre | Değer | Açıklama |
|---|---|---|
tensor_parallel |
4 | 4 düğüm × 1 GPU |
gpu_memory_utilization |
0.80 | %80 GMU |
max_model_len |
300000 | 300K bağlam (1M’in altında, bellek kısıtı) |
max_num_seqs |
8 | Maksimum 8 eşzamanlı dizi |
max_num_batched_tokens |
8192 | Prefill batch boyutu |
block_size |
128 | KV önbellek blok boyutu |
distributed-executor-backend |
mp | Multiprocess backend |
5.2 Speculative Decoding Yapılandırması
{
  "method": "dspark",
  "num_speculative_tokens": 5,
  "draft_sample_method": "probabilistic",
  "rejection_sample_method": "block",
  "enable_adaptive_verification": false
}
DSpark k=5 derinliği ile her decode adımında 5 token önceden tahmin edilir.
5.3 Engram-on-disk Yapılandırması
DSV41_ENGRAM_DISK=1
DSV41_ENGRAM_DISK_THREADS=32
DSV41_ENGRAM_DISK_CHUNK=16
Engram satırları diskte tutulur, 32 thread ile paralel okunur ve 16’lık chunk’lar halinde GPU belleğine stage’lenir.
5.4 Çalıştırma Komutu
sparkrun run /home/nvidia/.cordatus-sparkrun/recipes/deepseek-v41-flash-tp4.yaml \
  --hosts 192.168.1.153,192.168.1.147,192.168.1.166,192.168.1.148 \
  --foreground
5.5 Çalıştırma Parametreleri
Model, düşünme modu kapalı ("thinking": false), araç çağırma ve çok modlu (görüntü) desteği açık olarak servis edilir:
--default-chat-template-kwargs '{"thinking": false}'--tool-call-parser deepseek_v41 --enable-auto-tool-choice--reasoning-parser deepseek_v41--limit-mm-per-prompt '{"image":4}'--compilation-configile CUDA graphs (FULL_AND_PIECEWISEmodu)
6. Performans Sonuçları
6.1 Benchmark Tablosu
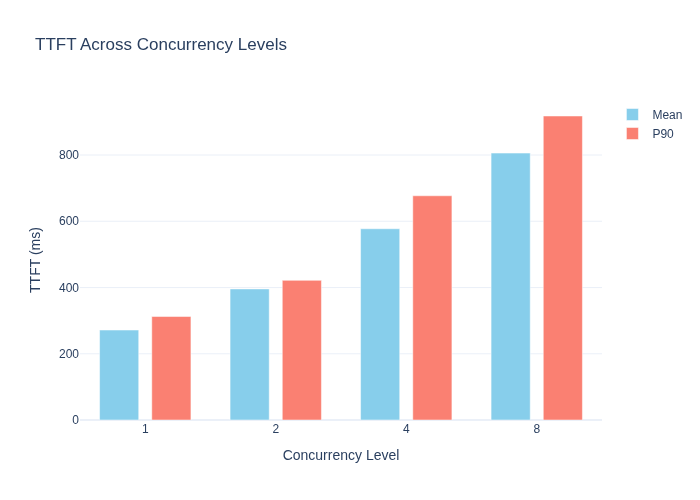
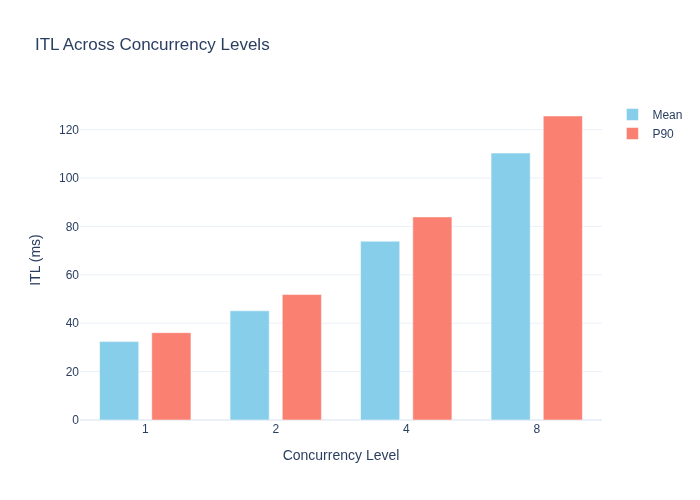
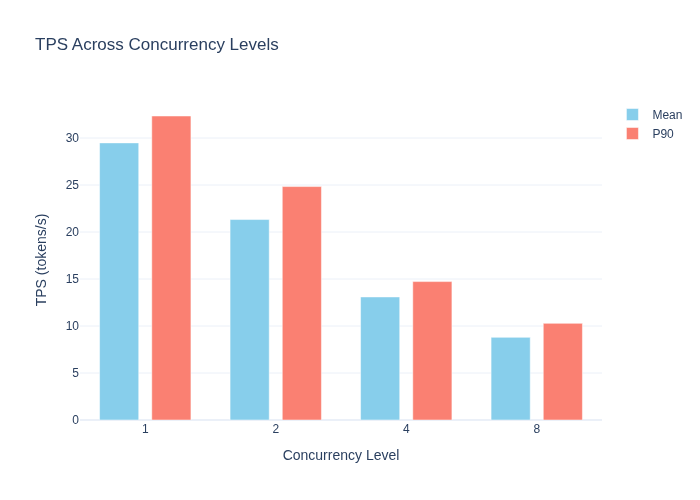
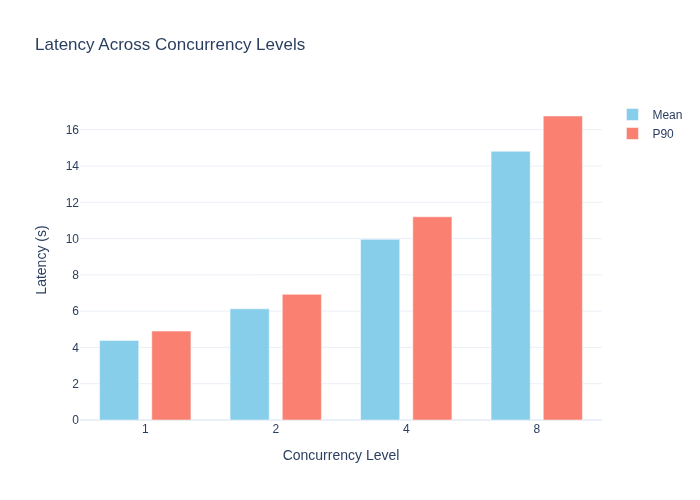
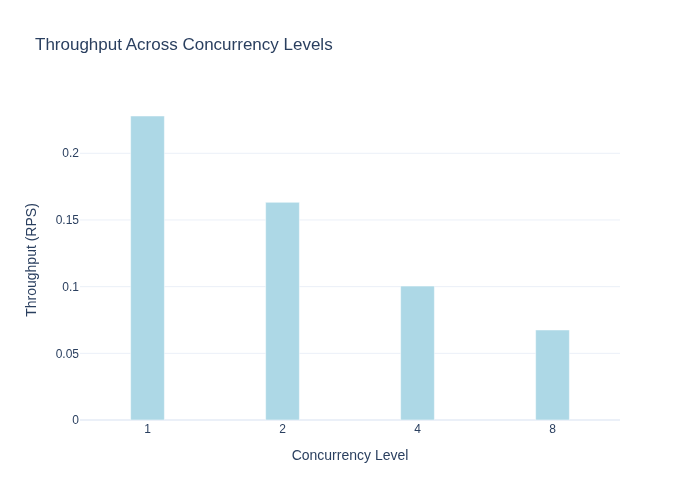
Ölçümler CordatusAI/llm-benchmark aracı ile alınmıştır (2. çalıştırma, JIT ısındıktan sonra).
| Concurrency | TTFT (ms) | ITL (ms) | TPS (tok/s) | Latency (s) | Throughput (RPS) |
|---|---|---|---|---|---|
| 1 | 271.63 | 32.39 | 29.48 | 4.39 | 0.23 |
| 2 | 395.75 | 45.12 | 21.32 | 6.13 | 0.16 |
| 4 | 577.41 | 73.86 | 13.09 | 9.96 | 0.10 |
| 8 | 805.89 | 110.28 | 8.79 | 14.81 | 0.07 |
6.2 Grafikler
6.3 Değerlendirme
- C=1’de 29.5 tok/s, interaktif kullanım için yeterli bir hıztır. Okuma hızı (~15 tok/s) eşiğinin üzerindedir.
- TTFT, concurrency artışıyla beklenen biçimde yükselir (272→806 ms, ~3x) — prefill aşaması hesaplama sınırlıdır (compute-bound).
- TPS düşüşü, GPU’nun doygunluğa yaklaşmasıyla bellek bant genişliği çekişmesinin artmasından kaynaklanır (29.5→8.8 tok/s, ~%70 düşüş).
- Max C = 2 (Benchmark Gezgini’nin varsayılan hedeflerinde: TTFT≤1000ms ve TPS≥20) — sohbet kapasitesi 8, agentic kapasite 3.
6.4 DSpark Acceptance
DSpark speculative decoding’in etkinliği, kabul oranı (acceptance) ve draft hızı (draft rate) ile ölçülür:
| Prompt tipi | Mean acceptance | Draft rate |
|---|---|---|
| Prose (bench) | 2.1–2.3 | %22 |
| Kodlama | 4.9–5.3 | %80–86 |
Kodlama prompt’larında DSpark k=5’in acceptance oranının yüksek olması (4.9-5.3 / 5), Kodun daha yapısal, kalıplı ve öngörülebilir token dizilerine sahip olması, bu yüksek kabul oranına katkıda bulunur. Bu tip cevaplarda tps değeride yükselir.
7. Karşılaştırmalı Analiz
7.1 DGX-B300 ile Karşılaştırma
DeepSeek-V4.1-Flash modeli, LLM Çıkarım Benchmark Gezgini üzerinde DGX-B300 (8× Blackwell Ultra, TP=4) ve 4× DGX Spark yapılandırmalarında da ölçülmüştür.
Bu sonuçlar doğrudan birebir donanım karşılaştırması olarak değerlendirilmemelidir. İki yapılandırmada speculative decoding parametreleri ve desteklenen context uzunluğu farklıdır: Spark tarafında k=5 ve 300K context, B300 tarafında ise k=3 ve 1M context kullanılmıştır. Bu nedenle ölçülen TPS farkı; donanım, bellek sistemi, inference server yapılandırmasının birlikte etkisini yansıtır.
| Concurrency | 4× Spark TP4 TPS | B300 TP4 TPS | B300 / Spark |
|---|---|---|---|
| 1 | 29.48 | 284.54 | 9.65× |
| 2 | 21.32 | 294.56 | 13.82× |
| 4 | 13.09 | 252.60 | 19.30× |
| 8 | 8.79 | 209.41 | 23.83× |
Bu ölçüm setinde B300 yapılandırması, C=1’de Spark yapılandırmasının yaklaşık 9.65 katı, C=8’de ise yaklaşık 23.83 katı aggregate TPS üretmiştir.
Donanım düzeyinde temel farklar şunlardır:
| Özellik | DGX-B300 | 4× DGX Spark |
|---|---|---|
| Bellek tipi | HBM3e | LPDDR5X unified memory |
| Bellek bant genişliği | Çok yüksek, TB/s sınıfı | ~273 GB/s / sistem |
| GPU interconnect | NVLink tabanlı yüksek bant genişlikli bağlantı | 200 GbE RDMA |
| GPU mimarisi | Blackwell Ultra | GB10 |
| Ölçekleme hedefi | Veri merkezi / yüksek yoğunluklu inference | Masaüstü/edge ve geliştirme |
Özellikle büyük MoE modellerinde yalnızca toplam bellek kapasitesi değil, bellek bant genişliği ve GPU’lar arası iletişim kapasitesi de performansı önemli ölçüde etkiler. Bu nedenle 4× DGX Spark üzerinde modelin çalıştırılabilmesi, aynı modelin DGX-B300 üzerinde benzer throughput seviyesine ulaşacağı anlamına gelmez.
Sonuç: 4× DGX Spark, büyük ölçekli MoE modellerini çalıştırmak için kullanılabilir ve geliştirme, prototipleme, model doğrulama ve düşük/orta concurrency gerektiren deployment senaryolarında değerlendirilebilir. Ancak ölçülen throughput sonuçları, DGX-B300 gibi veri merkezi sınıfı sistemlerin yerini tuttuğu şeklinde yorumlanmamalıdır. Bu iki platform, bellek bant genişliği, interconnect ve ölçekleme kapasitesi açısından farklı kullanım hedeflerine sahiptir.
8. SLO ve Kapasite
Benchmark Gezgini’nin varsayılan hedeflerinde (TTFT≤1000ms, TPS≥20 tok/s), bu yapılandırma Max C = 2 değerini verir:
| SLO | Eşik | C=2 durumu |
|---|---|---|
| TTFT | ≤ 1000 ms | 396 ms ✓ |
| TPS | ≥ 20 tok/s | 21.32 tok/s ✓ |
Uyarı: C=4’te TPS 13.09’a düşerek 20 tok/s eşiğinin altına iner. Bu nedenle interaktif sohbet servisleri için 1-2 eşzamanlı kullanıcı önerilir; daha yüksek yük için veri merkezi donanımı (B300/GB300) tercih edilmelidir.
9. Sonuç
- 763B’lik DeepSeek-V4.1-Flash, 4× DGX Spark üzerinde çalıştırılabilir — bu, ofis dostu mini süper bilgisayarların ulaştığı ölçeklenebilirliğin bir göstergesidir.
- 7 SM 12.1a patch’i zorunludur — stock vLLM nightly imajı, GB10 (SM 12.1a) için Engram-on-disk, FlashInfer sparse attention ve SWA kod yollarında eksiklikler içerir.
- Engram-on-disk, modelin belleğe sığmasını sağlar — 196B’lik koşullu bellek diske taşınarak 763B’lik modelin 512 GB toplam birleşik belleğe sığması mümkün olur.
- DSpark k=5, kodlama prompt’larında %80-86 draft hızı ile etkindir; doğal dilde yazılmış, düz metin/nesir biçimindeki prompt’larında bu oran %22’ye düşer.
- C=1’de 29.5 tok/s, geliştirme ve prototipleme için yeterlidir; production servis için B300 sınıfı donanım ~10× daha hızlıdır.
- Bu yapılandırma bir veri merkezi alternatifi değil, bir geliştirme platformudur. 763B’lik bir modelin ofis donanımında çalışabilmesi, edge ve on-premises deployment senaryolarının sınırlarını gösterir.
Ek A: Docker Image Build Talimatları
Bu ek, vllm-dsv41:latest imajını sıfırdan build etmek için tam talimatları içerir. Tüm komutlar head node’da (192.168.1.153) çalıştırılır.
A.1 Repo Klonlama
cd /home/nvidia
git clone https://github.com/tonyd2wild/DeepSeek-V4.1-Flash-vLLM-DGX-Spark.git
cd DeepSeek-V4.1-Flash-vLLM-DGX-Spark
A.2 vLLM Branch Checkout
bash build/fetch_vllm_branch.sh /home/nvidia/vllm
# commit e47aa780b
rm -f vllm && cp -a /home/nvidia/vllm ./vllm
A.3 C Extension Build
docker run -d --name v41build --gpus all --network host --entrypoint sleep \
  -v /tmp/v41build-src:/src vllm/vllm-openai:nightly-8a728663c1c3eeace834a95f5654fa653cc1998c 7200
docker exec v41build pip install cmake ninja -q
bash build/build_stable_ext.sh
docker cp v41build:/src/build/_C_stable_libtorch.abi3.so build/
docker cp v41build:/src/build/_moe_C_stable_libtorch.abi3.so build/
A.4 Overlay Zinciri
# overlay1: base + vLLM tree + 2 .so
docker build -t vllm-dsv41:overlay1 -f build/Dockerfile.overlay1 .

# overlay3: FlashInfer 0.7.0rc1
bash build/build_overlay3.sh

# overlay4: CUTLASS mxfp8_gemm_sm120
bash build/build_overlay4.sh

# overlay5: sparse_mla_sm120 + verify
cp build/prewarm5.py build/verify5.py /tmp/
bash build/build_overlay5.sh
A.5 Patch Layer
FROM vllm-dsv41:overlay5
COPY DeepSeek-V4.1-Flash-vLLM-DGX-Spark/patch/engram.py /usr/local/lib/python3.12/dist-packages/vllm/models/deepseek_v4_1/common/engram.py
COPY DeepSeek-V4.1-Flash-vLLM-DGX-Spark/patch/model_state.py /usr/local/lib/python3.12/dist-packages/vllm/models/deepseek_v4_1/nvidia/model_state.py
COPY DeepSeek-V4.1-Flash-vLLM-DGX-Spark/patch/weight_utils.py /usr/local/lib/python3.12/dist-packages/vllm/model_executor/model_loader/weight_utils.py
COPY DeepSeek-V4.1-Flash-vLLM-DGX-Spark/patch/attention.py /usr/local/lib/python3.12/dist-packages/vllm/models/deepseek_v4_1/attention.py
COPY DeepSeek-V4.1-Flash-vLLM-DGX-Spark/patch/flashinfer_sparse.py /usr/local/lib/python3.12/dist-packages/vllm/models/deepseek_v4_1/nvidia/flashinfer_sparse.py
COPY DeepSeek-V4.1-Flash-vLLM-DGX-Spark/patch/sparse_swa.py /usr/local/lib/python3.12/dist-packages/vllm/v1/attention/backends/mla/sparse_swa.py
COPY DeepSeek-V4.1-Flash-vLLM-DGX-Spark/patch/sparse_attn_indexer.py /usr/local/lib/python3.12/dist-packages/vllm/model_executor/layers/sparse_attn_indexer.py
ENTRYPOINT []
cd /home/nvidia && docker build -t vllm-dsv41:latest -f Dockerfile.patches .
A.6 Worker Dağıtımı
sparkrun imajı otomatik dağıtır, ancak manuel gerekirse:
docker save vllm-dsv41:latest | ssh nvidia@192.168.1.147 docker load
docker save vllm-dsv41:latest | ssh nvidia@192.168.1.166 docker load
docker save vllm-dsv41:latest | ssh nvidia@192.168.1.148 docker load
Ek B: Engram Row Range’leri
Engram-on-disk modunda, her rank (düğüm) farklı satır aralıklarını diskte tutar:
| Rank | Node | Layer 1 Rows | Layer 14 Rows |
|---|---|---|---|
| 0 | 153 (head) | [0, 96000564) | [0, 96003054) |
| 1 | 147 | [96000564, 192001740) | [96003054, 192007016) |
| 2 | 166 | [192001740, 288003654) | [192007016, 288011564) |
| 3 | 148 | [288003654, 384006168) | [288011564, 384016682) |
Toplam ~384M satır, 4 rank’a eşit bölünmüştür.
Ek C: Doğrulama Komutları
API Sağlığı
curl http://192.168.1.153:8000/v1/models
Basit Test
curl http://192.168.1.153:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"deepseek-v4.1-flash","max_tokens":50,
       "messages":[{"role":"user","content":"Count from 1 to 10."}]}'
Openzeka Teknoloji A.Ş. — openzeka.com · Tel: +90 312 266 2055
Üniversiteler Mah. Şehit Mustafa Tayyarcan Cad. Tepe Binası No:5 İç Kapı No:315, 06800 Çankaya/Ankara, Türkiye
Bu rapor CordatusAI/llm-benchmark aracı ile üretilen ölçümlerden oluşturulmuştur. Dağıtım reçetesi tonyd2wild/DeepSeek-V4.1-Flash-vLLM-DGX-Spark boot10 config’inden uyarlanmıştır. Rapor tarihi: Eylül 2026