Opgesteld door: Openzeka Teknoloji A.Ş. — officiële Embedded Compute-distributeur van NVIDIA voor Türkiye & MEA, en NVIDIA Elite Partner
Testplatform: NVIDIA DGX-B300 (8× Blackwell Ultra, TP=8) · Model: Moonshot AI Kimi K3 · Rapportdatum: juli 2026
Inhoud
- 1. Managementsamenvatting
- 2. Testopstelling en methodologie
- 3. Deploymentconfiguraties
- 4. Resultaten
- 4.1 Algemene vergelijking (c=1 en c=64)
- 4.2 TTFT (Time To First Token)
- 4.3 ITL (Inter-Token Latency)
- 4.4 TPS (tokens per seconde per gebruiker)
- 4.5 Latentie (totale duur van een verzoek)
- 4.6 Doorvoer (RPS)
- 4.7 Totaal aantal geproduceerde tokens / seconde (totale output)
- 4.8 Analyse van de speculatieve versnelling
- 5. SLO- en relatieve capaciteitsanalyse
- 6. Vergelijkingskader en interpretatiegids
- 7. Conclusie
- Bijlage A: alle CSV-gegevens
- Bijlage B: vergelijkingsgrafieken
1. Managementsamenvatting
Dit rapport vergelijkt vier verschillende deploymentconfiguraties van het Kimi K3-model op dezelfde hardware (DGX-B300, TP8): vLLM (direct), vLLM + DSpark speculative, SGLang (direct) en SGLang + DSpark speculative.
Belangrijkste bevindingen
-
Bij lage belasting (c=1) levert speculatieve decodering (speculative decoding) een duidelijke winst op: vLLM + Spec is 1.86x sneller dan vLLM direct (188 versus 101 tok/s). SGLang + Spec is 1.56x sneller (130 versus 83 tok/s).
-
Bij hoge belasting wordt speculatieve decodering een knelpunt: vLLM + Spec @c=64: TPS per gebruiker daalt tot 11 tok/s (vLLM direct 27 tok/s). Break-evenpunt: ~c16 voor vLLM, ~c4 voor SGLang.
-
Ondanks het probleem met de hogere TTFT van SGLang direct levert het bij hoge belasting (c=64) een vergelijkbare totale output (1863 versus 1759 tok/s).
-
vLLM direct is de betrouwbaarste keuze voor algemeen gebruik: snel bij lage belasting (66ms TTFT), schaalt lineair bij hoge belasting en voldoet volledig aan de P90-SLO tot c=32 (bij c=64 overschrijdt het de TTFT slechts licht: 1107ms).
-
SGLang + Spec vertoont een ernstige anomalie: bij c=64 schiet de TTFT omhoog naar 4752ms (was 777ms bij c=32) — de scheduler bezwijkt onder extreme belasting.
Aanbeveling per scenario
| Scenario | Aanbevolen configuratie | Motivering |
|---|---|---|
| Interactieve chat bij lage belasting (c<=8) | vLLM + Spec | 1.4-1.9x hogere TPS per gebruiker |
| Productie / serving bij hoge belasting (c>16) | vLLM (direct) | Schaalbaar, voldoet aan SLO, stabiel |
| Maximale totale doorvoer | vLLM (direct) of SGLang (direct) | c=64: ~1759 / 1863 tok/s totaal |
| Minimale ITL (realtime) | vLLM + Spec (alleen c<=4) | ITL 4.8ms (direct 9.5ms) |
| Workloads met veel lange context | (buiten de scope van dit rapport) | De test met 128/128 tokens is beperkt |
2. Testopstelling en methodologie
2.1 Over het model
Kimi K3 is een open-weight, native multimodaal en agentisch model, ontwikkeld door Moonshot AI. Dit model met 2.8T parameters is gebouwd op de architecturen Kimi Delta Attention (KDA) en Attention Residuals (AttnRes) en heeft een contextvenster (context window) van 1M tokens. Als ‘s werelds eerste open model in de 3T-klasse is het ontworpen voor coderen over een lange horizon, kenniswerk en redeneren.
- Modelpagina: huggingface.co/moonshotai/Kimi-K3
Belangrijkste kenmerken
- Nieuwe architectuur: gebouwd op KDA + AttnRes, met het Stable LatentMoE-framework dat 16 van de 896 experts activeert — ~2.5x schalingsefficiëntie ten opzichte van Kimi K2.
- Coderen over een lange horizon: houdt lange engineeringsessies vol met minimaal menselijk toezicht; optimalisatie van GPU-kernels, compilerontwikkeling, CAD en chipontwerp.
- Agentisch kenniswerk: levert diepgaand onderzoek, interactieve visualisaties, widgets, dashboards en motion design.
- Native multimodaliteit en lange context: begrijpt tekst, beeld en video binnen hetzelfde model; ondersteunt een contextvenster van 1M tokens.
- Open frontier-gewichten: de volledige modelgewichten (weights) zijn vrijgegeven onder de Kimi K3 License.
Modeloverzicht
| Eigenschap | Waarde |
|---|---|
| Architectuur | Mixture-of-Experts (MoE) |
| Totaal aantal parameters | 2.8T |
| Actieve parameters | 104B |
| Aantal lagen | 93 |
| Aantal dense lagen | 1 |
| Samenstelling attention-lagen | 69 KDA + 24 Gated MLA |
| Verborgen dimensie attention | 7168 |
| Aantal attention-heads | 96 |
| Latent MoE-dimensie | 3584 |
| Verborgen MoE-dimensie (per expert) | 3072 |
| Aantal experts | 896 |
| Geselecteerde experts per token | 16 |
| Aantal gedeelde experts | 2 |
| Vocabulairegrootte | 160K |
| Contextlengte | 1,048,576 (1M tokens) |
| Attention-mechanisme | KDA & Gated MLA |
| Activatiefunctie | SiTU-GLU |
| Vision-encoder | MoonViT-V2 |
| Parameters vision-encoder | 401M |
| Kwantisatie | MXFP4-gewichten / MXFP8-activaties (quantization-aware training) |
| Modaliteit | Tekst, beeld |
Het model is uitgerold met --max-model-len 1048576, dus met de volledige 1M-contextcapaciteit actief.
2.2 Kwantisatie en licentie
Native MXFP4-kwantisatie (quantization): Kimi K3 past quantization-aware training toe vanaf de SFT-fase. Het gebruikt MXFP4-gewichten met MXFP8-activaties — dit biedt brede hardwarecompatibiliteit en beperkt het nauwkeurigheidsverlies tot een minimum, terwijl de omvang van de gewichten afneemt.
Licentie: de coderepository en de modelgewichten zijn vrijgegeven onder de Kimi K3 License.
2.3 Hardware en deployment
- GPU: NVIDIA DGX-B300 (Blackwell Ultra, 8x GPU)
- Parallellisme: Tensor Parallel = 8 (TP8)
- KV-cache: FP8 (
--kv-cache-dtype fp8) - Geheugenbenutting: 0.95
- Prefix caching: ingeschakeld (
--enable-prefix-caching)
2.4 Benchmarktool
CordatusAI/llm-benchmark — een interactieve tool op basis van Streamlit die OpenAI-compatibele API’s test.
2.5 Testparameters
| Parameter | Waarde | Beschrijving |
|---|---|---|
| Input-tokens | ~128 | per prompt |
| Output-tokens | 128 | max_tokens=128 |
| Gelijktijdigheid | 1, 2, 4, 8, 16, 32, 64 | gelijktijdige verzoeken |
| Min. rondes / gelijktijdigheid | 10 | minimaal aantal herhalingen per niveau |
| Totaal aantal verzoeken / niveau | 10 x c | c=64 -> 640 verzoeken |
| Warm-up | 1 verzoek | stabilisatie vóór de meting |
Belangrijk: input en output liggen vast op 128 tokens. Dit is bedoeld voor relatieve vergelijking; het is niet representatief voor echte productieworkloads (variabele lengte, meerdere beurten, lange context). Zie Sectie 6 voor details.
2.6 Metrieken
| Metriek | Eenheid | Definitie |
|---|---|---|
| TTFT | ms | Time To First Token — de tijd tot het eerste token is geproduceerd |
| ITL | ms | Inter-Token Latency — gemiddelde tijd tussen opeenvolgende tokens |
| TPS | tok/s | Tokens per seconde per gebruiker — outputsnelheid van één verzoek |
| Latentie | s | Totale duur van een verzoek (end-to-end) |
| Doorvoer | RPS | Voltooide verzoeken per seconde per systeem |
Elke metriek wordt gerapporteerd als gemiddelde (mean), P50 (mediaan) en P90.
2.7 SLO-drempels (standaardwaarden)
| SLO | Drempel | Onderbouwing |
|---|---|---|
| TTFT | <= 1000 ms | Nielsens grens voor de “gedachtestroom” (1s) |
| TPS | >= 15 tok/s | Grens van de menselijke visuele leessnelheid (~700 wpm) |
2.8 Capaciteitsplanning (de wet van Little)
Bepaal de maximale gelijktijdigheid (concurrency) die aan de SLO voldoet (C_max), en daarna het totale aantal gebruikers:
N = C_max x (1 + T_think / L_mean)
T_think = 45s(standaard: lezen + prompt schrijven)L_mean= gemiddelde latentie (latency) op het C_max-niveau
Belangrijk: deze getallen dienen voor relatieve vergelijking, niet als absolute productieramingen. Ze zijn gebaseerd op de workload van 128/128 tokens en een aangenomen denktijd (think time) van 45s.
3. Deploymentconfiguraties
3.1 Overzicht
In dit rapport worden vier deploymentconfiguraties vergeleken:
| Configuratie | Engine | Speculatief | Draftmodel | Bron draftmodel |
|---|---|---|---|---|
| vLLM (direct) | vLLM (kimi-k3 docker) | Nee | - | - |
| vLLM + Spec | vLLM (kimi-k3 docker) | DSpark | Inferact/Kimi-K3-DSpark |
vLLM recipes |
| SGLang (direct) | SGLang (kimi-k3 docker) | Nee | - | - |
| SGLang + Spec | SGLang (kimi-k3 docker) | DSpark | RadixArk/Kimi-K3-DSpark |
SGLang cookbook |
Belangrijke opmerking: vLLM en SGLang raden in hun officiële recipes/cookbooks twee verschillende draftmodellen aan. In deze benchmark gebruikte elke engine zijn eigen aanbevolen draftmodel — vLLM+Spec draaide dus met
Inferact/Kimi-K3-DSparken SGLang+Spec metRadixArk/Kimi-K3-DSpark. Dit weerspiegelt de optimale configuratie die de maker van elke engine aanbeveelt.
3.2 Over speculatieve decodering (DSpark)
DSpark is een methode voor speculatieve decodering op basis van een draftmodel, gespecialiseerd voor Kimi K3:
- Per stap worden ~7 tokenvoorstellen gegenereerd (
num_speculative_tokens=7) - Verificatie via rejection sampling (blokmethode)
- Bij lage belasting: decodesnelheid tot 2x (profiteert van de overdracht van de KV-cache)
- Bij hoge belasting: draftmodel + verificatie-overhead zetten de scheduler onder druk
Beide engines gebruiken de DSpark-methode, maar met verschillende gewichten voor het draftmodel. Deze draftmodellen zijn kleine modellen die specifiek voor Kimi K3 zijn getraind en zijn aangepast aan de eigen optimalisatiepijplijn van elke engine.
3.3 Docker-commando’s (volledig)
De volgende commando’s zijn overgenomen uit de officiële Kimi K3-recipes van vLLM en SGLang:
- vLLM: recipes.vllm.ai/moonshotai/Kimi-K3
- SGLang: docs.sglang.io/cookbook/autoregressive/Moonshotai/Kimi-K3
3.3.1 vLLM (direct — zonder speculatie)
docker run --gpus all \
  --privileged --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENABLE_K3_LATENT_MOE_TAIL_FUSION=1 \
  -e VLLM_ALLREDUCE_USE_FLASHINFER=1 \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  -e VLLM_USE_V2_MODEL_RUNNER=1 \
  -e VLLM_USE_RUST_FRONTEND=1 \
  vllm/vllm-openai:kimi-k3 moonshotai/Kimi-K3 \
  --trust-remote-code \
  --load-format fastsafetensors \
  --moe-backend auto \
  --gpu-memory-utilization 0.95 \
  --tensor-parallel-size 8 \
  --max-model-len 1048576 \
  --kv-cache-dtype fp8 \
  --attention-config '{"mla_prefill_backend":"TRTLLM_RAGGED","use_prefill_query_quantization":true}' \
  --enable-prefix-caching \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3
3.3.2 vLLM + speculative (DSpark)
docker run --gpus all \
  --privileged --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENABLE_K3_LATENT_MOE_TAIL_FUSION=1 \
  -e VLLM_ALLREDUCE_USE_FLASHINFER=1 \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  -e VLLM_USE_V2_MODEL_RUNNER=1 \
  -e VLLM_USE_RUST_FRONTEND=1 \
  vllm/vllm-openai:kimi-k3 moonshotai/Kimi-K3 \
  --trust-remote-code \
  --load-format fastsafetensors \
  --moe-backend auto \
  --gpu-memory-utilization 0.95 \
  --tensor-parallel-size 8 \
  --max-model-len 1048576 \
  --kv-cache-dtype fp8 \
  --attention-config '{"mla_prefill_backend":"TRTLLM_RAGGED","use_prefill_query_quantization":true}' \
  --enable-prefix-caching \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3 \
  --max-num-seqs 32 \
  --speculative-config '{"model":"Inferact/Kimi-K3-DSpark", "num_speculative_tokens":7, "method": "dspark", "attention_backend": "FLASHINFER_MLA", "draft_sample_method": "probabilistic", "rejection_sample_method": "block"}'
3.3.3 SGLang (direct — zonder speculatie)
docker run --gpus all \
  --shm-size 32g \
  -p 30000:30000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  --env "HF_TOKEN=<your-hf-token>" \
  --ipc=host \
  lmsysorg/sglang:kimi-k3 \
  sglang serve \
    --trust-remote-code \
    --model-path moonshotai/Kimi-K3 \
    --tp-size 8 \
    --mem-fraction-static 0.85 \
    --reasoning-parser kimi_k3 \
    --tool-call-parser kimi_k3 \
    --mamba-full-memory-ratio 0.9 \
    --host 0.0.0.0 \
    --port 30000
3.3.4 SGLang + speculative (DSpark)
docker run --gpus all \
  --shm-size 32g \
  -p 30000:30000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  --env "HF_TOKEN=<your-hf-token>" \
  --ipc=host \
  lmsysorg/sglang:kimi-k3 \
  sglang serve \
    --trust-remote-code \
    --model-path moonshotai/Kimi-K3 \
    --tp-size 8 \
    --mem-fraction-static 0.85 \
    --reasoning-parser kimi_k3 \
    --tool-call-parser kimi_k3 \
    --mamba-full-memory-ratio 0.86 \
    --host 0.0.0.0 \
    --port 30000 \
    --speculative-algorithm DSPARK \
    --speculative-draft-model-path RadixArk/Kimi-K3-DSpark \
    --speculative-dspark-block-size 7 \
    --enable-linear-replayssm-spec
3.4 Verschillen in configuratie
De belangrijkste configuratieverschillen tussen de twee engines:
| Kenmerk | vLLM | SGLang |
|---|---|---|
| Poort | 8000 | 30000 |
| Geheugenbenutting | 0.95 (--gpu-memory-utilization) |
0.85 (--mem-fraction-static) |
| KV-cache | FP8 (--kv-cache-dtype fp8) |
(standaard) |
| Prefill-backend | TRTLLM_RAGGED + query-kwantisatie |
FlashInfer MLA (standaard) |
| Rust-frontend | Ingeschakeld (VLLM_USE_RUST_FRONTEND=1) |
- |
| Spec-blokgrootte | (in de config) | --speculative-dspark-block-size 7 |
| Mamba full memory ratio | - | 0.9 (direct), 0.86 (spec) |
Belangrijk: de optimalisatie
TRTLLM_RAGGED+use_prefill_query_quantizationvan vLLM speelt een belangrijke rol in de lage TTFT van vLLM in deze benchmark (zie Sectie 4.2).
4. Resultaten
4.1 Algemene vergelijking (c=1 en c=64)
Lage belasting (c=1) — één gebruiker
| Metriek | vLLM dir | vLLM spec | sglang dir | sglang spec |
|---|---|---|---|---|
| TTFT gemiddeld (ms) | 66.5 | 71.0 | 399.5 | 450.6 |
| ITL gemiddeld (ms) | 9.46 | 4.84 | 8.94 | 4.26 |
| TPS gemiddeld (tok/s) | 100.8 | 187.7 | 83.4 | 129.9 |
| Latentie gemiddeld (s) | 1.27 | 0.69 | 1.54 | 0.99 |
| Spec/direct | 1.0x | 1.86x | 1.0x | 1.56x |
Hoge belasting (c=64) — 64 gelijktijdige gebruikers
| Metriek | vLLM dir | vLLM spec | sglang dir | sglang spec |
|---|---|---|---|---|
| TTFT gemiddeld (ms) | 731.7 | 1030.9 | 948.4 | 4752.6 |
| ITL gemiddeld (ms) | 30.8 | 95.4 | 27.1 | 34.4 |
| TPS gemiddeld (tok/s) | 27.5 | 11.2 | 29.1 | 14.5 |
| Latentie gemiddeld (s) | 4.66 | 13.15 | 4.41 | 9.13 |
| Totaal (tok/s) | 1759 | 717 | 1863 | 931 |
Opmerking: in de gegevens van sglang-spec @c=64 is er een inconsistentie tussen TTFT (4752ms) en latentie (9.13s) (TTFT zou > latentie/2 moeten zijn); dit is een meetanomalie in de ruwe gegevens.
4.2 TTFT (Time To First Token)
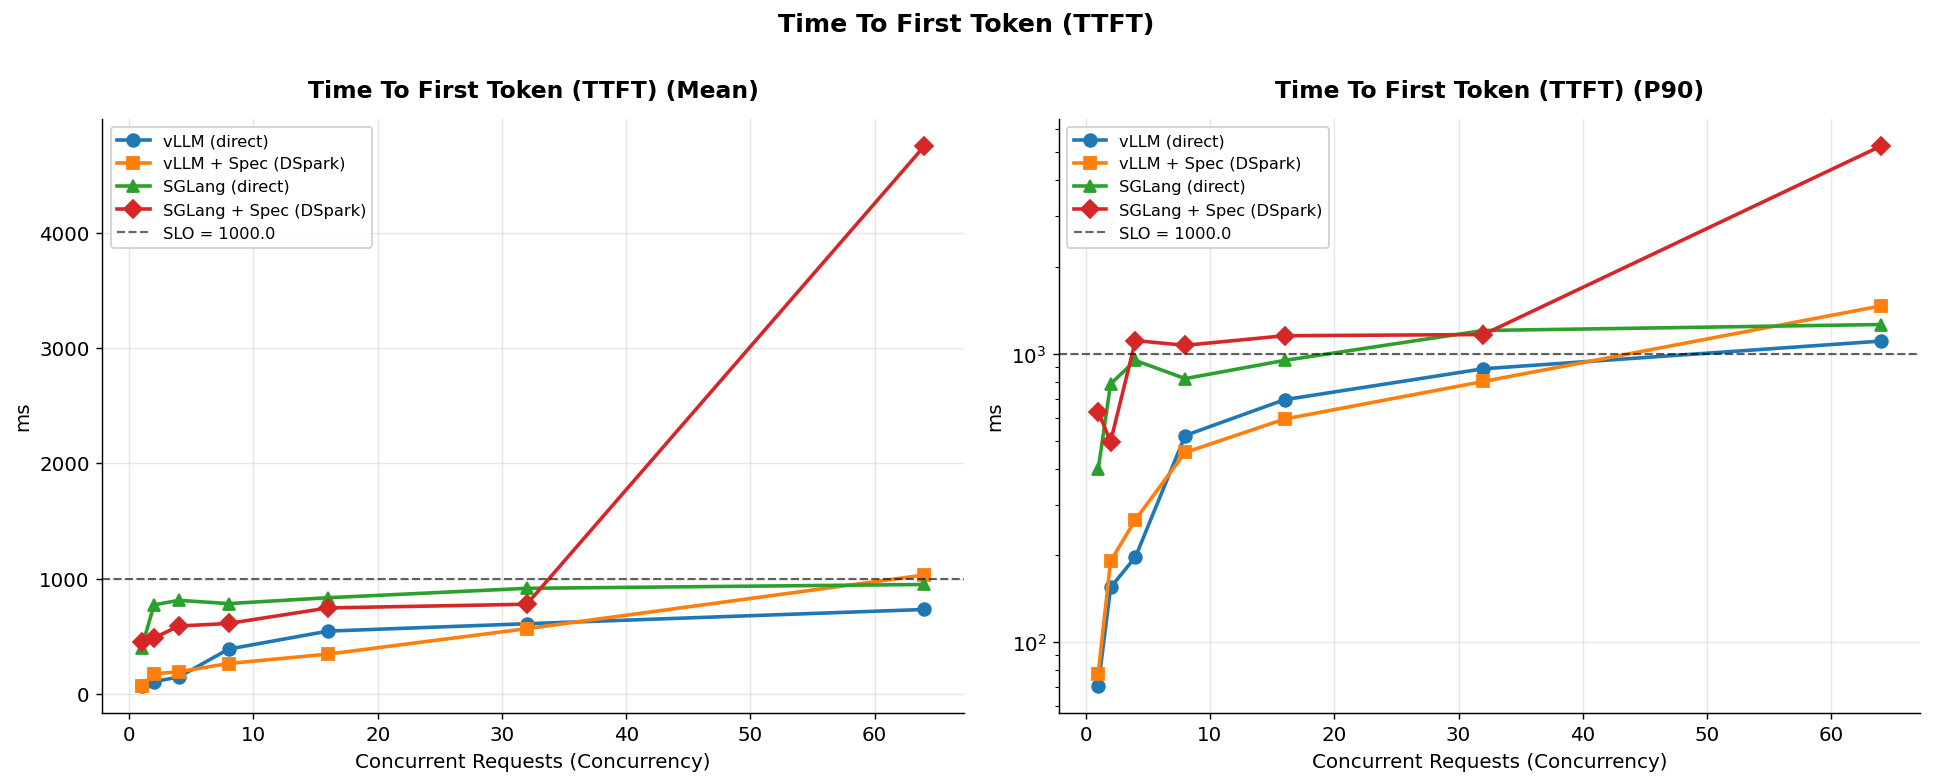
Bevindingen:
- vLLM direct heeft de snelste TTFT op alle belastingsniveaus (c=1: 66ms, c=64: 732ms).
- SGLang direct heeft een hoge TTFT (~400ms bij c=1) — 6x die van vLLM. De oorzaak is de configuratie
van de prefill-kernel van SGLang; vLLM gebruikt
TRTLLM_RAGGED+ query-kwantisatie, terwijl SGLang de standaard FlashInfer MLA gebruikt. - Speculatieve decodering verslechtert de TTFT (initialisatiekosten van het draftmodel):
- vLLM: 66 -> 71ms bij c=1 (+8%)
- SGLang: 400 -> 451ms bij c=1 (+13%)
- Anomalie bij SGLang + Spec @c=64: 4752ms — 6.1x slechter dan bij c=32. De scheduler wordt onder extreme belasting een knelpunt.
- De SLO-drempel (1000ms) voor P90: vLLM direct overschrijdt de SLO bij c=64 licht met 1107ms; de andere configuraties komen niet verder dan c=32.
4.3 ITL (Inter-Token Latency)
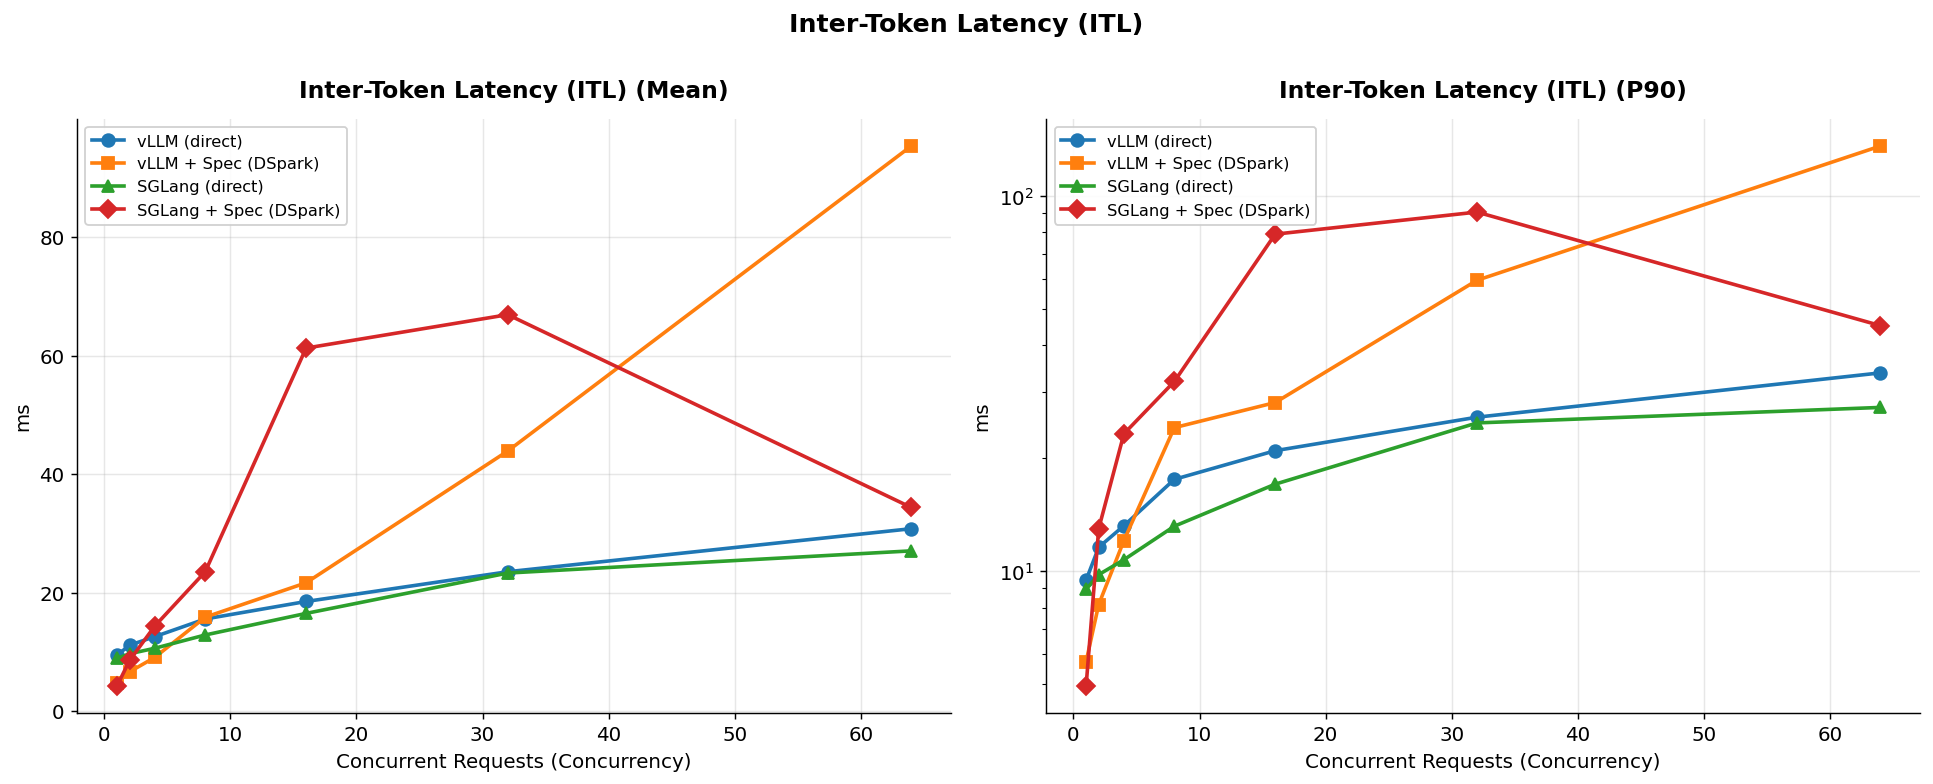
Bevindingen:
- Speculatieve decodering halveert de ITL bij lage belasting:
- vLLM: 9.46ms -> 4.84ms (49% afname)
- SGLang: 8.94ms -> 4.26ms (52% afname)
- Bij hoge belasting explodeert de speculatieve ITL:
- vLLM + Spec @c=64: 95.4ms (direct 30.8ms — 3.1x slechter)
- vLLM + Spec @c=32: 43.9ms (direct 23.6ms — 1.9x slechter)
- De ITL van vLLM direct en SGLang direct stijgt lineair en ligt dicht bij elkaar: ~27-31ms bij c=64.
- Laagste ITL (voor realtime toepassingen): vLLM + Spec @c=1: 4.84ms — maar onbruikbaar bij hoge belasting.
4.4 TPS (tokens per seconde per gebruiker)
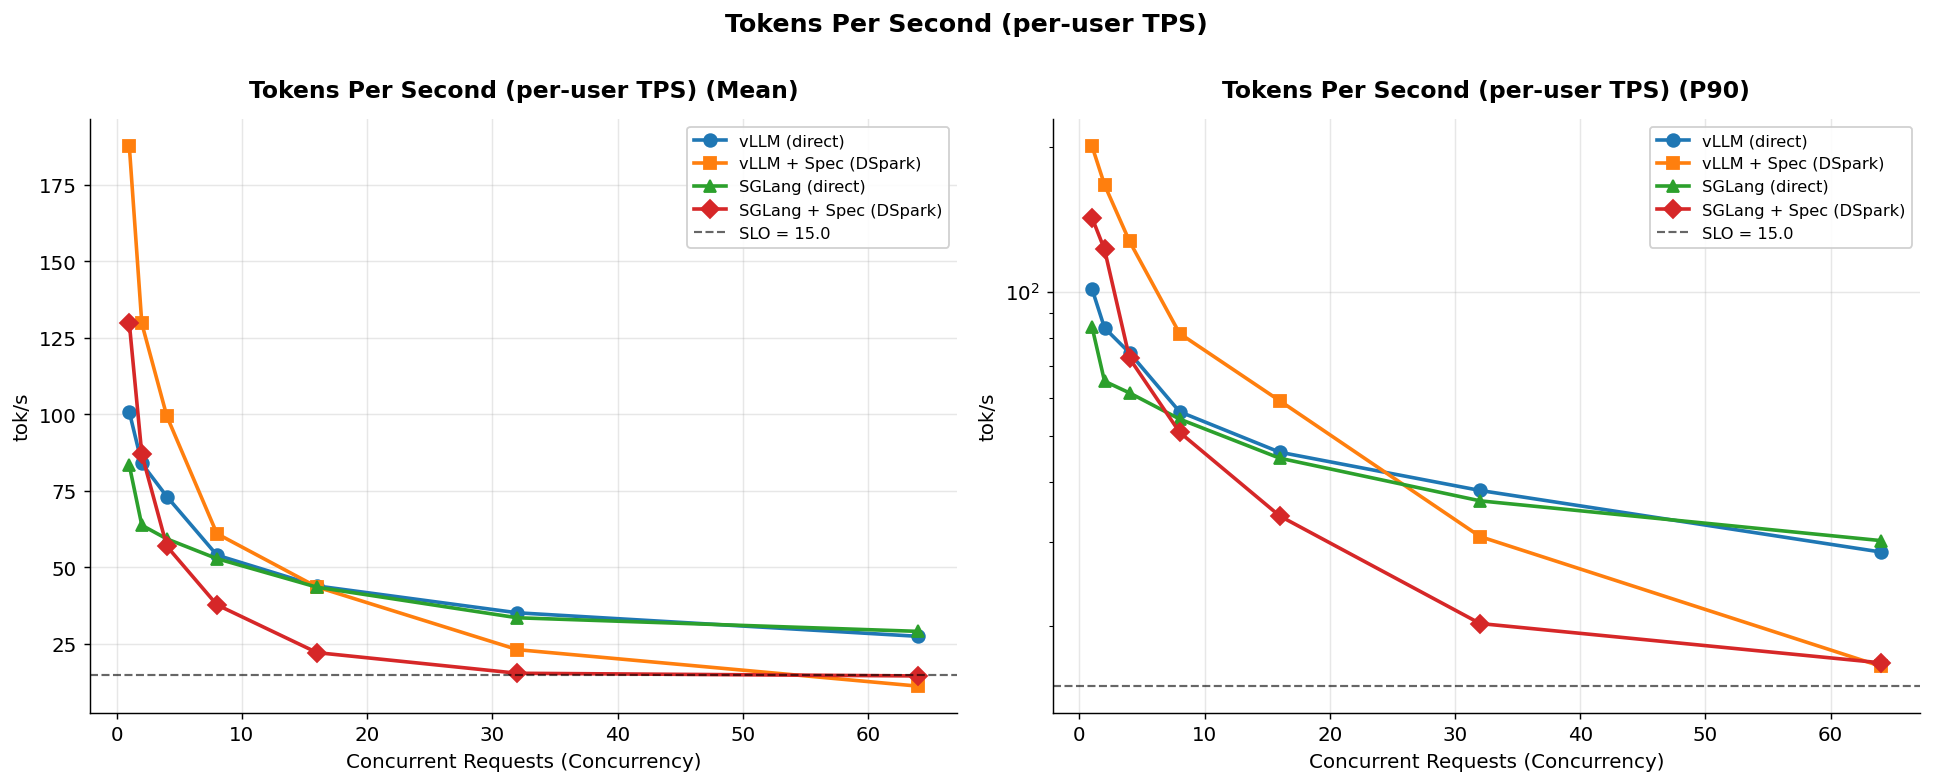
Bevindingen:
- Lage belasting (c<=4): Spec is duidelijk sneller dan direct
- vLLM c=1: 101 -> 188 tok/s (1.86x)
- vLLM c=4: 73 -> 99 tok/s (1.36x)
- SGLang c=1: 83 -> 130 tok/s (1.56x)
- Break-evenpunten:
- vLLM: c~16 (43.95 versus 43.60 tok/s) — gelijk
- SGLang: c~4 (59.3 versus 56.9 tok/s) — spec iets slechter
- Hoge belasting (c=64): Spec is nadelig
- vLLM: 27.5 -> 11.2 tok/s (0.41x — 2.4x trager)
- SGLang: 29.1 -> 14.5 tok/s (0.50x)
- SLO (15 tok/s) P90 (TPS-drempel):
- vLLM direct: haalt alle niveaus (P90 TPS 28.6 bij c=64)
- vLLM spec: haalt alle niveaus (P90 TPS 16.5 bij c=64 — maar zeer laag)
- SGLang direct: haalt alle niveaus (P90 TPS 30.2 bij c=64)
- SGLang spec: haalt het tot c=32 (P90 TPS 20.3), bij c=64 16.8 (net gehaald)
- SLO (1000ms) P90 (TTFT-drempel):
- vLLM direct: haalt het tot c=32 (P90 887ms), bij c=64 licht overschreden met 1107ms
- vLLM spec: haalt het tot c=32 (P90 802ms), bij c=64 overschreden met 1466ms
- SGLang direct: haalt het tot c=16 (P90 949ms), bij c=32 overschreden met 1205ms
- SGLang spec: haalt het tot c=2 (P90 496ms), bij c=4 overschreden met 1111ms
4.5 Latentie (totale duur van een verzoek)
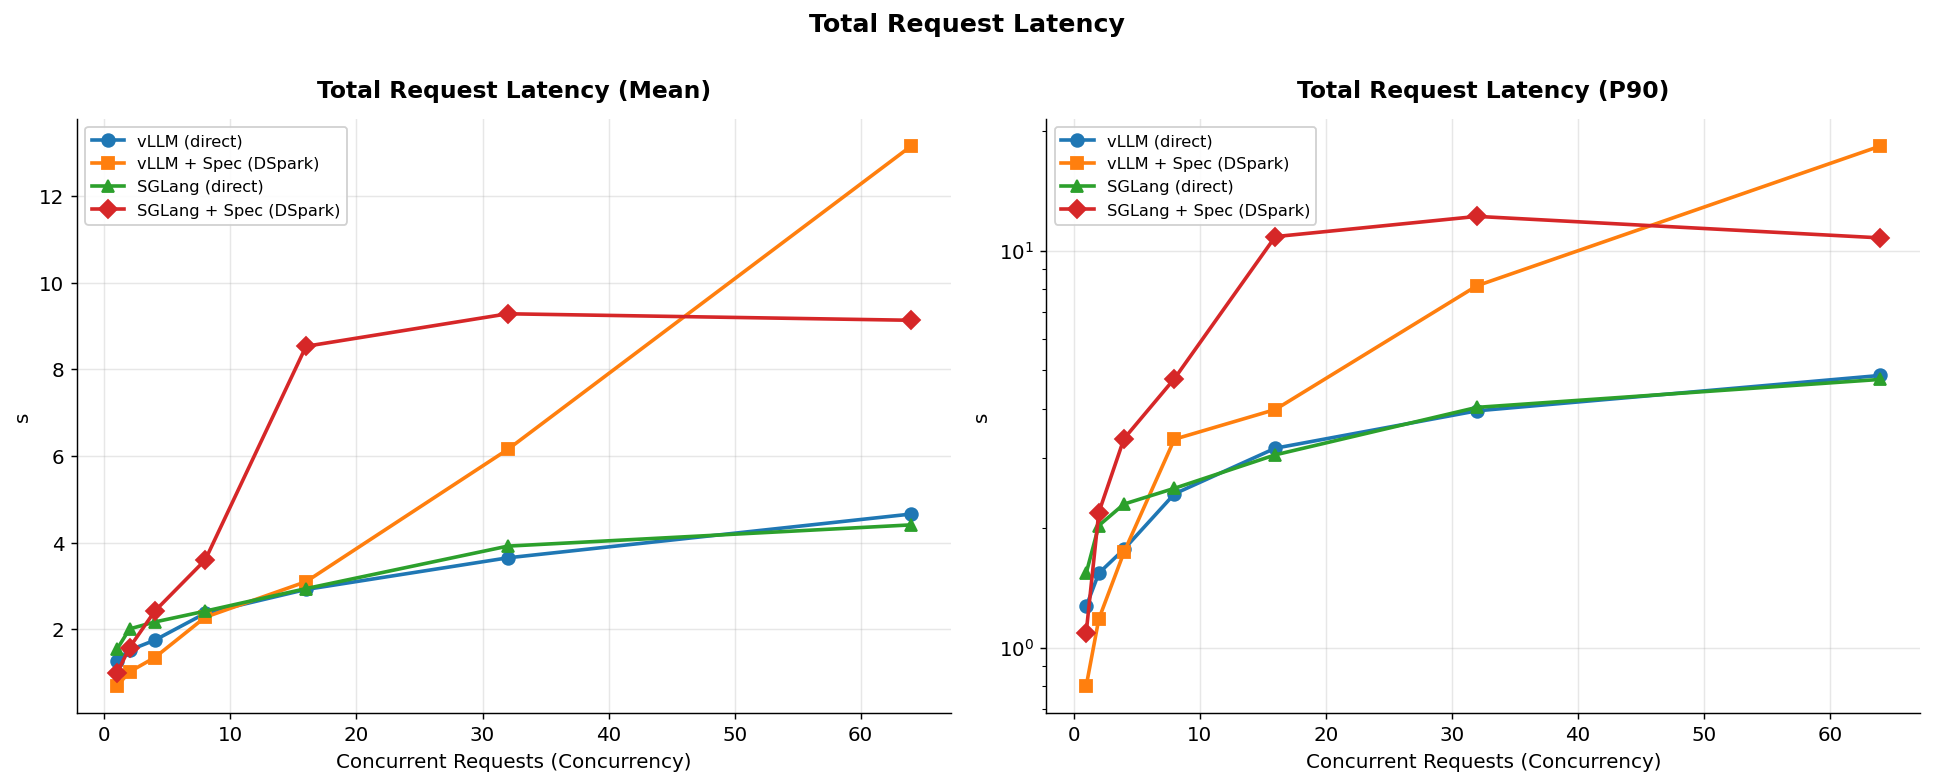
Bevindingen:
- Bij lage belasting verlaagt Spec de latentie drastisch:
- vLLM c=1: 1.27s -> 0.69s (46% afname)
- SGLang c=1: 1.54s -> 0.99s (36% afname)
- Bij hoge belasting laat Spec de latentie exploderen:
- vLLM + Spec @c=64: 13.15s (direct 4.66s — 2.8x slechter)
- SGLang + Spec @c=32: 9.28s (direct 3.92s — 2.4x slechter)
- vLLM direct en SGLang direct liggen bij hoge belasting dicht bij elkaar (c=64: 4.66 versus 4.41s).
- vLLM direct schaalt lineair (c=1: 1.27s, c=64: 4.66s — 3.7x toename bij 64x belasting).
4.6 Doorvoer (RPS)
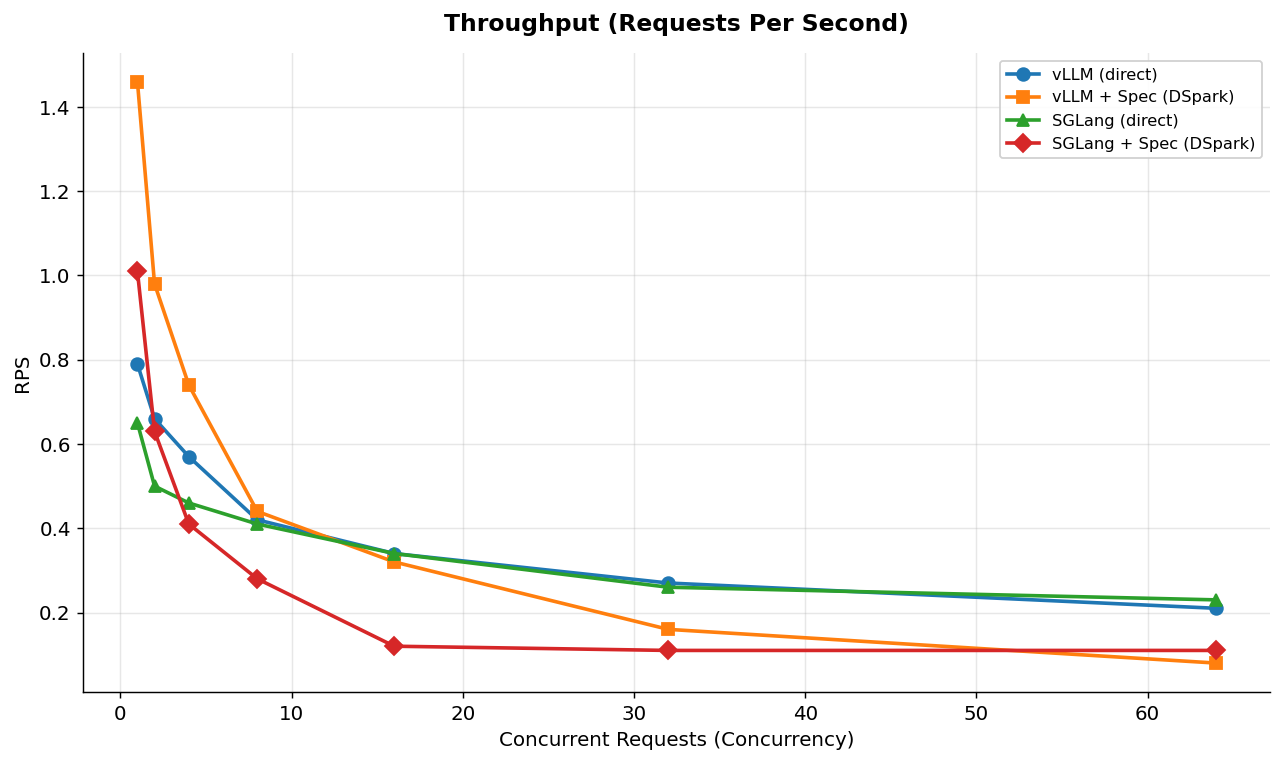
Bevindingen:
- Bij lage belasting levert Spec een hogere RPS (omdat het sneller klaar is):
- c=1: vLLM spec 1.46 RPS versus vLLM direct 0.79 RPS (1.85x)
- Bij hoge belasting levert direct een betere RPS (minder overhead):
- c=64: vLLM direct 0.21 RPS versus vLLM spec 0.08 RPS (0.38x)
- De RPS daalt voor alle configuraties naarmate de gelijktijdigheid stijgt — dat is te verwachten; elk verzoek duurt langer, maar er zijn meer gelijktijdige verzoeken.
- De RPS van SGLang + Spec @c=64 is gelijk aan die bij c=32 (0.11) — een teken van een knelpunt.
4.7 Totaal aantal geproduceerde tokens / seconde (totale output)
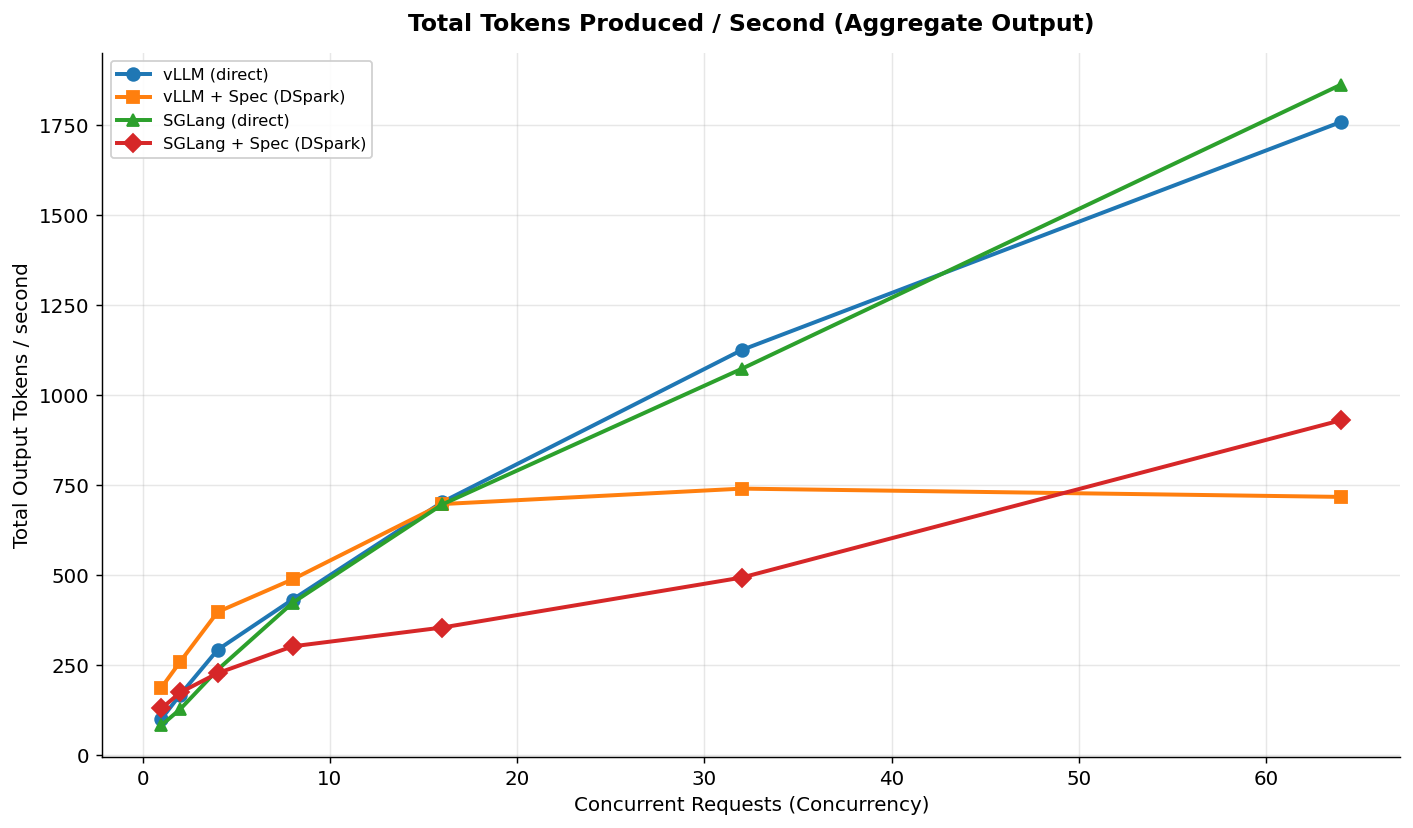
Deze metriek toont de totale productiecapaciteit van het systeem: TPS x Concurrency.
| c | vLLM dir | vLLM spec | sglang dir | sglang spec |
|---|---|---|---|---|
| 1 | 101 | 188 | 83 | 130 |
| 4 | 293 | 398 | 237 | 228 |
| 16 | 703 | 698 | 697 | 355 |
| 32 | 1126 | 740 | 1074 | 493 |
| 64 | 1759 | 717 | 1863 | 931 |
Bevindingen:
- Lineaire schaling van vLLM direct: c=1 (101) -> c=64 (1759) — 17.4x toename bij 64x belasting (sublineair, maar sterk).
- SGLang direct het hoogst bij c=64: 1863 tok/s — 6% beter dan vLLM.
- Knelpunt bij vLLM + Spec: c=32 naar 740 -> c=64 717 — daalt! Een verdubbeling van de belasting verlaagt dus de totale output — een klassiek knelpunt.
- SGLang + Spec slecht vanaf c=16: c=16 355 (direct 697) — de helft van direct.
- Efficiëntste punt (piek van de totale output):
- vLLM direct: c=64 (1759)
- vLLM spec: c=16 (698) — daalt daarna
- SGLang direct: c=64 (1863)
- SGLang spec: c=32 (493)
4.8 Analyse van de speculatieve versnelling
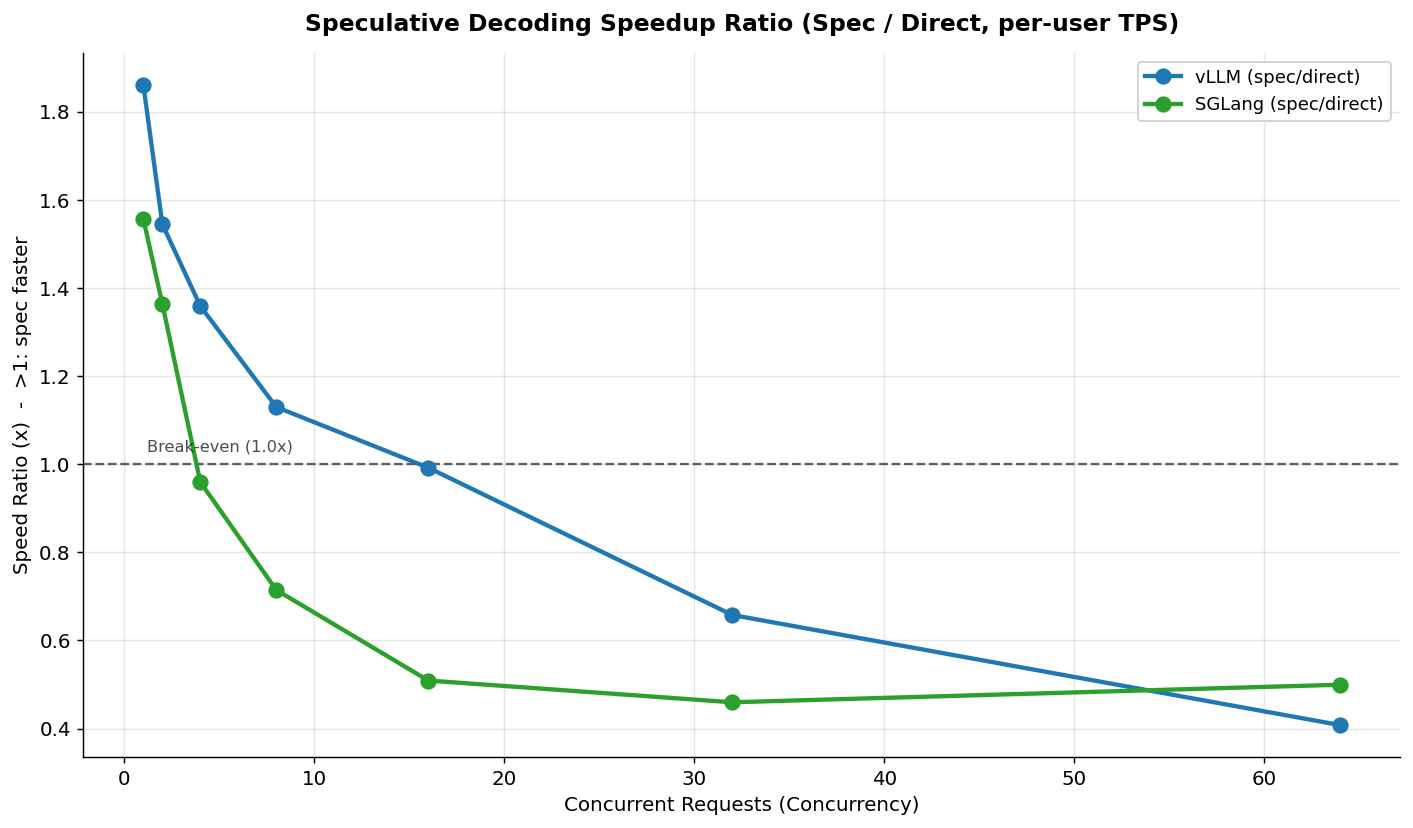
Verhouding spec/direct-TPS ten opzichte van de gelijktijdigheid:
| c | vLLM (spec/dir) | SGLang (spec/dir) |
|---|---|---|
| 1 | 1.86x | 1.56x |
| 2 | 1.55x | 1.36x |
| 4 | 1.36x | 0.96x |
| 8 | 1.13x | 0.71x |
| 16 | 0.99x (break-even) | 0.51x |
| 32 | 0.66x | 0.46x |
| 64 | 0.41x | 0.50x |
Bevindingen:
- Break-even van vLLM Spec: c~16. Daarboven een nettoverlies.
- Break-even van SGLang Spec: c~4. Breekt zeer vroeg.
- De reden dat Spec bij SGLang eerder breekt: de al hoge TTFT van SGLang
- de overhead van het draftmodel duwt het sneller over de grens.
- Vuistregel: speculatieve decodering moet alleen worden gebruikt in interactieve scenario’s met lage belasting (c<16 vLLM, c<4 SGLang). Voor productie met hoge belasting is het nadelig.
5. SLO- en relatieve capaciteitsanalyse
5.1 SLO-nalevingsmatrix (P90)
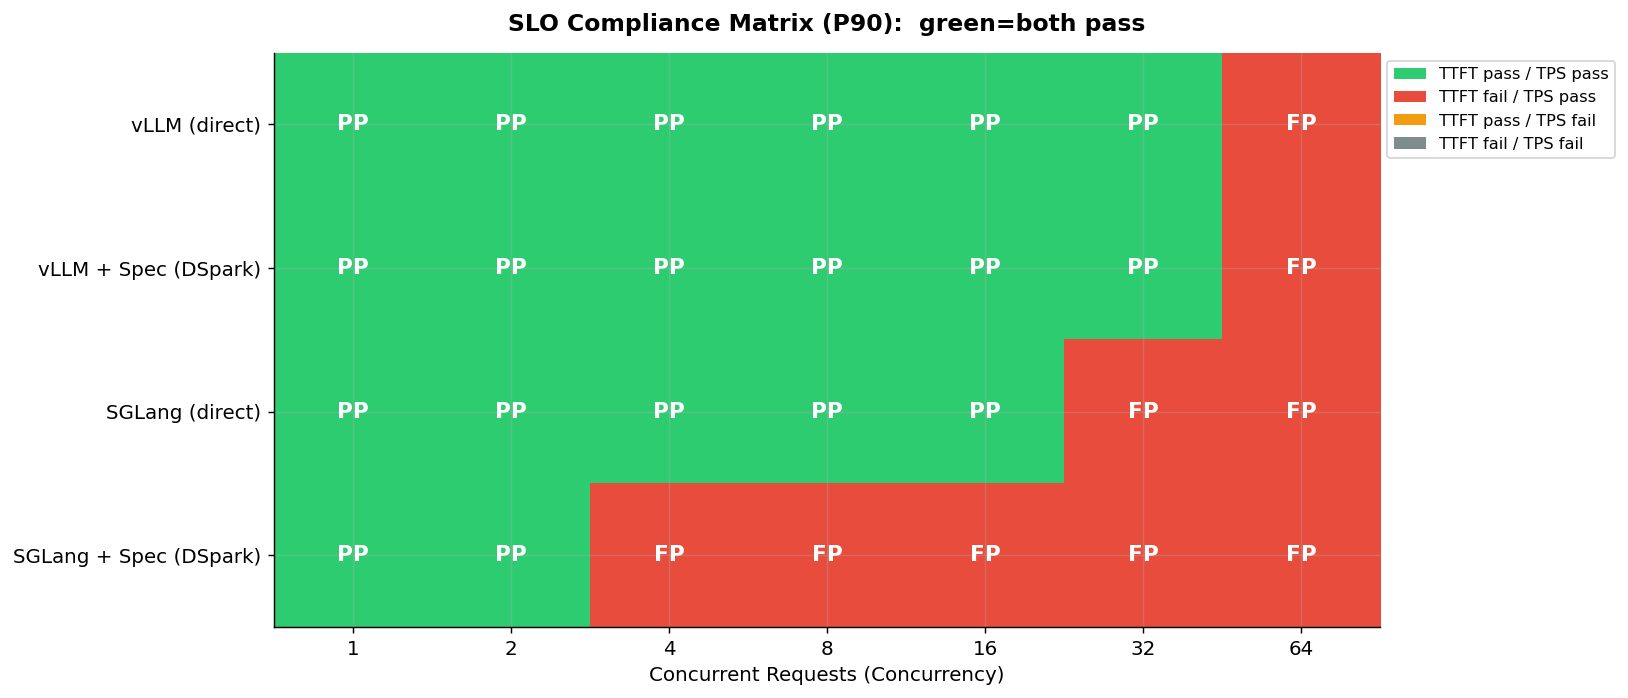
SLO-status voor elke combinatie van configuratie en gelijktijdigheid op het P90-percentiel:
| Configuratie | c=1 | c=2 | c=4 | c=8 | c=16 | c=32 | c=64 |
|---|---|---|---|---|---|---|---|
| vLLM direct | ✓✓ | ✓✓ | ✓✓ | ✓✓ | ✓✓ | ✓✓ | ✗✓ |
| vLLM + Spec | ✓✓ | ✓✓ | ✓✓ | ✓✓ | ✓✓ | ✓✓ | ✗✓ |
| SGLang direct | ✓✓ | ✓✓ | ✓✓ | ✓✓ | ✓✓ | ✗✓ | ✗✓ |
| SGLang + Spec | ✓✓ | ✓✓ | ✗✓ | ✗✓ | ✗✓ | ✗✓ | ✗✓ |
(✓/✗ = TTFT/TPS P90; eerste symbool TTFT, tweede TPS. ✓✓ = beide gehaald, ✗✓ = alleen TPS gehaald, TTFT overschrijdt de SLO licht)
5.2 Maximale gelijktijdigheid (C_max) en totaal aantal gebruikers (de wet van Little)
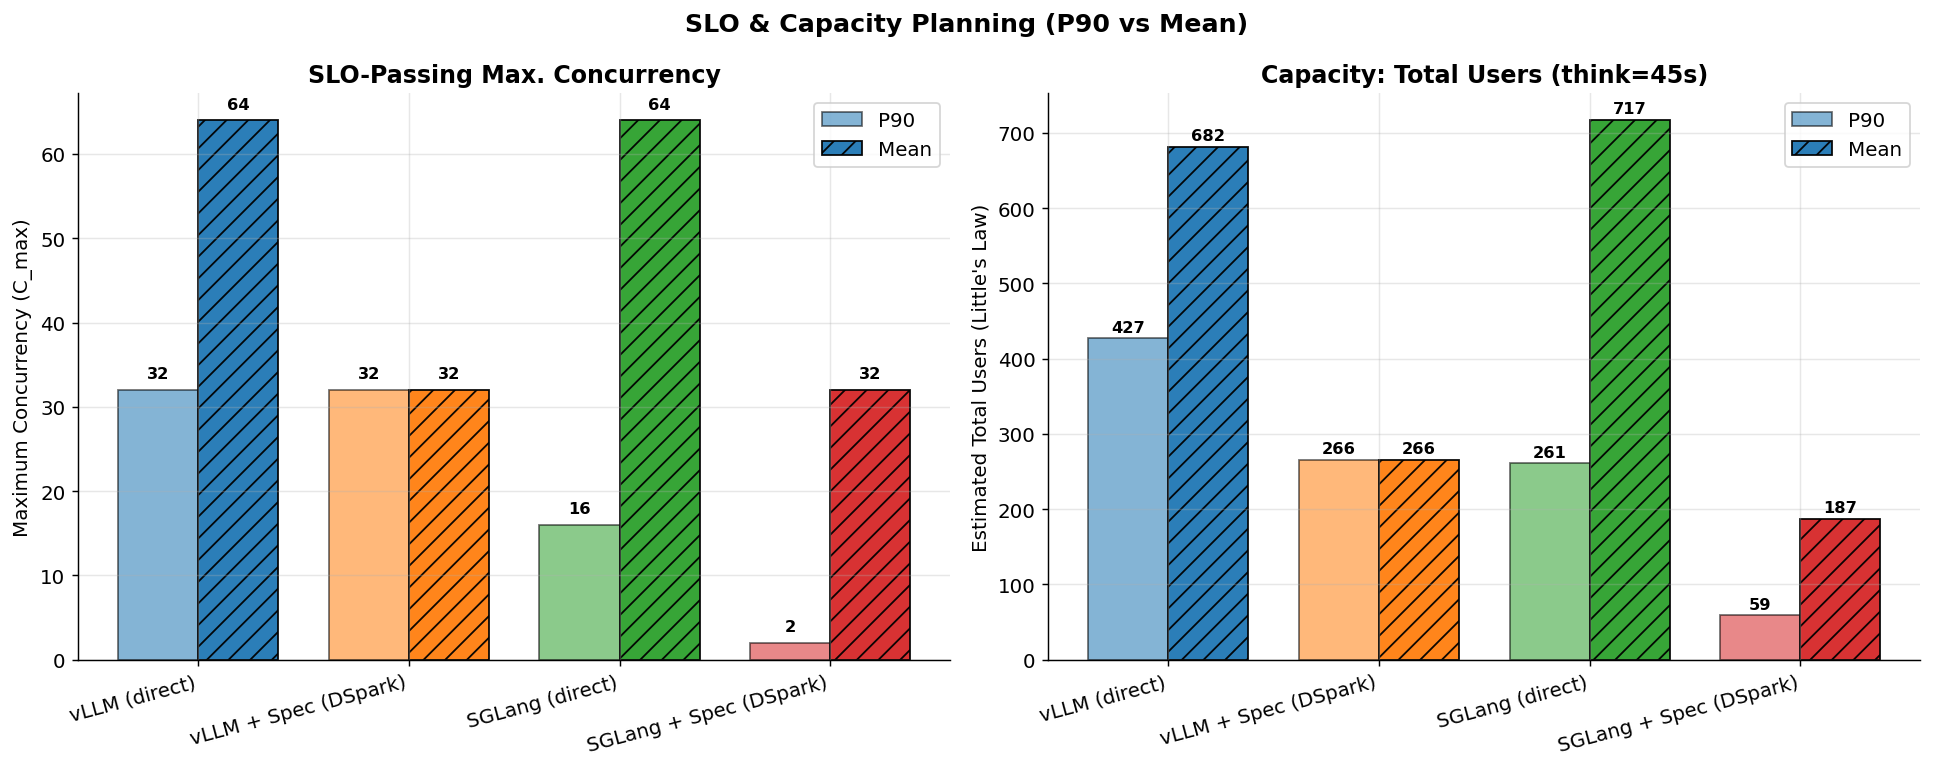
Totaal aantal gebruikers berekend met N = C_max x (1 + 45s / L_mean):
Op basis van P90 (aanbevolen voor productie — streng)
| Configuratie | C_max (P90) | L_mean @ C_max (s) | Totaal aantal gebruikers (N) |
|---|---|---|---|
| vLLM direct | 32 | 3.65 | 427 |
| vLLM + Spec | 32 | 6.15 | 266 |
| SGLang direct | 16 | 2.94 | 261 |
| SGLang + Spec | 2 | 1.58 | 59 |
Op basis van het gemiddelde (optimistisch — voor lage belasting)
| Configuratie | C_max (gemiddelde) | L_mean @ C_max (s) | Totaal aantal gebruikers (N) |
|---|---|---|---|
| vLLM direct | 64 | 4.66 | 682 |
| vLLM + Spec | 32 | 6.15 | 266 |
| SGLang direct | 64 | 4.41 | 717 |
| SGLang + Spec | 32 | 9.28 | 187 |
5.3 Interpretatie
- Productiecapaciteit op basis van P90: vLLM direct is het hoogst met 427 gebruikers. vLLM + Spec bereikt dezelfde C_max, maar door de hoge latentie is zijn N lager (266).
- Op basis van het gemiddelde: SGLang direct is het hoogst met 717 — omdat het bij c=64 nog aan de SLO (gemiddelde) voldoet. Maar omdat het bij P90 niet verder komt dan c=32, is het gemiddelde cijfer optimistisch.
- SGLang + Spec is het slechtst: breekt bij P90 al bij c=2 — alleen geschikt voor zeer lage belasting.
- Speculatieve decodering verhoogt C_max niet — hoewel het bij lage belasting de snelheid per gebruiker opvoert, breekt het bij hoge belasting de SLO en verlaagt het de totale capaciteit.
6. Vergelijkingskader en interpretatiegids
6.1 Wat deze benchmark doet
CordatusAI/llm-benchmark is ontworpen om LLM-inferentieservers relatief te vergelijken. De tool gebruikt een vaste workload (128/128 tokens) om reproduceerbare metingen te leveren.
6.2 Vergelijkingsassen
Deze tool is geschikt voor vergelijking langs 3 assen:
| As | Vast | Variabel |
|---|---|---|
| Inferentie-engine | Model + hardware | vLLM versus SGLang versus TRT-LLM… |
| Model | Hardware + engine | Kimi K3 versus Llama versus DeepSeek… of direct versus spec (ander draftmodel) |
| Hardware | Model + engine | DGX-B300 versus H100 versus MI300X… |
Dit rapport gebruikt 2 assen tegelijk
Dit rapport behandelt niet één as, maar twee assen tegelijk — de 4 configuraties vormen een 2x2-matrix:
| Direct (geen draftmodel) | Speculatief (DSpark-draftmodel) | |
|---|---|---|
| vLLM | vLLM (direct) | vLLM + Spec (Inferact/Kimi-K3-DSpark) |
| SGLang | SGLang (direct) | SGLang + Spec (RadixArk/Kimi-K3-DSpark) |
- As van de inferentie-engine (horizontaal): hetzelfde model (Kimi K3), dezelfde hardware (DGX-B300),
dezelfde speculatieve modus — vergelijking van vLLM en SGLang.
- vLLM direct versus SGLang direct
- vLLM + Spec versus SGLang + Spec
- As van de modelconfiguratie (verticaal): dezelfde engine, dezelfde hardware — vergelijking van direct
en speculatief. Omdat speculatieve decodering een ander draftmodel gebruikt, is dit
technisch gezien een vergelijking op modelbasis:
- vLLM direct versus vLLM + Spec (draft:
Inferact/Kimi-K3-DSpark) - SGLang direct versus SGLang + Spec (draft:
RadixArk/Kimi-K3-DSpark)
- vLLM direct versus vLLM + Spec (draft:
Belangrijk: omdat vLLM en SGLang verschillende draftmodellen gebruiken, omvat de vergelijking “vLLM + Spec versus SGLang + Spec” zowel het verschil tussen de engines als het verschil tussen de draftmodellen. Houd rekening met deze beperking wanneer u de twee engines in speculatieve modus rechtstreeks vergelijkt.
6.3 Beperkingen van de workload (belangrijk)
Houd er rekening mee dat deze metingen niet representatief zijn voor echte productieworkloads:
| Beperking | Toelichting |
|---|---|
| Vast 128/128 tokens | Echte chat heeft een output van 200-1000+ tokens, met variabele lengte |
| Losse verzoeken | Opbouw van context over meerdere beurten (KV-cache-hit) niet gemeten |
| Volledige context actief | --max-model-len 1048576 — de overhead van 1M context werkt door in verzoeken van 128 tokens |
| Weinig input | Meet het prefill-gedrag bij lange prompts (1K-32K) niet |
| Sjabloonprompts | Echte gebruikersprompts vertonen gevarieerdere verdelingen |
6.4 Resultaten interpreteren
Er bestaat geen gestandaardiseerd gebruiksscenario
Hetzelfde model (Kimi K3) wordt in de praktijk in zeer verschillende belastingsprofielen gebruikt, en geen daarvan kan worden beschouwd als het “enige juiste” scenario:
- Chat: één gebruiker, korte input/output, lage gelijktijdigheid, korte denktijd
- Agent: meerdere stappen, variabele lengte, tool calls, gemiddelde gelijktijdigheid
- Automatisering / batch: hoge gelijktijdigheid, lange input/output, lange denktijd
- API-dienst: gemengde belasting, onvoorspelbare verdelingen van gelijktijdigheid/input/output
Door deze diversiteit kunnen gelijktijdigheid en de omvang van input en output niet vooraf worden bepaald — ze variëren met de aard van de toepassing, het gedrag van gebruikers en het tijdstip van de dag. De metingen met 128/128 tokens
- 45s denktijd in dit rapport vertegenwoordigen een specifiek werkpunt; ze geven echte productieworkloads niet exact weer.
Onvoorspelbare variabelen in dit rapport
De volgende factoren liggen in deze benchmark vast, maar variëren bij echt gebruik:
| Variabele | In dit rapport | Bereik in de praktijk |
|---|---|---|
| Gelijktijdigheid | 1-64 | 1-1000+ (afhankelijk van de toepassing) |
| Input-tokens | 128 (vast) | 10-32K+ (afhankelijk van de promptinhoud) |
| Output-tokens | 128 (vast) | 50-4096+ (afhankelijk van de taak) |
| Denktijd | 45s (aanname) | 5s (snel interactief) - 120s (diepgaand werk) |
Kanttekeningen voor een consistente interpretatie
Gezien de bovenstaande beperkingen moeten de resultaten van dit rapport met de volgende kanttekeningen worden geïnterpreteerd:
- Dit rapport is waardevol voor een relatieve rangorde, niet voor absolute productieramingen. In plaats van “vLLM direct ondersteunt 427 gebruikers” is het consistenter om te zeggen “vLLM direct ondersteunt 1.6x meer gebruikers dan vLLM + Spec”.
- P90 is een realistischer productie-indicator dan het gemiddelde — staartlatentie (tail latency) is kritiek in productie. Beslissingen over productie in dit rapport zijn gebaseerd op P90.
- De met de wet van Little berekende aantallen gebruikers hangen af van de aangenomen denktijd van 45s; als de denktijd van uw echte toepassing afwijkt, veranderen de getallen.
- Het hier gemeten break-evenpunt van speculatieve decodering is ~c16 voor vLLM en ~c4 voor SGLang; deze punten kunnen verschuiven bij andere workloads of hardware.
- De meest geschikte configuratie hangt af van het belastingsprofiel van uw doelscenario (zie Sectie 1).
6.5 Invloed van een deployment met volledige context
Het model is uitgerold met --max-model-len 1048576. Dit betekent dat voor elk verzoek KV-cachebeheer
voor 1M tokens wordt uitgevoerd. De TTFT die voor een input van 128 tokens wordt gemeten, weerspiegelt in feite de kosten van
“het verwerken van 128 tokens op een systeem met een contextcapaciteit van 1M.”
De hier gemeten prefill-snelheden zijn daarom geen absolute prefill-snelheid, maar prefill-snelheid
onder de configuratie met volledige context. Met een kortere --max-model-len kan het gebruik van de KV-cache
anders uitvallen en kan de prefill-snelheid variëren.
7. Conclusie
Vier verschillende configuraties van inferentie-engines voor het Kimi K3-model zijn op DGX-B300 vergeleken: vLLM (direct), vLLM + DSpark speculative, SGLang (direct) en SGLang + DSpark speculative.
Gemeten gedrag:
- Bij lage belasting (c<=4): speculatieve decodering verhoogt de TPS per gebruiker met 1.4-1.9x en halveert de ITL (vLLM: 9.5ms -> 4.8ms).
- Break-evenpunten: ~c16 voor vLLM, ~c4 voor SGLang. Daarboven presteert speculatieve decodering slechter dan direct.
- Bij hoge belasting (c=64): de TPS per gebruiker van vLLM + Spec daalt tot 11 tok/s (vLLM direct 27 tok/s). De totale output van vLLM+Spec daalt van c=32 naar c=64.
- De TTFT van SGLang direct is hoger dan die van vLLM direct (400ms versus 66ms bij c=1) — dit verschil komt voort uit de configuratie van de prefill-backend van de engines (zie Sectie 3.4).
- Anomalie bij SGLang + Spec @c=64: TTFT 4752ms (was 777ms bij c=32).
Belangrijk: alle resultaten dienen voor relatieve vergelijking. Ze zijn gebaseerd op een vaste workload van 128/128 tokens en een aangenomen denktijd van 45s. Voor echte productieworkloads wordt een aparte benchmark aanbevolen.
Bijlage A: alle CSV-gegevens
A.1 vLLM (direct)
| c | TTFT gem. | TTFT P90 | ITL gem. | ITL P90 | TPS gem. | TPS P90 | Lat. gem. | Lat. P90 | RPS |
|---|---|---|---|---|---|---|---|---|---|
| 1 | 66.5 | 70.5 | 9.46 | 9.47 | 100.84 | 101.30 | 1.27 | 1.27 | 0.79 |
| 2 | 105.5 | 154.9 | 11.16 | 11.58 | 83.98 | 83.99 | 1.52 | 1.54 | 0.66 |
| 4 | 145.9 | 197.6 | 12.61 | 13.22 | 73.17 | 74.47 | 1.75 | 1.77 | 0.57 |
| 8 | 388.0 | 520.9 | 15.59 | 17.57 | 54.03 | 56.11 | 2.37 | 2.44 | 0.42 |
| 16 | 543.8 | 693.4 | 18.54 | 20.95 | 43.95 | 46.19 | 2.92 | 3.18 | 0.34 |
| 32 | 608.1 | 887.5 | 23.56 | 25.73 | 35.18 | 38.43 | 3.65 | 3.95 | 0.27 |
| 64 | 731.7 | 1107.0 | 30.82 | 33.77 | 27.49 | 28.59 | 4.66 | 4.85 | 0.21 |
A.2 vLLM + Spec (DSpark)
| c | TTFT gem. | TTFT P90 | ITL gem. | ITL P90 | TPS gem. | TPS P90 | Lat. gem. | Lat. P90 | RPS |
|---|---|---|---|---|---|---|---|---|---|
| 1 | 71.0 | 77.8 | 4.84 | 5.74 | 187.74 | 201.34 | 0.69 | 0.80 | 1.46 |
| 2 | 172.9 | 191.2 | 6.67 | 8.15 | 129.75 | 167.10 | 1.02 | 1.18 | 0.98 |
| 4 | 191.5 | 265.9 | 9.11 | 12.07 | 99.43 | 127.29 | 1.35 | 1.74 | 0.74 |
| 8 | 262.9 | 455.0 | 15.89 | 24.13 | 61.04 | 81.74 | 2.28 | 3.35 | 0.44 |
| 16 | 344.3 | 594.2 | 21.69 | 28.15 | 43.60 | 59.14 | 3.10 | 3.98 | 0.32 |
| 32 | 565.2 | 802.0 | 43.93 | 59.60 | 23.14 | 30.79 | 6.15 | 8.16 | 0.16 |
| 64 | 1030.9 | 1465.5 | 95.38 | 135.86 | 11.21 | 16.51 | 13.15 | 18.35 | 0.08 |
A.3 SGLang (direct)
| c | TTFT gem. | TTFT P90 | ITL gem. | ITL P90 | TPS gem. | TPS P90 | Lat. gem. | Lat. P90 | RPS |
|---|---|---|---|---|---|---|---|---|---|
| 1 | 399.5 | 397.2 | 8.94 | 8.95 | 83.40 | 84.44 | 1.54 | 1.54 | 0.65 |
| 2 | 771.7 | 786.9 | 9.72 | 9.79 | 63.79 | 64.99 | 2.01 | 2.03 | 0.50 |
| 4 | 811.0 | 948.2 | 10.65 | 10.73 | 59.33 | 61.42 | 2.17 | 2.30 | 0.46 |
| 8 | 782.6 | 820.6 | 12.89 | 13.18 | 52.88 | 54.17 | 2.42 | 2.52 | 0.41 |
| 16 | 833.6 | 948.8 | 16.53 | 17.06 | 43.54 | 44.88 | 2.94 | 3.06 | 0.34 |
| 32 | 915.2 | 1204.5 | 23.34 | 24.84 | 33.55 | 36.56 | 3.92 | 4.03 | 0.26 |
| 64 | 948.4 | 1263.5 | 27.08 | 27.32 | 29.11 | 30.20 | 4.41 | 4.74 | 0.23 |
A.4 SGLang + Spec (DSpark)
| c | TTFT gem. | TTFT P90 | ITL gem. | ITL P90 | TPS gem. | TPS P90 | Lat. gem. | Lat. P90 | RPS |
|---|---|---|---|---|---|---|---|---|---|
| 1 | 450.6 | 630.0 | 4.26 | 4.94 | 129.86 | 142.68 | 0.99 | 1.09 | 1.01 |
| 2 | 484.6 | 495.7 | 8.59 | 12.98 | 87.02 | 122.46 | 1.58 | 2.19 | 0.63 |
| 4 | 588.3 | 1111.4 | 14.39 | 23.24 | 56.92 | 72.54 | 2.42 | 3.36 | 0.41 |
| 8 | 610.3 | 1070.4 | 23.56 | 32.04 | 37.78 | 50.83 | 3.60 | 4.76 | 0.28 |
| 16 | 745.1 | 1155.4 | 61.29 | 79.10 | 22.16 | 33.99 | 8.53 | 10.85 | 0.12 |
| 32 | 776.9 | 1166.4 | 66.93 | 90.59 | 15.42 | 20.27 | 9.28 | 12.20 | 0.11 |
| 64 | 4752.6 | 5252.9 | 34.40 | 45.13 | 14.54 | 16.78 | 9.13 | 10.77 | 0.11 |
Bijlage B: vergelijkingsgrafieken
De volgende grafieken zijn voor dit rapport gemaakt (map karsilastirma-en/):
| # | Bestand | Inhoud |
|---|---|---|
| 1 | 01-TTFT.png |
TTFT gemiddeld + P90, 4 configuraties |
| 2 | 02-ITL.png |
ITL gemiddeld + P90, 4 configuraties |
| 3 | 03-TPS.png |
TPS per gebruiker gemiddeld + P90, 4 configuraties |
| 4 | 04-Latency.png |
Latentie gemiddeld + P90, 4 configuraties |
| 5 | 05-Throughput.png |
Doorvoer (RPS), 4 configuraties |
| 6 | 06-Kapasite.png |
C_max + N volgens de wet van Little (P90 en gemiddelde) |
| 7 | 07-Aggregate-Output.png |
Totaal geproduceerde tok/s (TPS x c) |
| 8 | 08-Spec-Speedup.png |
Verhouding spec/direct-TPS, break-even |
| 9 | 09-SLO-Heatmap.png |
SLO-nalevingsmatrix (P90) |
| 10 | 10-Dashboard.png |
Overzicht in een raster van 2x3 (gemiddelde waarden) |
B.1 Overzicht in één oogopslag (dashboard)
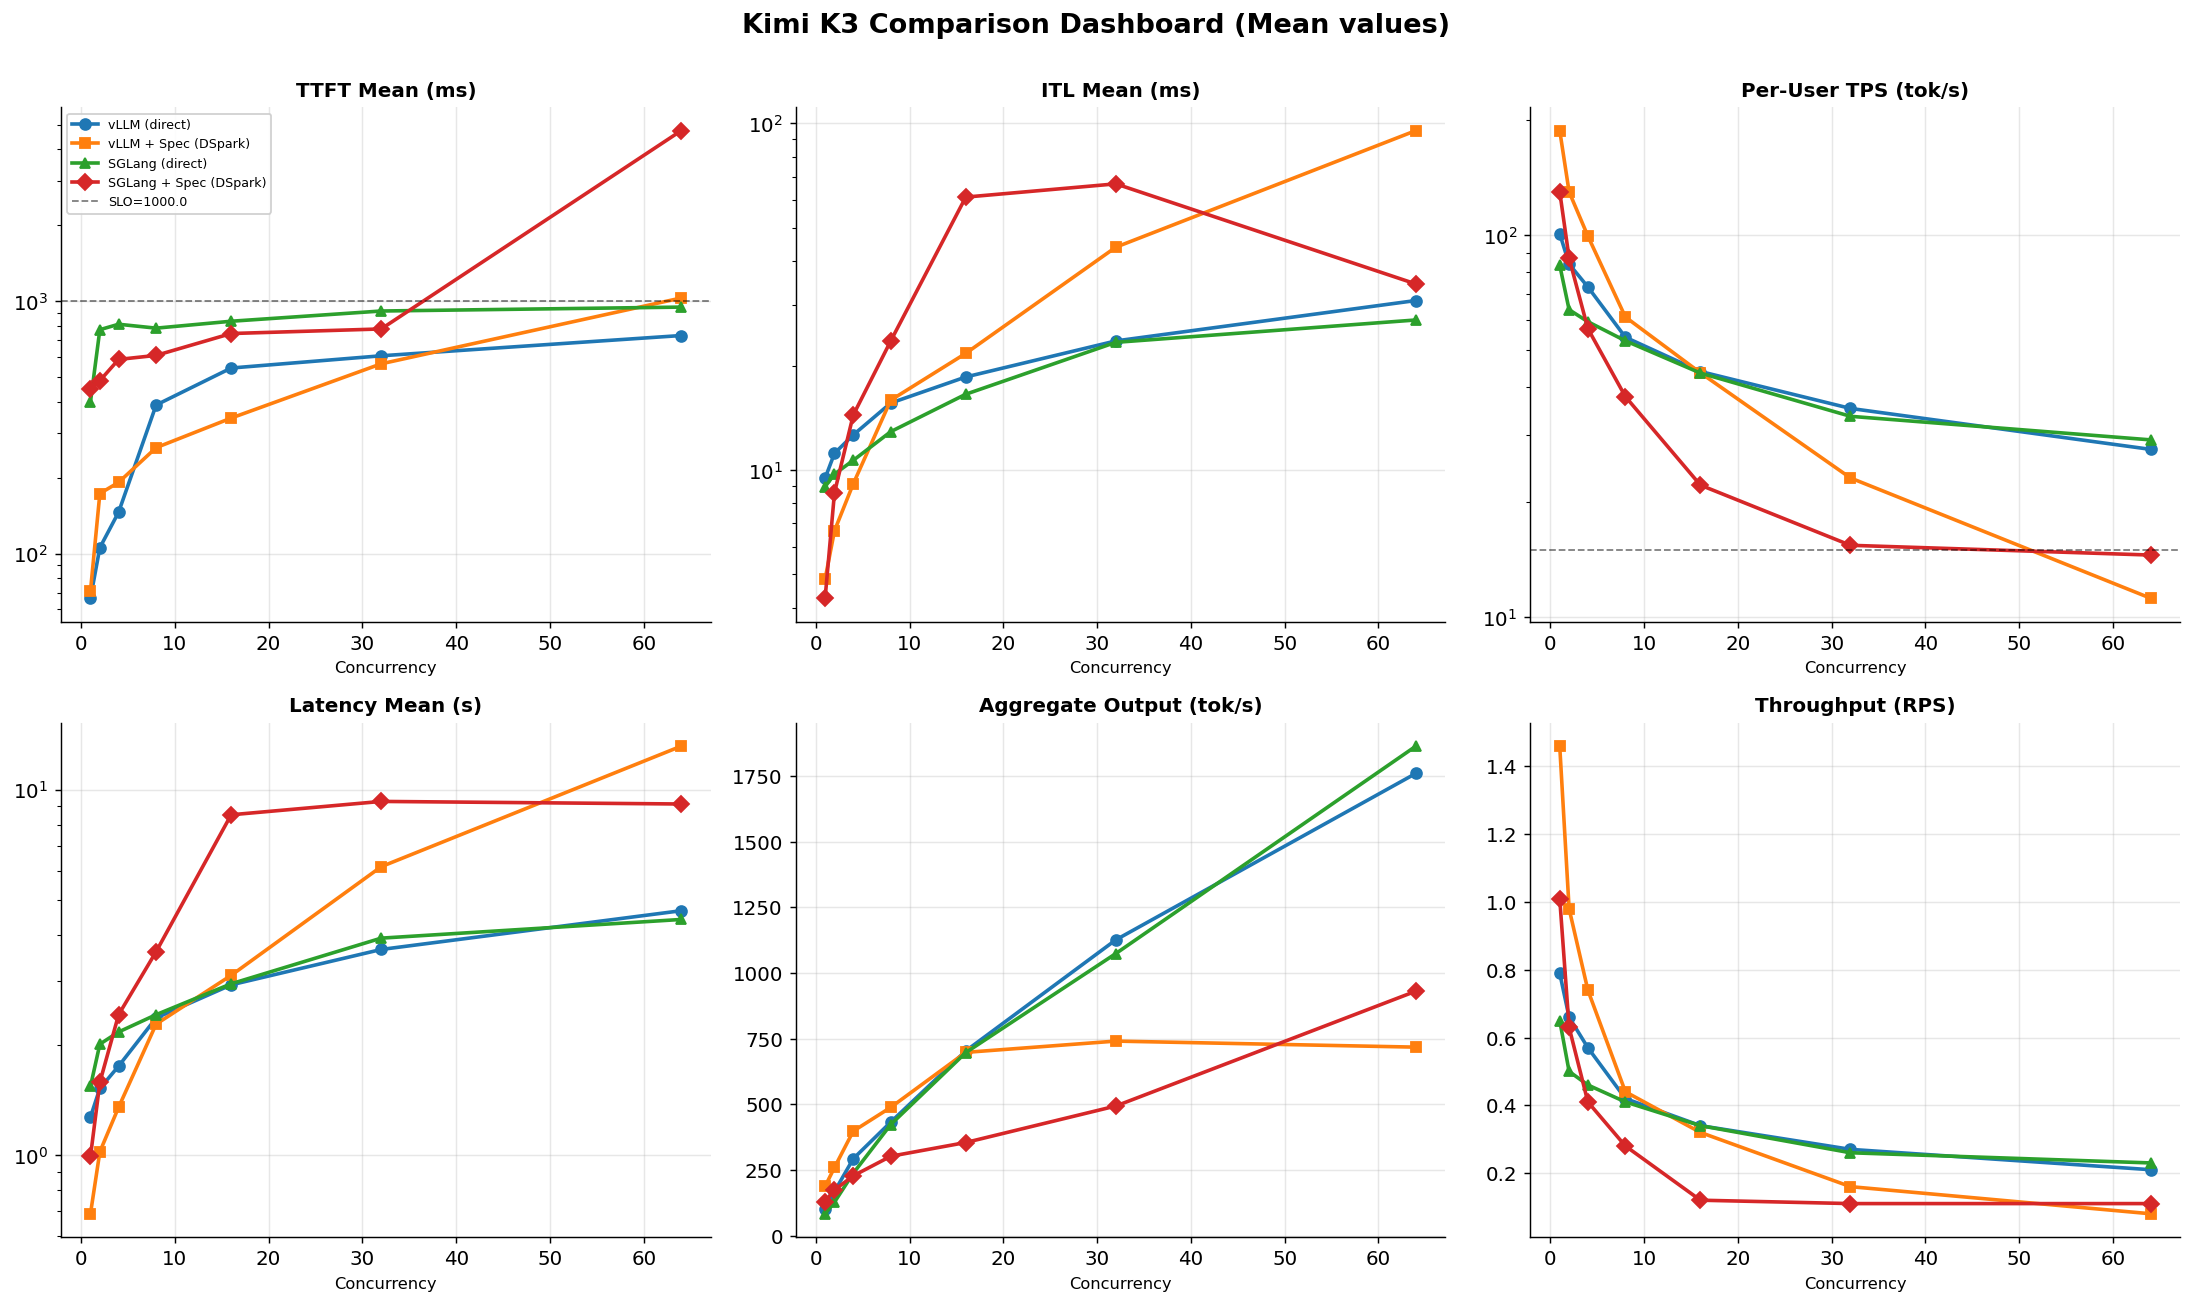
Dit rapport is opgesteld op basis van metingen die zijn verricht met de tool CordatusAI/llm-benchmark. De deploymentcommando’s zijn overgenomen uit de officiële Kimi K3-recipes van vLLM en SGLang. De grafieken zijn gemaakt met matplotlib 3.7.5 + plotly 6.8.0. Rapportdatum: juli 2026