Publicatiedatum: oktober 2026 Reikwijdte: Hoe tensorparallelle (TP) inferentie het netwerk tussen DGX Spark-systemen gebruikt, hoe u het effect van een gehalveerde linksnelheid schat op basis van de architectuur van het model en de instellingen van de inferentie-engine, en een gemeten vergelijking van 200 Gb/s-links en geëmuleerde 100 Gb/s-links op 8× DGX Spark met GLM-5.3 op TP8. Opmerking: De metingen gelden voor het model, de inferentie-engine, de versies en de instellingen in Sectie 7. De schattingsmethode van Secties 3–6 is overdraagbaar naar andere modellen en instellingen; de gemeten getallen zijn dat niet.
Opgesteld door: Openzeka Teknoloji A.Ş. — officiële Embedded Compute-distributeur van NVIDIA voor Türkiye & MEA, en NVIDIA Elite Partner
Inhoudsopgave
- Managementsamenvatting
- 1. Inleiding
- Deel I: Theorie
- Deel II: Meting
- 7. Testopzet
- 8. Resultaten: 200 Gb/s versus geëmuleerde 100 Gb/s op TP8
- 9. Van de geëmuleerde link naar een echte 100G-kabel
- 10. Projectie: hoe de vertraging verandert met de TP-grootte
- 11. Zijn 8 Sparks op 100 Gb/s redelijk?
- 12. Beperkingen en aandachtspunten
- 13. Conclusie
- Bijlage A: RDMA-verkeer meten
- Bijlage B: Reproduceerbaarheid
- Woordenlijst
- Bronnen
Managementsamenvatting
- De vraag: een DGX Spark-cluster dat één model met tensorparallellisme over 8 systemen bedient, heeft snelle switchpoorten nodig. Met 200 Gb/s per Spark verbindt een MikroTik CRS812 4 tot 6 Sparks; met 100 Gb/s verbindt hij er 8. Een CRS804 verbindt 8 Sparks op 200 Gb/s of 16 op 100 Gb/s. Deze paper onderzoekt wat 100 Gb/s per Spark kost aan inferentiesnelheid.
- Hoe tensorparallellisme het netwerk gebruikt: elke Spark bevat een achtste van elke gewichtsmatrix en berekent dus maar een deel van elk resultaat. Twee keer per laag tellen de Sparks hun deelresultaten via het netwerk bij elkaar op, in een bewerking die all-reduce heet. Terwijl de prompt wordt verwerkt (prefill), zijn de gegevens die in elke all-reduce worden opgeteld groot; terwijl het antwoord wordt gegenereerd (decode), zijn ze klein.
- De schatting: de overdrachten tijdens prefill zijn groot genoeg om op de volle linksnelheid te lopen, dus een gehalveerde link maakt ze langer en vertraagt het eerste token. Voor GLM-5.3 op TP8 geeft de schatting op basis van de architectuur van het model op 100 Gb/s ten hoogste 0.135 s extra tijd tot het eerste token (TTFT) per 1,000 prompttokens. De overdrachten tijdens decode zijn te klein om de linksnelheid ertoe te laten doen.
- Gebruikt het cluster de volle 200 Gb/s? Ja en nee. Gemeten met een resolutie van een milliseconde bereikt het prefill-verkeer 150–200 Gb/s in bursts van enkele milliseconden. Gemiddeld over één seconde is hetzelfde verkeer ongeveer 40 Gb/s, en decode blijft op enkele Gb/s.
- Gemeten met GLM-5.3 op TP8, 200 Gb/s tegenover een geëmuleerde 100 Gb/s-link (die tot 109 Gb/s draagt):
- de decodesnelheid verandert niet (−2.3% tot +4.3%, binnen de variatie tussen testrondes);
- de TTFT neemt toe met 12.6–13.9% voor afzonderlijke prompts van 8K–64K tokens, ongeveer 0.11 s per 1,000 prompttokens, dicht bij de schatting;
- wanneer vier lange prompts tegelijk binnenkomen, neemt de TTFT van elk verzoek toe met 17.9–22.5%;
- korte prompts worden niet beïnvloed (+1% bij 1K tokens).
- Een echte 100 Gb/s-kabel zou er ten hoogste nog 2.5–3.5 procentpunt aan toevoegen.
- Conclusie: wie een TP8-cluster van 8 Sparks van 200 Gb/s- naar 100 Gb/s-links overzet, kan verwachten dat het eerste token bij een zeer lange prompt ten hoogste ongeveer 20% later komt, en ten hoogste ongeveer 30% later wanneer meerdere zeer lange prompts tegelijk binnenkomen. Korte tot middellange prompts merken geen verschil, en zodra het antwoord begint, stroomt het in hetzelfde tempo. Gebruik op 16 Sparks twee TP8-clusters in plaats van één TP16-cluster: de vertraging neemt toe met de TP-grootte.
1. Inleiding
Eén DGX Spark heeft 128 GB unified memory. Modellen die groter zijn, worden bediend door ze te verdelen over meerdere Sparks die via hun ConnectX-7-netwerkadapters en een switch met elkaar verbonden zijn. Bij tensorparallellisme wordt elke laag van het model over alle Sparks verdeeld, zodat ze voor elk token dat het model verwerkt vele malen gegevens uitwisselen, en elke stap van de inferentie op het netwerk wacht.
Daarmee wordt de switch een ontwerpbeslissing. Door elke Spark op 100 Gb/s in plaats van 200 Gb/s te laten draaien, kan een kleinere switch dezelfde 8 Sparks bedienen, of dezelfde switch twee keer zoveel. Of dat aanvaardbaar is, hangt af van hoeveel tensorparallelle inferentie vertraagt wanneer de link tussen de Sparks half zo snel is.
Deel I van deze paper (Secties 2–6) beschrijft wat tensorparallellisme over het netwerk stuurt, waarom het verwerken van de prompt en het genereren van het antwoord het netwerk heel verschillend belasten, en hoe u het effect van een gehalveerde linksnelheid schat op basis van alleen de architectuur van het model, de instellingen van de inferentie-engine en de linksnelheid. Deel II (Secties 7–10) meet 200 Gb/s tegenover een geëmuleerde 100 Gb/s-link op 8× DGX Spark die GLM-5.3 op TP8 bedienen, vergelijkt de resultaten met de schatting en rekent ze om naar een echte 100 Gb/s-kabel. Sectie 11 geeft het dimensioneringsantwoord voor clusters van 8 en 16 Sparks.
Deel I: Theorie
2. Het DGX Spark-netwerk
2.1. De ConnectX-7-adapter en zijn twee PCIe-links
Elke DGX Spark heeft een ConnectX-7-netwerkadapter met twee QSFP-poorten. De clusters in deze paper gebruiken één poort per Spark, met een kabel naar de switch op een nominale linksnelheid van 200 Gb/s.
De adapter is via PCIe Gen5 met de GB10-chip verbonden, over twee aparte links van elk vier lanes (×4). Eén ×4-link draagt iets meer dan 100 Gb/s aan gegevens (Sectie 7.3), niet genoeg om in zijn eentje een 200 Gb/s-poort vol te houden; twee links samen kunnen dat wel. Linux ziet de adapter eenmaal per PCIe-link, zodat de ene fysieke poort twee keer verschijnt: als twee netwerkinterfaces (enp1s0f1np1 en enP2p1s0f1np1), elk met een eigen RDMA-apparaat. Beide interfaces melden een linksnelheid van 200 Gb/s, omdat ze bij dezelfde poort horen, maar elk kan alleen verplaatsen wat zijn eigen PCIe-link draagt.
NCCL, de bibliotheek die de inferentie-engine gebruikt voor de communicatie tussen de Sparks, behandelt de twee RDMA-apparaten als twee aparte netwerkpaden en verdeelt zijn verkeer over beide; alleen samen halen ze de 200 Gb/s van de poort. Dezelfde opbouw maakt het 100 Gb/s-geval van Deel II mogelijk zonder de hardware aan te raken: door NCCL tot een van de twee interfaces te beperken, wordt elke Spark beperkt tot wat één PCIe-link kan dragen.
Het verkeer tussen de Sparks gebruikt RDMA (remote direct memory access): de adapter leest gegevens uit het geheugen van de verzendende applicatie en schrijft ze rechtstreeks in het geheugen van de ontvangende applicatie, zonder dat de gegevens door de netwerkstack van het besturingssysteem gaan. Dat houdt de vertraging van elke overdracht laag. Het is ook de reden dat de gebruikelijke Linux-netwerkstatistieken dit verkeer niet tonen (Bijlage A). Hier loopt RDMA over gewoon Ethernet met RoCE v2 (RDMA over Converged Ethernet, versie 2), dat RDMA-pakketten binnen UDP/IP transporteert.
2.2. De link is het traagste pad in het systeem
200 Gb/s is 25 GB/s. Een DGX Spark leest zijn eigen geheugen met 273 GB/s, ongeveer 11 keer sneller. Alles wat het netwerk tussen Sparks moet oversteken, beweegt dus veel langzamer dan alles wat een Spark uit zijn eigen geheugen leest. Daarom bepalen de hoeveelheid gegevens die tensorparallellisme over het netwerk stuurt, en de timing daarvan, hoeveel de linksnelheid ertoe doet.
2.3. Switches en breakoutopties
De CRS804 en CRS812 hebben 400 Gb/s QSFP-DD-poorten. Een breakoutkabel splitst zo’n poort in meerdere tragere links, één per Spark:
| Switch | 400G QSFP-DD-poorten | Sparks op 200 Gb/s (2 × 200G per poort) | Sparks op 100 Gb/s (4 × 100G per poort) |
|---|---|---|---|
| MikroTik CRS812 | 2 (plus 2 × 200G QSFP56) | 4 (6 met de QSFP56-poorten) | 8 |
| MikroTik CRS804 | 4 | 8 | 16 |
Met 100 Gb/s per Spark past een cluster van 8 Sparks op een CRS812, en kan een CRS804 16 Sparks bedienen.
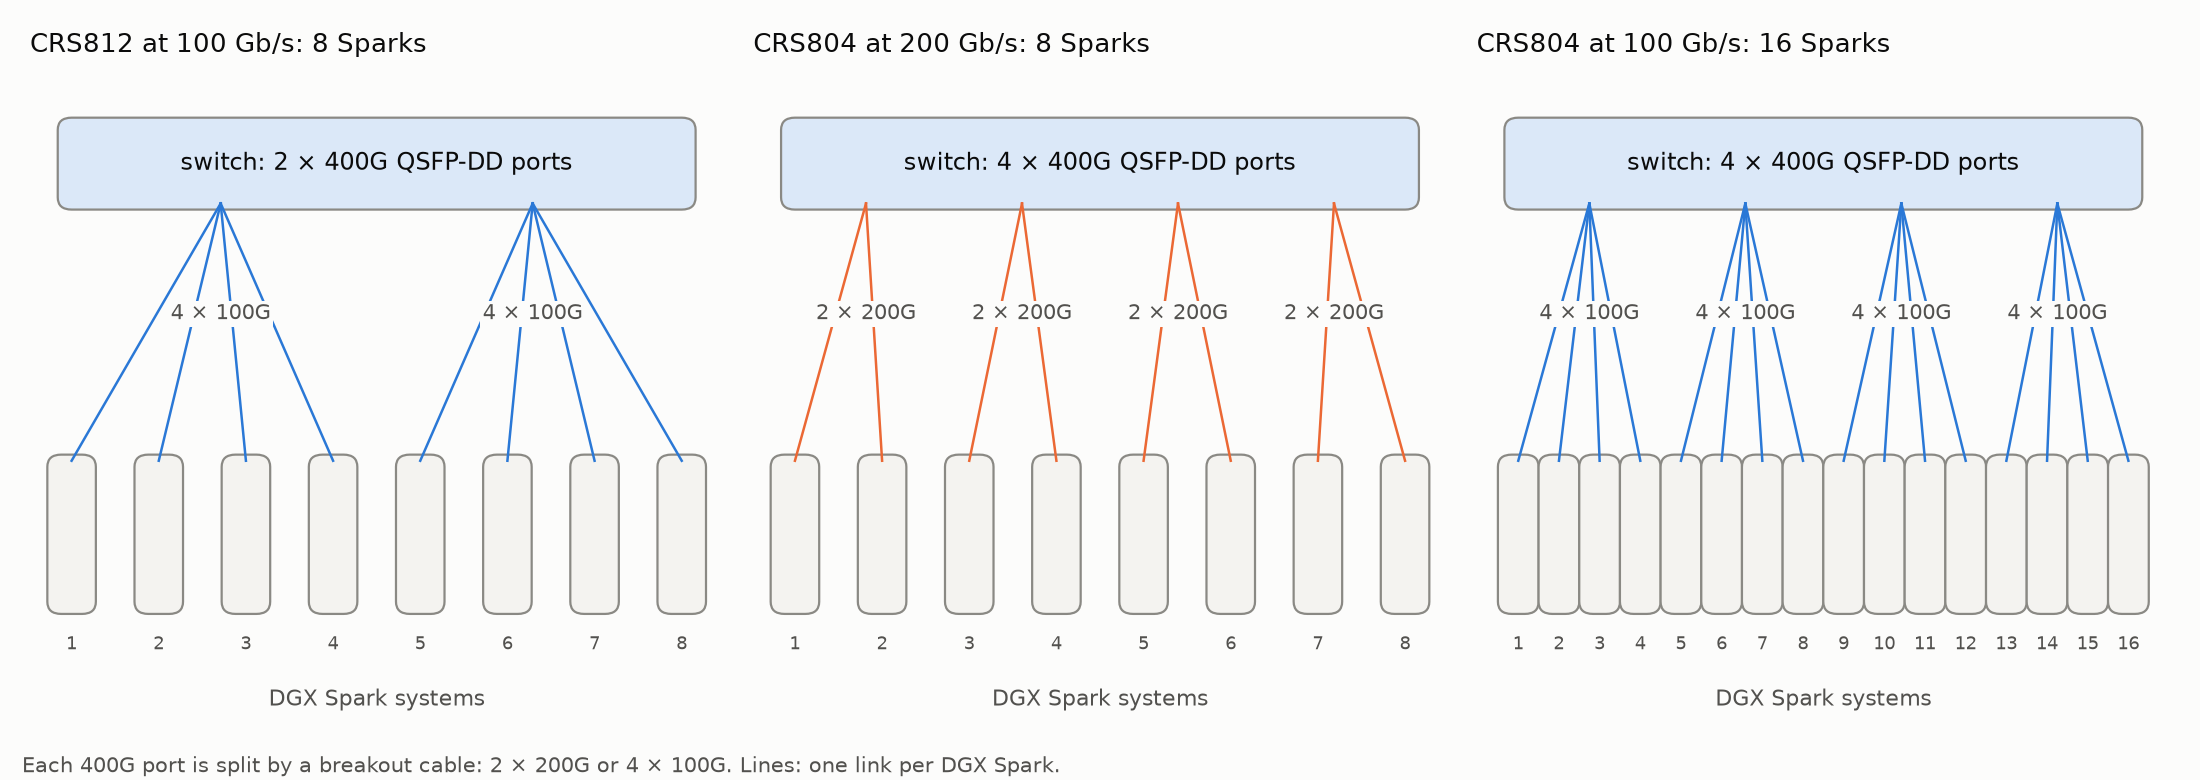
Figuur 1: Breakoutopties, één link per DGX Spark.
3. Hoe tensorparallellisme het netwerk gebruikt
3.1. Het model opsplitsen
Bij tensorparallellisme met 8 Sparks (TP8) wordt elke grote gewichtsmatrix van het model in 8 stukken gesneden, en bevat elke Spark één stuk. In de attentionblokken worden de attention-heads over de Sparks verdeeld. In de feed-forward- en Mixture-of-Experts-blokken (MoE) worden ook de matrices van elke expert opgesplitst, zodat elke Spark een deel van elke expert bevat. Elke Spark leest alleen zijn eigen achtste van de gewichten uit zijn eigen geheugen. Daardoor past een model dat groter is dan één Spark, en draait het sneller dan wanneer elke Spark alles zou moeten lezen.
3.2. Deelresultaten en de all-reduce
Een gewichtsmatrix op deze manier opsplitsen betekent dat geen enkele Spark een vermenigvuldiging alleen kan afmaken. Elke uitvoerwaarde van een laag is een lange som van producten van gewichten en invoer; met de gewichten in achten verdeeld, berekent elke Spark een achtste van die som. De betrokken waarden zijn de activaties van het model: de vectoren die elk token vertegenwoordigen terwijl het door de lagen gaat. GLM-5.3 stelt elk token voor als een vector van 6,144 waarden (zijn verborgen dimensie, hidden dimension). Voor een prompt die per 4,096 tokens tegelijk wordt verwerkt, houdt elke Spark uiteindelijk 4,096 × 6,144 deelwaarden over, oftewel 50.3 MB bij 2 bytes per waarde. Het eigenlijke resultaat is de som van de blokken van de acht Sparks, en elke Spark heeft die volledige som nodig voordat het model verder kan.
Die som maken is de taak van een all-reduce: reduce omdat de blokken worden gecombineerd (hier opgeteld), all omdat elke deelnemer het resultaat ontvangt. Een transformerlaag heeft er twee nodig, één na het attentionblok en één na het feed-forward- of MoE-blok, en er is er nog één nodig bij de input-embedding. Elke Spark wacht bij elke all-reduce tot alle acht hun bijdrage hebben geleverd, zodat het netwerk op het pad van elke laag ligt.
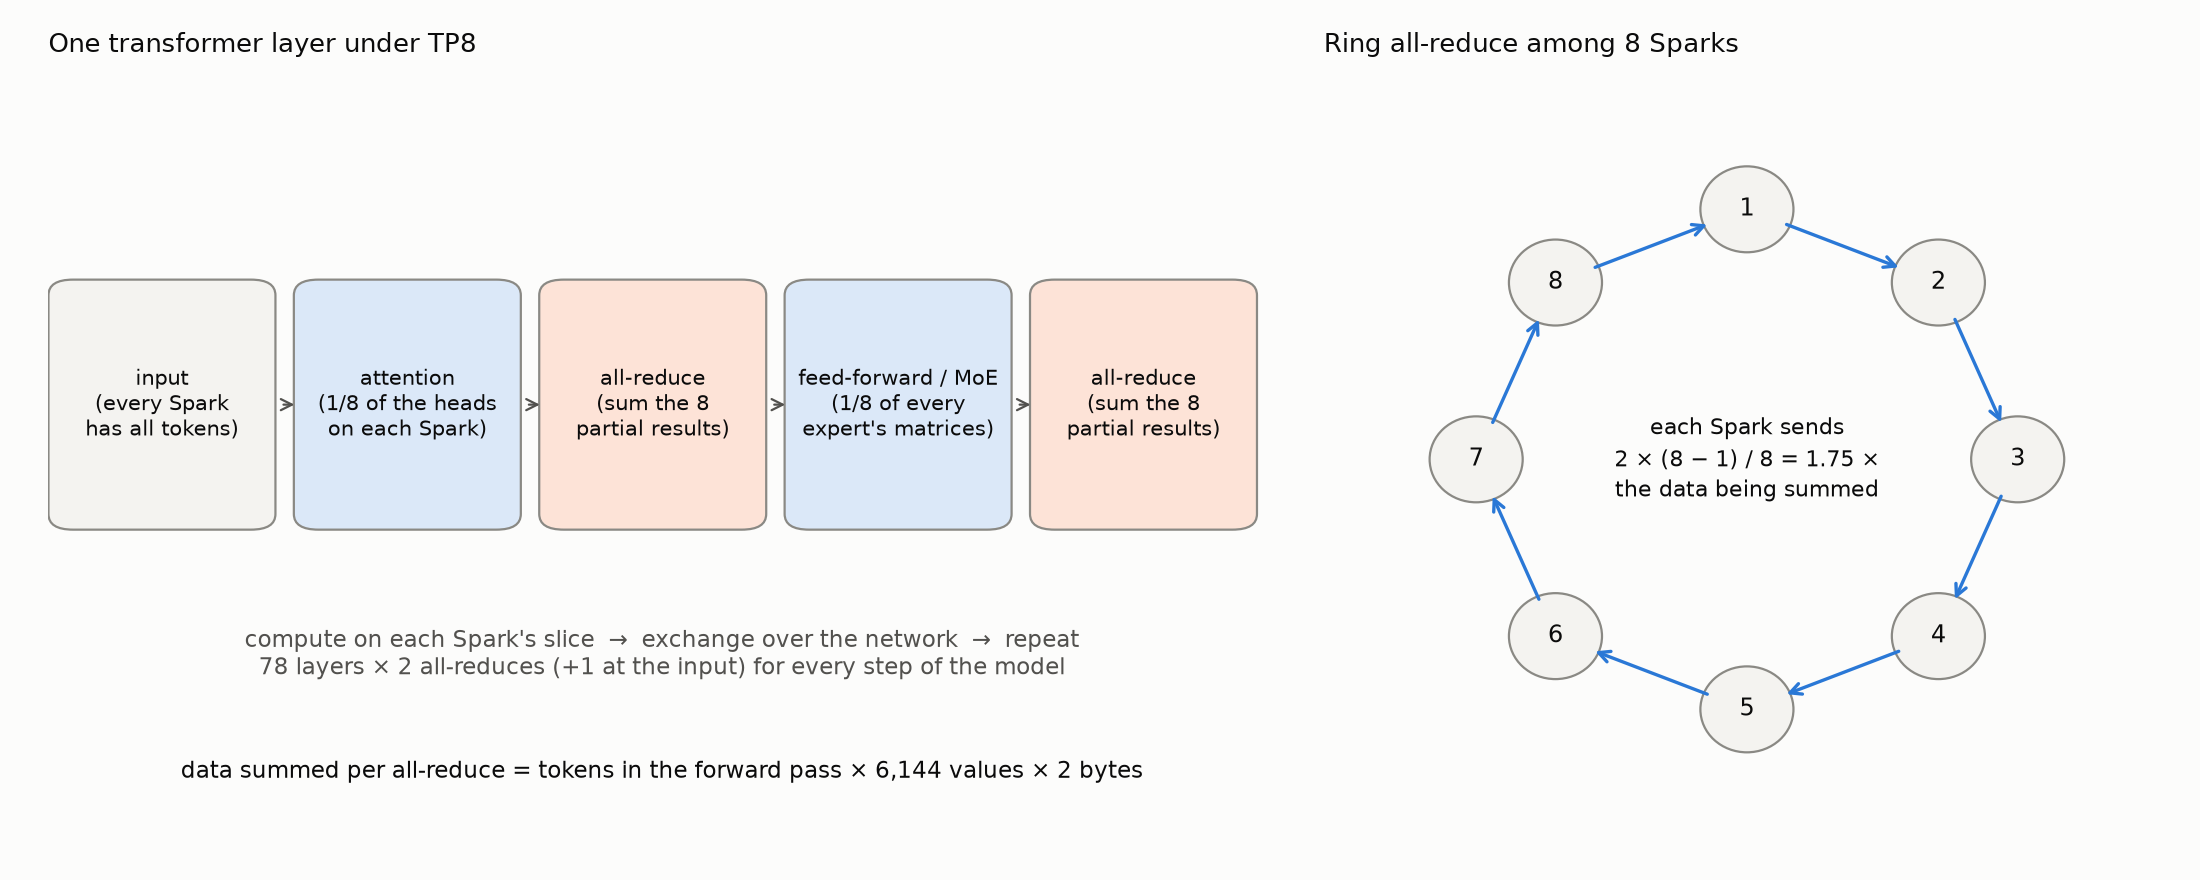
Figuur 2: Eén transformerlaag onder tensorparallellisme, en de ring-all-reduce tussen 8 Sparks.
3.3. Hoe de ring-all-reduce werkt
De directe aanpak, waarbij elke Spark zijn hele blok naar de andere zeven stuurt, zou elke Spark 7 × 50.3 MB laten versturen, en de belasting zou met elke extra Spark groeien. NCCL gebruikt in plaats daarvan meestal een ring. De Sparks worden in een cirkel gerangschikt, elk stuurt alleen naar de volgende, en elk blok wordt in evenveel segmenten gesneden als er Sparks zijn. Het werk verloopt dan in twee fasen, voor vier Sparks weergegeven in Figuur 3.
In de eerste fase, reduce-scatter, stuurt elke Spark in elke ringstap één segment naar de volgende Spark, en telt de ontvangende Spark het op bij zijn eigen kopie van dat segment. Elke Spark werkt tegelijk aan een ander segment, zodat na N − 1 ringstappen elke Spark de volledige som van precies één segment heeft. In de tweede fase, all-gather, gaan de voltooide segmenten nog een keer de ring rond, nu gekopieerd in plaats van opgeteld, tot na nog eens N − 1 ringstappen elke Spark de volledige som heeft.
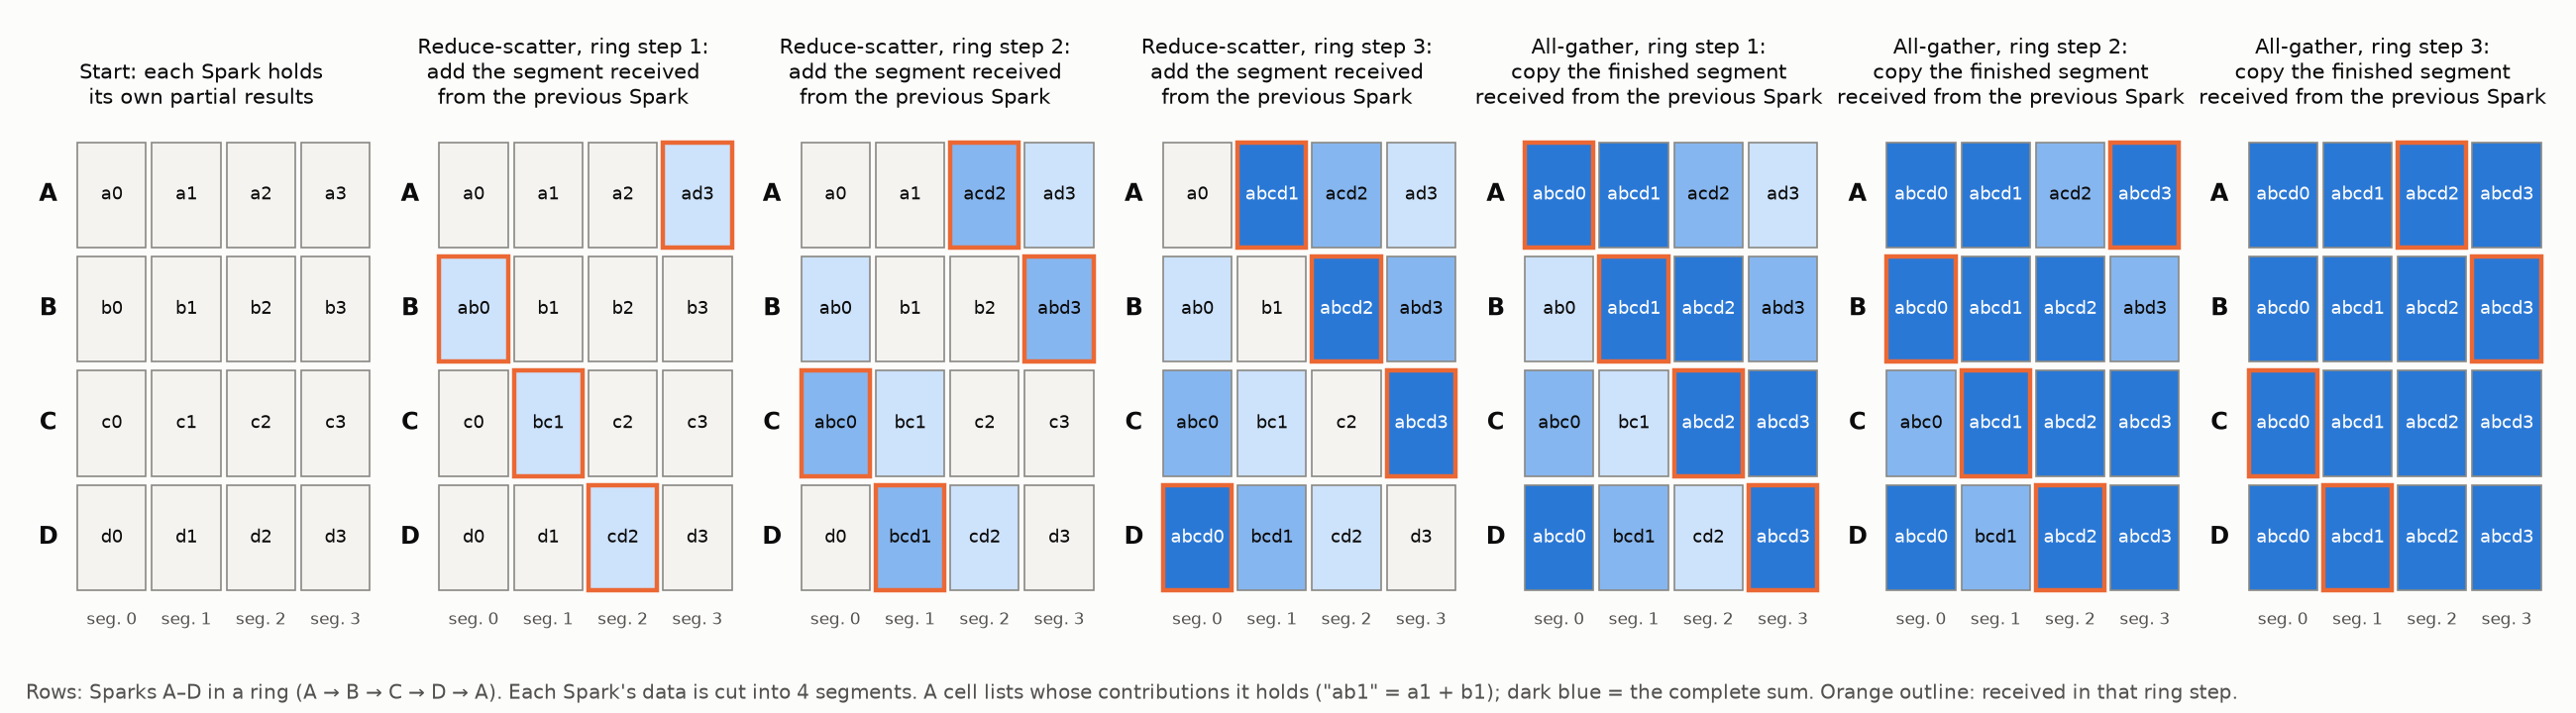
Figuur 3: Ring-all-reduce tussen vier Sparks. Na de drie reduce-scatter-stappen heeft elke Spark één volledige som; na de drie all-gather-stappen heeft elke Spark ze alle vier.
In elk van de 2 × (N − 1) ringstappen verstuurt een Spark één segment, 1/N van zijn blok. Elke Spark verstuurt dus in totaal 2 × (N − 1) / N keer het blok: 1.75× bij acht Sparks, en nooit meer dan 2×, hoeveel er ook meedoen. Voor GLM-5.3 op TP8 verstuurt elke Spark 1.75 × 50.3 MB = 88.1 MB per all-reduce, in 14 ringstappen van ongeveer 6.3 MB. Omdat elke Spark dezelfde hoeveelheid verstuurt, is het verkeer dat op één Spark wordt gemeten representatief voor alle acht.
Opgeteld over alle all-reduces in het model (78 lagen × 2, plus 1) kost elk prompttoken elke Spark
(2 × 78 + 1) × 6,144 waarden × 2 bytes × 1.75 = 3.38 MB aan netwerkverkeer.
NCCL kan andere all-reduce-algoritmen kiezen, die andere hoeveelheden versturen; Deel II toetst dit getal aan het gemeten verkeer.
3.4. Wat er verandert met het aantal Sparks
Meer Sparks verdelen het rekenwerk, maar niet de gegevens die opgeteld moeten worden. Alleen de gewichten worden opgesplitst: elke Spark berekent een deel van de som voor elke uitvoerwaarde, dus zijn blok deelwaarden blijft 4,096 × 6,144 waarden (50.3 MB), of het model nu op twee Sparks draait of op zestien. Elke verdubbeling van de TP-grootte halveert het rekenwerk per Spark, terwijl de hoeveelheid die elke Spark per all-reduce verstuurt, 2 × (N − 1) / N keer het blok, licht toeneemt:
| TP-grootte | Rekenwerk per Spark | Verstuurd per Spark per all-reduce |
|---|---|---|
| TP2 | 1/2 van het model | 1.0 × 50.3 MB = 50.3 MB |
| TP4 | 1/4 | 1.5 × 50.3 MB = 75.5 MB |
| TP8 | 1/8 | 1.75 × 50.3 MB = 88.1 MB |
| TP16 | 1/16 | 1.875 × 50.3 MB = 94.3 MB |
Van TP8 naar TP16 gaan halveert dus de tijd die elke Spark aan rekenen besteedt, maar laat de tijd die hij aan versturen besteedt vrijwel gelijk, zodat het netwerk een groter deel van elke forward pass inneemt. Sectie 6.3 werkt uit wat dit betekent voor de linksnelheid.
4. Prefill en decode: twee verschillende belastingen voor het netwerk
Inferentie verloopt in twee fasen die het netwerk op tegengestelde manieren gebruiken. Hoeveel gegevens elke all-reduce draagt, hangt af van hoeveel tokens één forward pass door het model verwerkt, en dat bepalen de instellingen van de inferentie-engine; de waarden hieronder volgen de vLLM-configuratie die in Deel II is gebruikt.
4.1. Prefill: grote overdrachten op volle linksnelheid
Tijdens prefill verwerkt vLLM de prompt in prefill-chunks van maximaal 4,096 tokens per forward pass (--max-num-batched-tokens 4096), zodat elke all-reduce het blok van 50.3 MB uit Sectie 3.2 optelt en elke Spark 88.1 MB verstuurt:
| Linksnelheid | Tijd om 88.1 MB te versturen |
|---|---|
| 200 Gb/s | 3.5 ms |
| 100 Gb/s | 7.0 ms |
Elke overdracht heeft ook een vaste overhead in software, synchronisatie en netwerkhardware. Zelfs een royale 100 µs aan zulke overhead is klein naast deze tijden: op 200 Gb/s verplaatst de link in 100 µs maar 2.5 MB, tegenover de 88.1 MB die verstuurd moeten worden. De duur van een all-reduce tijdens prefill wordt dus vrijwel geheel bepaald door hoe snel de link bytes verplaatst; met andere woorden, de communicatie tijdens prefill is bandbreedtegebonden. Tussen de all-reduces berekenen de Sparks het volgende deel van de laag, dus het prefill-verkeer hoort te verschijnen als bursts van enkele milliseconden op of bij de volle linksnelheid, gescheiden door pauzes waarin wordt gerekend. Een gehalveerde linksnelheid verdubbelt de lengte van elke burst en vertraagt het eerste token.
4.2. Decode: kleine overdrachten, gedomineerd door vaste vertragingen
Tijdens decode verwerkt elke forward pass alleen het nieuwste token van elk verzoek. Met speculatieve decodering (speculative decoding) via multi-token prediction (MTP), zoals geconfigureerd in Deel II, controleert het model in dezelfde pass ook 4 drafttokens, zodat het per verzoek 5 tokens verwerkt. Elke all-reduce telt dan 5 × 6,144 × 2 bytes = 61 KB op, waarvan elke Spark ongeveer 108 KB verstuurt. Per forward pass, inclusief het verzamelen van de tokenscores van de uitvoerlaag, verstuurt elke Spark ongeveer 18 MB.
Het versturen van 108 KB duurt 4.3 µs op 200 Gb/s en 8.7 µs op 100 Gb/s. De all-reduce doorloopt echter 14 ringstappen na elkaar, en elke stap heeft een vaste vertraging in software, synchronisatie en netwerkhardware. RDMA-overdrachten tussen twee systemen duren in de orde van microseconden, zelfs voor kleine hoeveelheden gegevens, dus deze vertragingen tellen op tot meer dan de tijd die aan het versturen van bytes wordt besteed. De communicatie tijdens decode is daarom latentiegebonden, en de duur ervan hangt weinig af van de linksnelheid.
De totale hoeveelheid decode-verkeer is ook beperkt. Elke forward pass moet minstens de actieve gewichten van het model uit het geheugen lezen. GLM-5.3 heeft ongeveer 40 miljard actieve parameters per token, grotendeels opgeslagen in NVFP4, het 4-bits floating-pointformaat van NVIDIA, met ongeveer 4.5 bits per gewicht inclusief de schaalfactoren. Dat is ongeveer 2.8 GB per Spark, wat bij 273 GB/s minstens 10 ms kost om te lezen. Zelfs als elke forward pass op die grens zou draaien, zou het decode-verkeer voor één verzoek op of onder ongeveer 14 Gb/s blijven, ver onder 100 Gb/s, en een gehalveerde link zou ten hoogste 0.7 ms toevoegen aan elke pass van 10 ms of meer. In de praktijk voegt hij veel minder toe, omdat de overdrachten latentiegebonden zijn.
Het netwerk bepaalt dus hoe snel een prompt wordt gelezen, niet hoe snel het antwoord wordt geschreven. Workloads met lange prompts, zoals retrieval-augmented generation, lange documenten of agents met grote contexten, zijn waar de linksnelheid ertoe doet. Korte chatprompts raken haar nauwelijks, en de decodesnelheid hoort helemaal niet te veranderen.
5. Het effect van een gehalveerde link schatten
5.1. De bovengrens
Als elke overdracht tijdens prefill op de volle linksnelheid loopt en geen enkele overlapt met rekenwerk, dan voegt het verlagen van de linksnelheid van B_old naar B_new precies de extra tijd toe die nodig is om dezelfde bytes te versturen:
extra prefill-tijd ≤ prefill-bytes per Spark × (1 / B_new − 1 / B_old)
Dit is een bovengrens: overdrachten die met rekenwerk overlappen of nooit de volle snelheid halen, voegen minder toe. Er zijn alleen de bytes per prompttoken uit Sectie 3.3 en de promptlengte voor nodig, en niets over hoe snel de Sparks rekenen.
Van 200 naar 100 Gb/s is (1/100 − 1/200) = 1/200, dus de extra tijd is gelijk aan de tijd die het versturen van de prefill-bytes op 200 Gb/s kost. Voor GLM-5.3 op TP8:
extra TTFT ≤ 3.38 MB × 8 bits ÷ 200 Gb/s = 0.135 s per 1,000 prompttokens
5.2. De zes testgevallen
| Test | Prompttokens | Prefill-bytes per Spark | Extra prefill-tijd, 200 → 100 Gb/s |
|---|---|---|---|
| P1: prompt van 1K, 1 verzoek | 1,024 | 3.5 GB | ≤ +0.14 s |
| P2: prompt van 8K, 1 verzoek | 8,192 | 27.7 GB | ≤ +1.11 s |
| P3: prompt van 32K, 1 verzoek | 32,768 | 110.6 GB | ≤ +4.43 s |
| P4: 4 prompts van 8K, tegelijk binnenkomend | 32,768 | 110.6 GB | ≤ +4.43 s |
| P5: prompt van 64K, 1 verzoek | 65,536 | 221.3 GB | ≤ +8.85 s |
| P6: 4 prompts van 16K, tegelijk binnenkomend | 65,536 | 221.3 GB | ≤ +8.85 s |
Voor de tests met vier verzoeken zijn de bytes die van alle vier prompts, en is de tijd die tot het laatste van de vier verzoeken zijn eerste token ontvangt.
5.3. Van seconden naar een percentage
Als aandeel van de TTFT wordt de grens
toename van de TTFT ≤ netwerkaandeel × (B_old / B_new − 1), wat voor 200 → 100 Gb/s eenvoudig ≤ netwerkaandeel is,
waarbij het netwerkaandeel de tijd is die nodig is om de prefill-bytes op 200 Gb/s te versturen, gedeeld door de prefill-tijd.
De prefill-tijd zelf is niet betrouwbaar af te leiden uit de architectuur. Een berekening op basis van het aantal rekenkundige bewerkingen en de piekrekenkracht van de GB10 zou er een orde van grootte naast zitten, omdat de werkelijke snelheid afhangt van hoe efficiënt de kernels van de engine de MoE-experts, attention en scheduling afhandelen. Het percentage heeft daarom één gemeten invoer nodig, de TTFT op 200 Gb/s, die Deel II levert.
6. Wat de vertraging groter of kleiner maakt
Omdat de vertraging ten hoogste het netwerkaandeel van de prefill-tijd is, vergroot alles wat dat aandeel vergroot ook de vertraging.
6.1. Promptlengte
Elk prompttoken kost dezelfde 3.38 MB, dus de bytes groeien evenredig met de prompt. Het matrixrekenwerk groeit ook evenredig. Attention, dat elk token vergelijkt met de tokens ervoor, groeit sneller dan de prompt in een model waarin elk token naar de hele context kijkt; daar daalt het netwerkaandeel, en daarmee de procentuele vertraging, langzaam bij zeer lange prompts. GLM-5.3 gebruikt DeepSeek Sparse Attention (DSA), waarbij elk token naar een geselecteerde set van ongeveer 2,048 eerdere tokens kijkt, zodat het rekenwerk vrijwel evenredig met de prompt blijft en de procentuele vertraging bij lange prompts ongeveer constant hoort te blijven. In seconden blijft de vertraging in beide gevallen met de promptlengte groeien.
Korte prompts zijn anders. Een prompt van 1K tokens past in één kleine prefill-chunk, en elk van zijn all-reduces verstuurt slechts ongeveer 22 MB per Spark, minder dan een milliseconde op 200 Gb/s. Zulke korte overdrachten halen mogelijk niet de volle linksnelheid, en de vaste overhead van elke forward pass weegt zwaarder, zodat de grens het effect kan overschatten.
6.2. Meerdere verzoeken tegelijk
Wanneer meerdere prompts tegelijk binnenkomen, delen hun prefill-chunks de forward passes. De bytes per prompttoken blijven gelijk, maar het rekenwerk per token daalt, omdat elke prompt over een kortere context attention berekent en het werk in vollere batches verloopt. Er gaat meer tijd naar communicatie, dus de vertraging is groter dan bij één prompt met dezelfde totale lengte. De volgorde waarin de engine de prompts verwerkt, en het moment waarop de eerste ervan beginnen met genereren, beïnvloeden ook de eigen TTFT van elk verzoek.
6.3. TP-grootte
Ten opzichte van TP8 veranderen de bytes per Spark per token en het rekenwerk per Spark als volgt:
| TP-grootte | Bytes per Spark | Rekenwerk per Spark |
|---|---|---|
| TP2 | 0.57× | 4× |
| TP4 | 0.86× | 2× |
| TP8 | 1× | 1× |
| TP16 | 1.07× | 0.5× |
Het netwerkaandeel, en daarmee de vertraging, groeit snel met de TP-grootte: een lagere linksnelheid is het makkelijkst te accepteren bij kleine TP-groottes en kost meer naarmate een model over meer Sparks wordt verdeeld. Sectie 10 zet hier getallen bij op basis van de gemeten TP8-basislijn.
Deel II: Meting
7. Testopzet
7.1. Alleen de link veranderen
De vergelijking is alleen bruikbaar als de linksnelheid het enige verschil tussen de twee configuraties is. In beide werden hetzelfde model, dezelfde engine, dezelfde instellingen, dezelfde prompts en hetzelfde testplan gebruikt; alleen het netwerkpad veranderde.
7.2. Opstelling
| Onderdeel | Waarde |
|---|---|
| Systemen | 8× NVIDIA DGX Spark (GB10, 128 GB unified memory), driver 580.173.02 |
| Switch | MikroTik CRS804, 400G QSFP-DD-poorten in 2 × 200G-breakout |
| Model | GLM-5.3 NVFP4 (Inferact/GLM-5.3-NVFP4): MoE met 753B parameters, ongeveer 40B actief per token; verborgen dimensie 6,144; 78 lagen; DeepSeek Sparse Attention |
| Engine | vLLM 0.1.dev20133+gb5f995e73 (container vllm-node-b12x), PyTorch 2.13, NCCL 2.28.3, Ray |
| Parallellisme | TP8: één modelinstantie over alle 8 Sparks |
| Belangrijkste instellingen | prefill-chunks van maximaal 4,096 tokens, FP8-KV-cache, speculatieve decodering met MTP (4 drafttokens; het draftmodel wordt niet over de Sparks verdeeld en voegt dus geen netwerkverkeer toe), CUDA graphs, maximaal 8 gelijktijdige verzoeken |
GLM-5.3 is een groot MoE-model dat alle 8 Sparks nodig heeft, en dat is precies het geval waarin het clusternetwerk het meest uitmaakt.
7.3. 100 Gb/s emuleren
Het 100 Gb/s-geval werd geëmuleerd in plaats van met nieuwe kabels opgebouwd: NCCL werd zo geconfigureerd dat het op elke Spark maar een van de twee netwerkinterfaces gebruikte (NCCL_IB_HCA zonder het tweede RDMA-apparaat). Er verandert niets fysiek, dus de kabels, switchpoorten en alle andere instellingen blijven gelijk, en het model opnieuw starten zonder deze instelling herstelt 200 Gb/s. In elke geëmuleerde run bevestigde de benchmark aan de hand van de tellers van de adapter dat al het verkeer over de ene overgebleven interface ging.
Eén interface draagt wat zijn PCIe Gen5 ×4-link toelaat: 4 lanes × 32 GT/s, door lijncodering (128b/130b) teruggebracht tot 126 Gb/s en door de overhead van PCIe-pakketten en flow control tot ongeveer 111 Gb/s. Gemeten met ib_write_bw draagt één interface 109 Gb/s. De geëmuleerde link is dus ongeveer 9% sneller dan een echte 100 Gb/s-link.
Met B_new = 109 Gb/s in plaats van 100 wordt de grens van Sectie 5.1
extra prefill-tijd ≤ prefill-bytes × (1/109 − 1/200), ongeveer 0.11 s per 1,000 prompttokens voor GLM-5.3 op TP8
| Test | Schatting, 200 → 100 Gb/s (Sectie 5.2) | Schatting, 200 → 109 Gb/s (dit experiment) |
|---|---|---|
| P1: 1K | ≤ +0.14 s | ≤ +0.12 s |
| P2: 8K | ≤ +1.11 s | ≤ +0.92 s |
| P3: 32K | ≤ +4.43 s | ≤ +3.69 s |
| P4: 4 × 8K | ≤ +4.43 s | ≤ +3.69 s |
| P5: 64K | ≤ +8.85 s | ≤ +7.39 s |
| P6: 4 × 16K | ≤ +8.85 s | ≤ +7.39 s |
Sectie 9 rekent de gemeten resultaten terug naar een echte 100 Gb/s-kabel.
7.4. Testplan
| Test | Verzoeken | Prompt → uitvoertokens | Doel |
|---|---|---|---|
| P1 | 1 | 1,024 → 1,024 | een korte prompt, met kleine overdrachten |
| P2 | 1 | 8,192 → 1,024 | een typische lange prompt |
| P3 | 1 | 32,768 → 1,024 | een lang document |
| P4 | 4, tegelijk binnenkomend | 4 × 8,192 → 1,024 | meerdere verzoeken, dezelfde totale promptgrootte als P3 |
| P5 | 1 | 65,536 → 1,024 | een zeer lange prompt |
| P6 | 4, tegelijk binnenkomend | 4 × 16,384 → 1,024 | meerdere verzoeken, dezelfde totale promptgrootte als P5 |
Elke test liep één opwarmronde, die niet meetelt, en drie meetrondes. De uitvoer lag vast op precies 1,024 tokens, zodat elk verzoek evenveel decodewerk deed en de decodesnelheden direct vergelijkbaar zijn.
7.5. Wat er werd gemeten
- TTFT (time to first token): de tijd van het versturen van een verzoek tot het ontvangen van zijn eerste token. Voor P4 en P6 wordt ook de tijd gerapporteerd tot het laatste van de vier verzoeken zijn eerste token ontvangt; die omvat de bytes van alle vier prompts en is de grootheid die de schatting beschrijft.
- Decodesnelheid: hoe snel het antwoord stroomt, in tokens per seconde na het eerste token: (uitvoertokens − 1) ÷ (tijd van het laatste token − tijd van het eerste token). Een tokens-per-secondecijfer dat deelt door de hele verzoektijd, inclusief TTFT, wordt niet gebruikt voor vergelijkingen van decode, omdat het bij lange prompts daalt, ook wanneer de decodesnelheid niet verandert.
- Netwerkverkeer: bytes en snelheden uit de RDMA-tellers van de ConnectX-7 van één Spark (Bijlage A). Bij een ring-all-reduce verstuurt elke Spark dezelfde hoeveelheid, dus één Spark is representatief voor alle acht.
7.6. De runs vergelijkbaar houden
De prompts kwamen uit een vaste promptset en werden met een vaste random seed aangevuld tot de doellengte, zodat beide configuraties identieke prompts kregen. De aanvulling van elk verzoek was anders geordend, zodat de engine geen werk kon hergebruiken dat van een eerder verzoek in de cache stond. Diensten die niet voor de test nodig waren, werden op alle Sparks gestopt, en elke run begon pas nadat de link 10 seconden geen verkeer had gedragen. Verzoeken en verkeersmetingen kregen hun tijdstempel op dezelfde Spark en dezelfde klok, zodat het verkeer van de prefill en de decode van elk verzoek exact te scheiden is.
Alle meetrondes worden gebruikt en gerapporteerd als gemiddelden, met de spreiding over de rondes. De rondes waren consistent: binnen een test varieerden de prefill-tijden met ten hoogste 0.6 s voor afzonderlijke verzoeken en 1.2 s voor vier verzoeken.
8. Resultaten: 200 Gb/s versus geëmuleerde 100 Gb/s op TP8
8.1. Hoeveel van de 200 Gb/s het cluster gebruikt
Figuur 4 toont het verkeer dat één Spark verstuurt tijdens één verzoek van 8K tokens op het 200 Gb/s-cluster. Tijdens prefill wisselen bursts van enkele milliseconden bij de volle linksnelheid af met pauzes waarin de Sparks rekenen, zoals Sectie 4.1 beschrijft; in de inzoom van 200 ms is elke burst één all-reduce van de prefill. Na het eerste token is het decode-verkeer laag en gelijkmatig.
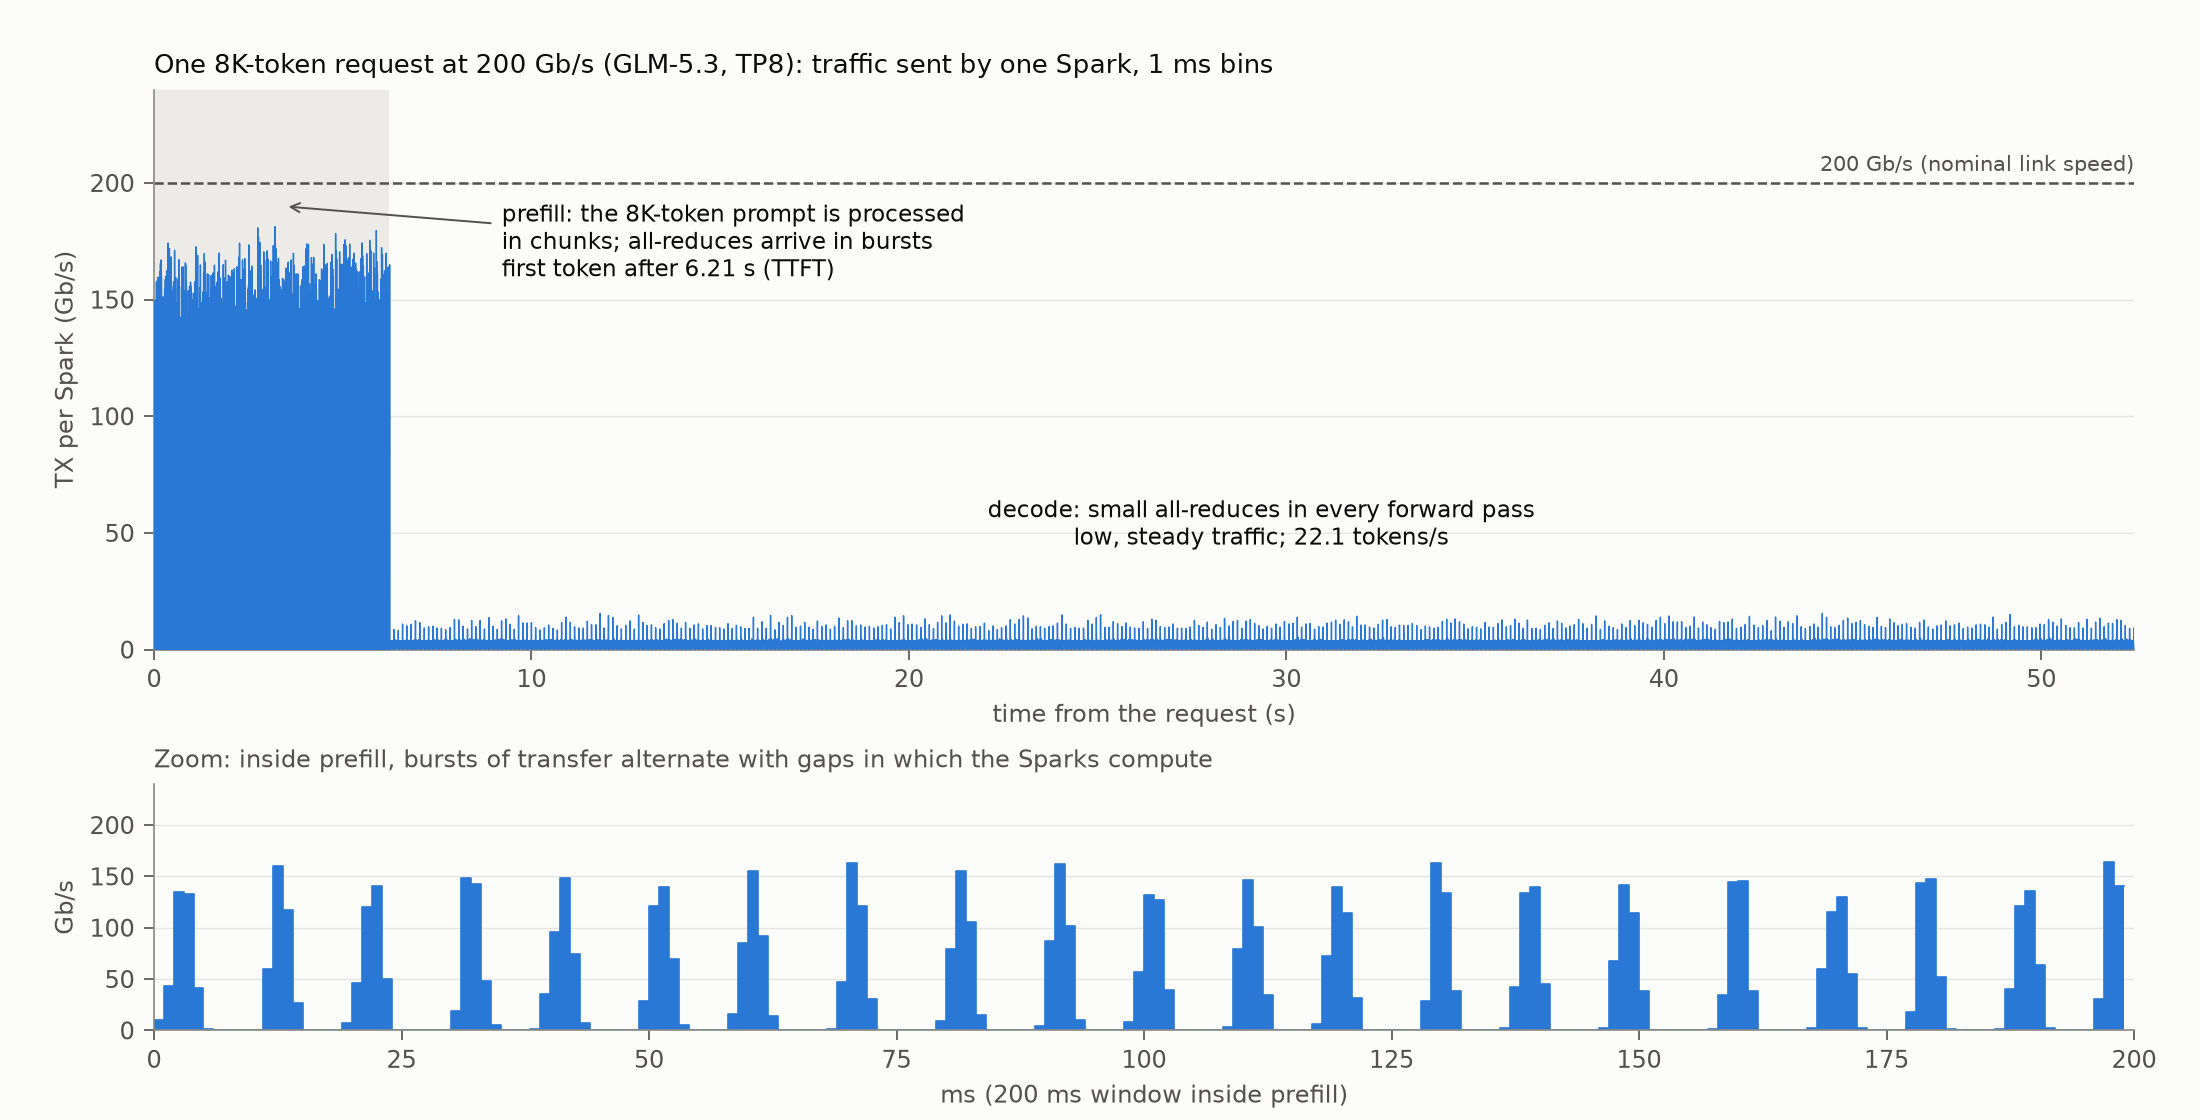
Figuur 4: Eén verzoek van 8K tokens op 200 Gb/s, verkeer verstuurd door één Spark in intervallen van 1 ms; daaronder een venster van 200 ms binnen de prefill.
Gemeten in intervallen van 1 ms bereiken de bursts van afzonderlijke prompts van 8K–64K ongeveer 150–180 Gb/s, en die van vier tegelijk binnenkomende prompts bijna 200 Gb/s. Gemiddeld over een hele prefill van 8K is het verkeer echter 37 Gb/s, omdat de link niets draagt terwijl de Sparks rekenen. Decode komt gemiddeld uit op ongeveer 3 Gb/s voor één verzoek en ongeveer 6 Gb/s voor vier, binnen de grenzen die in Sectie 4.2 zijn geschat. Het cluster gebruikt de volle 200 Gb/s, maar telkens slechts enkele milliseconden.
Het middelingsinterval bepaalt welk van deze twee beelden een meting laat zien. Dezelfde prefill van 8K geeft deze hoogste waarden:
| Middelingsinterval | Hoogste waarde |
|---|---|
| 1 ms | 181 Gb/s |
| 5 ms | 96 Gb/s |
| 100 ms | 44 Gb/s |
| 1 s | 40 Gb/s |
| hele prefill (gemiddelde) | 37 Gb/s |
Een switch die gemiddelden per seconde rapporteert, zou ongeveer 40 Gb/s laten zien en een vrijwel ongebruikte link suggereren. De bursts die de TTFT bepalen, zijn alleen zichtbaar met een resolutie van een milliseconde (Bijlage A).
8.2. Het verkeer in elke test
Figuren 5–10 tonen het verkeer dat één Spark verstuurt tijdens de drie meetrondes van elke test, met 200 Gb/s bovenaan en de geëmuleerde 100 Gb/s eronder, op dezelfde tijdas. De grijze band is de prefill, die eindigt bij het eerste token.
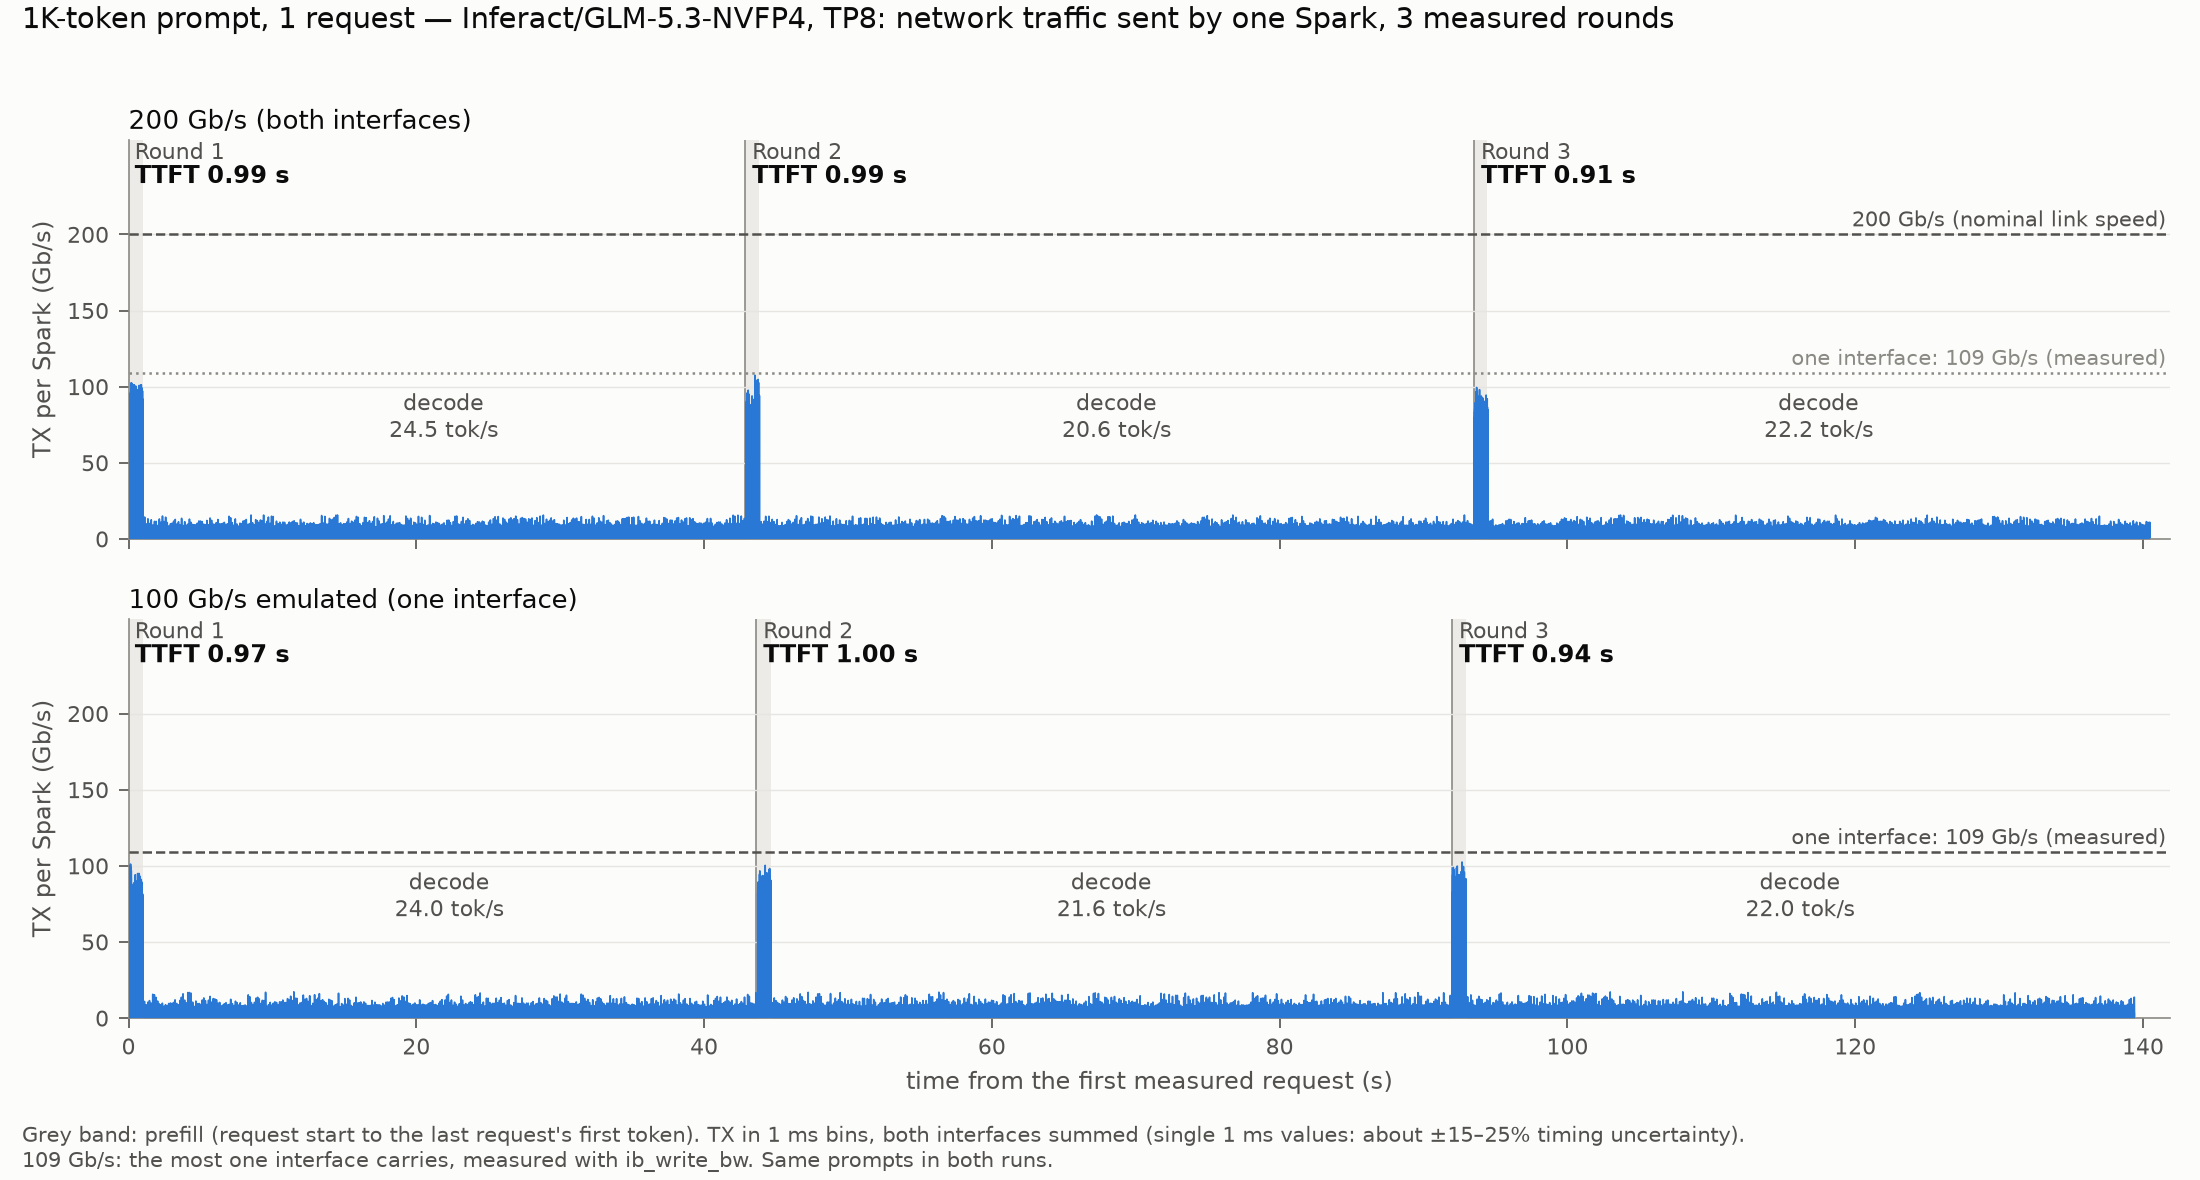
Figuur 5: P1, prompt van 1K tokens, 1 verzoek.
Bij een prompt van 1K bereiken de prefill-bursts zelfs op het 200 Gb/s-cluster maar ongeveer 100 Gb/s, minder dan wat één interface kan dragen, dus de geëmuleerde link vertraagt ze niet. De TTFT is bij beide linksnelheden gelijk: 0.96 s en 0.97 s.
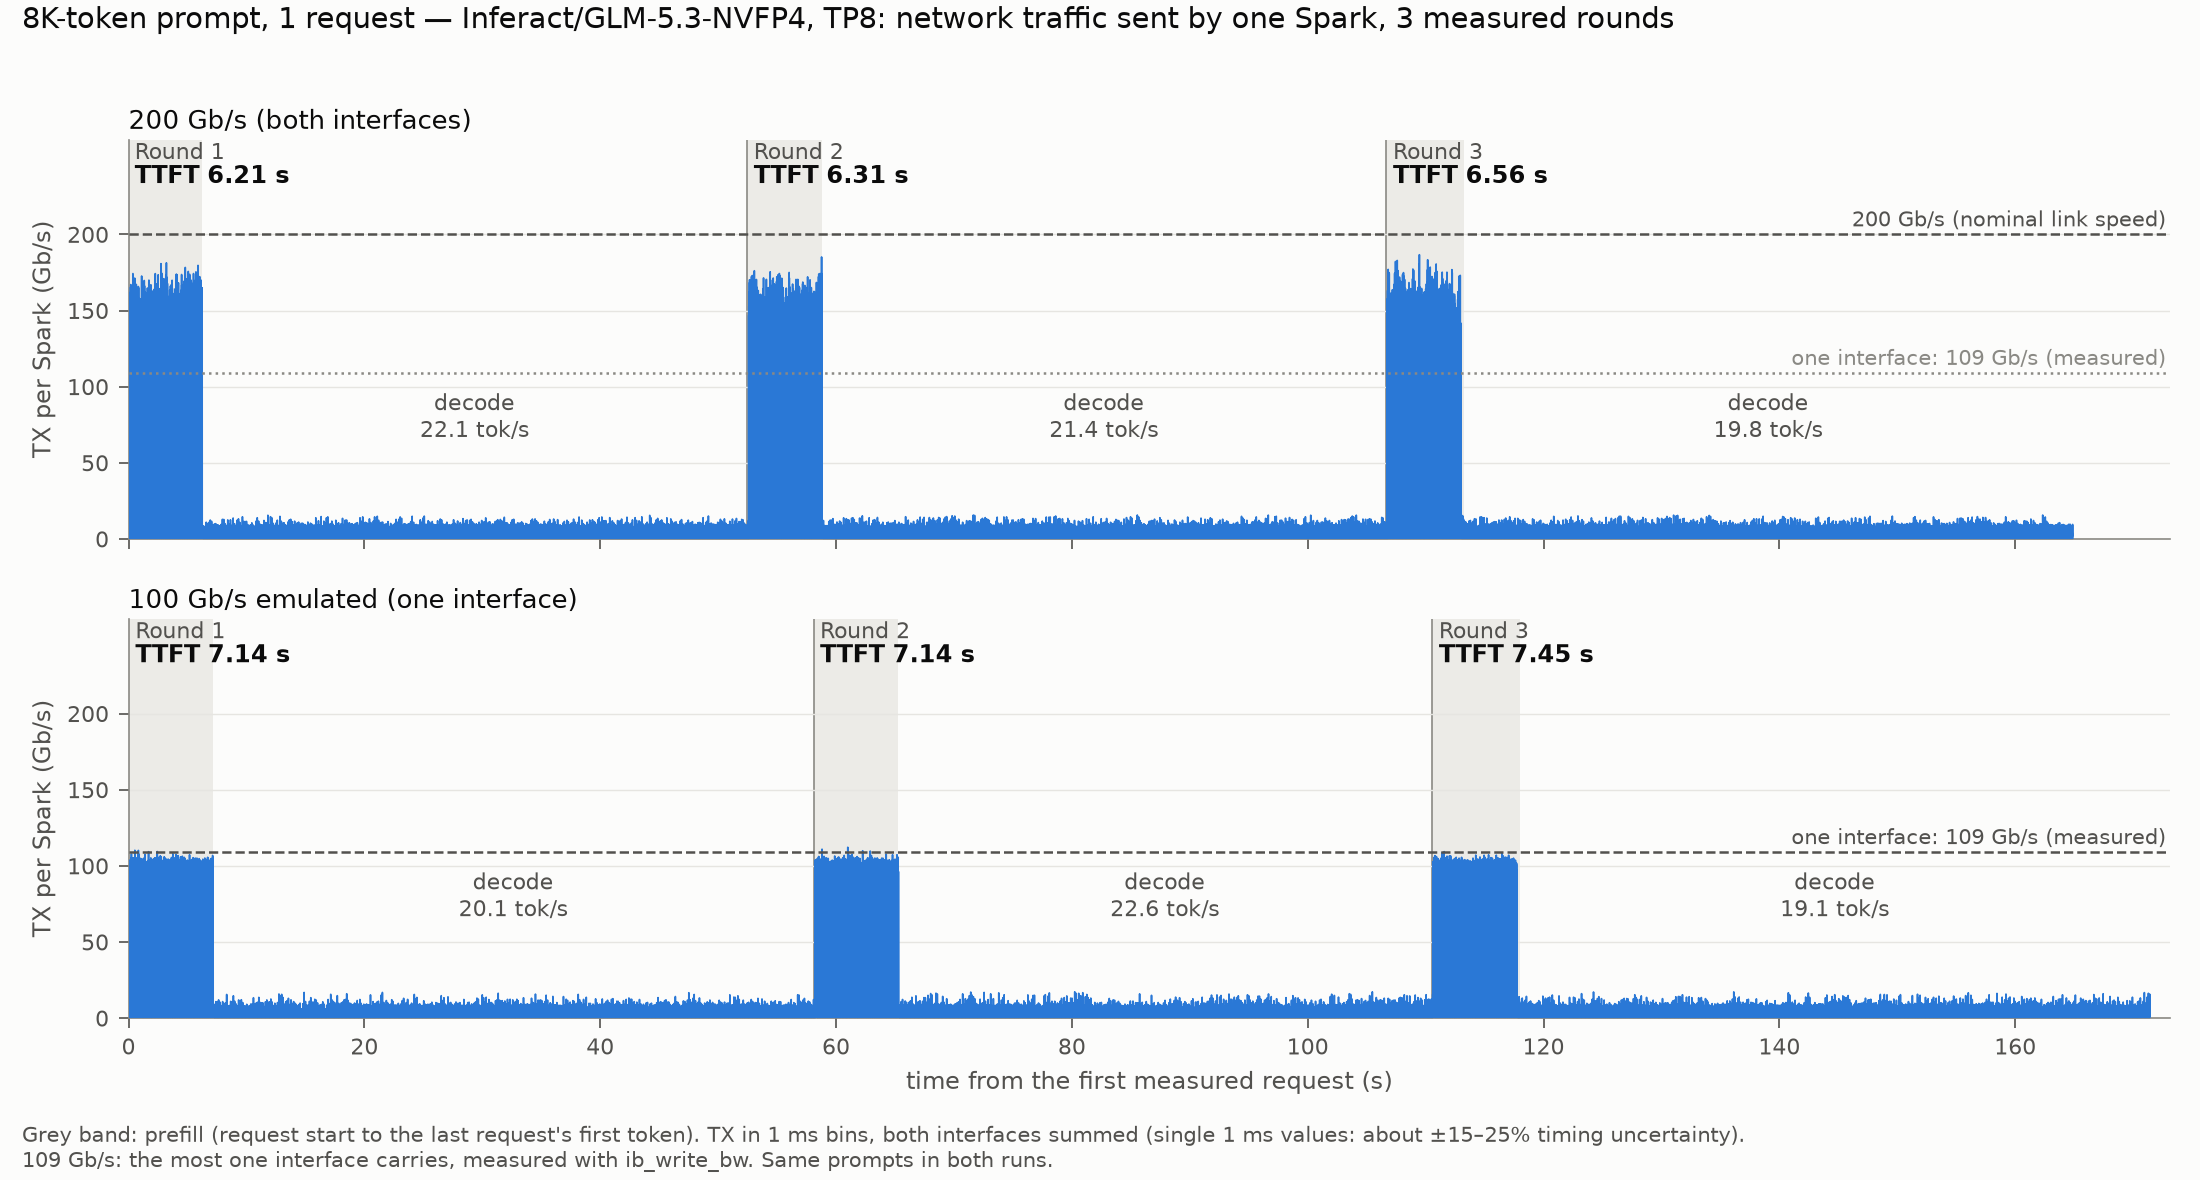
Figuur 6: P2, prompt van 8K tokens, 1 verzoek.
Bij een prompt van 8K loopt de prefill op 200 Gb/s met ongeveer 150–180 Gb/s. Op de geëmuleerde link worden dezelfde bursts op ongeveer 105–109 Gb/s gehouden en duren ze langer, en de TTFT stijgt van 6.36 s naar 7.24 s. Het decode-verkeer ziet er in beide panelen hetzelfde uit.
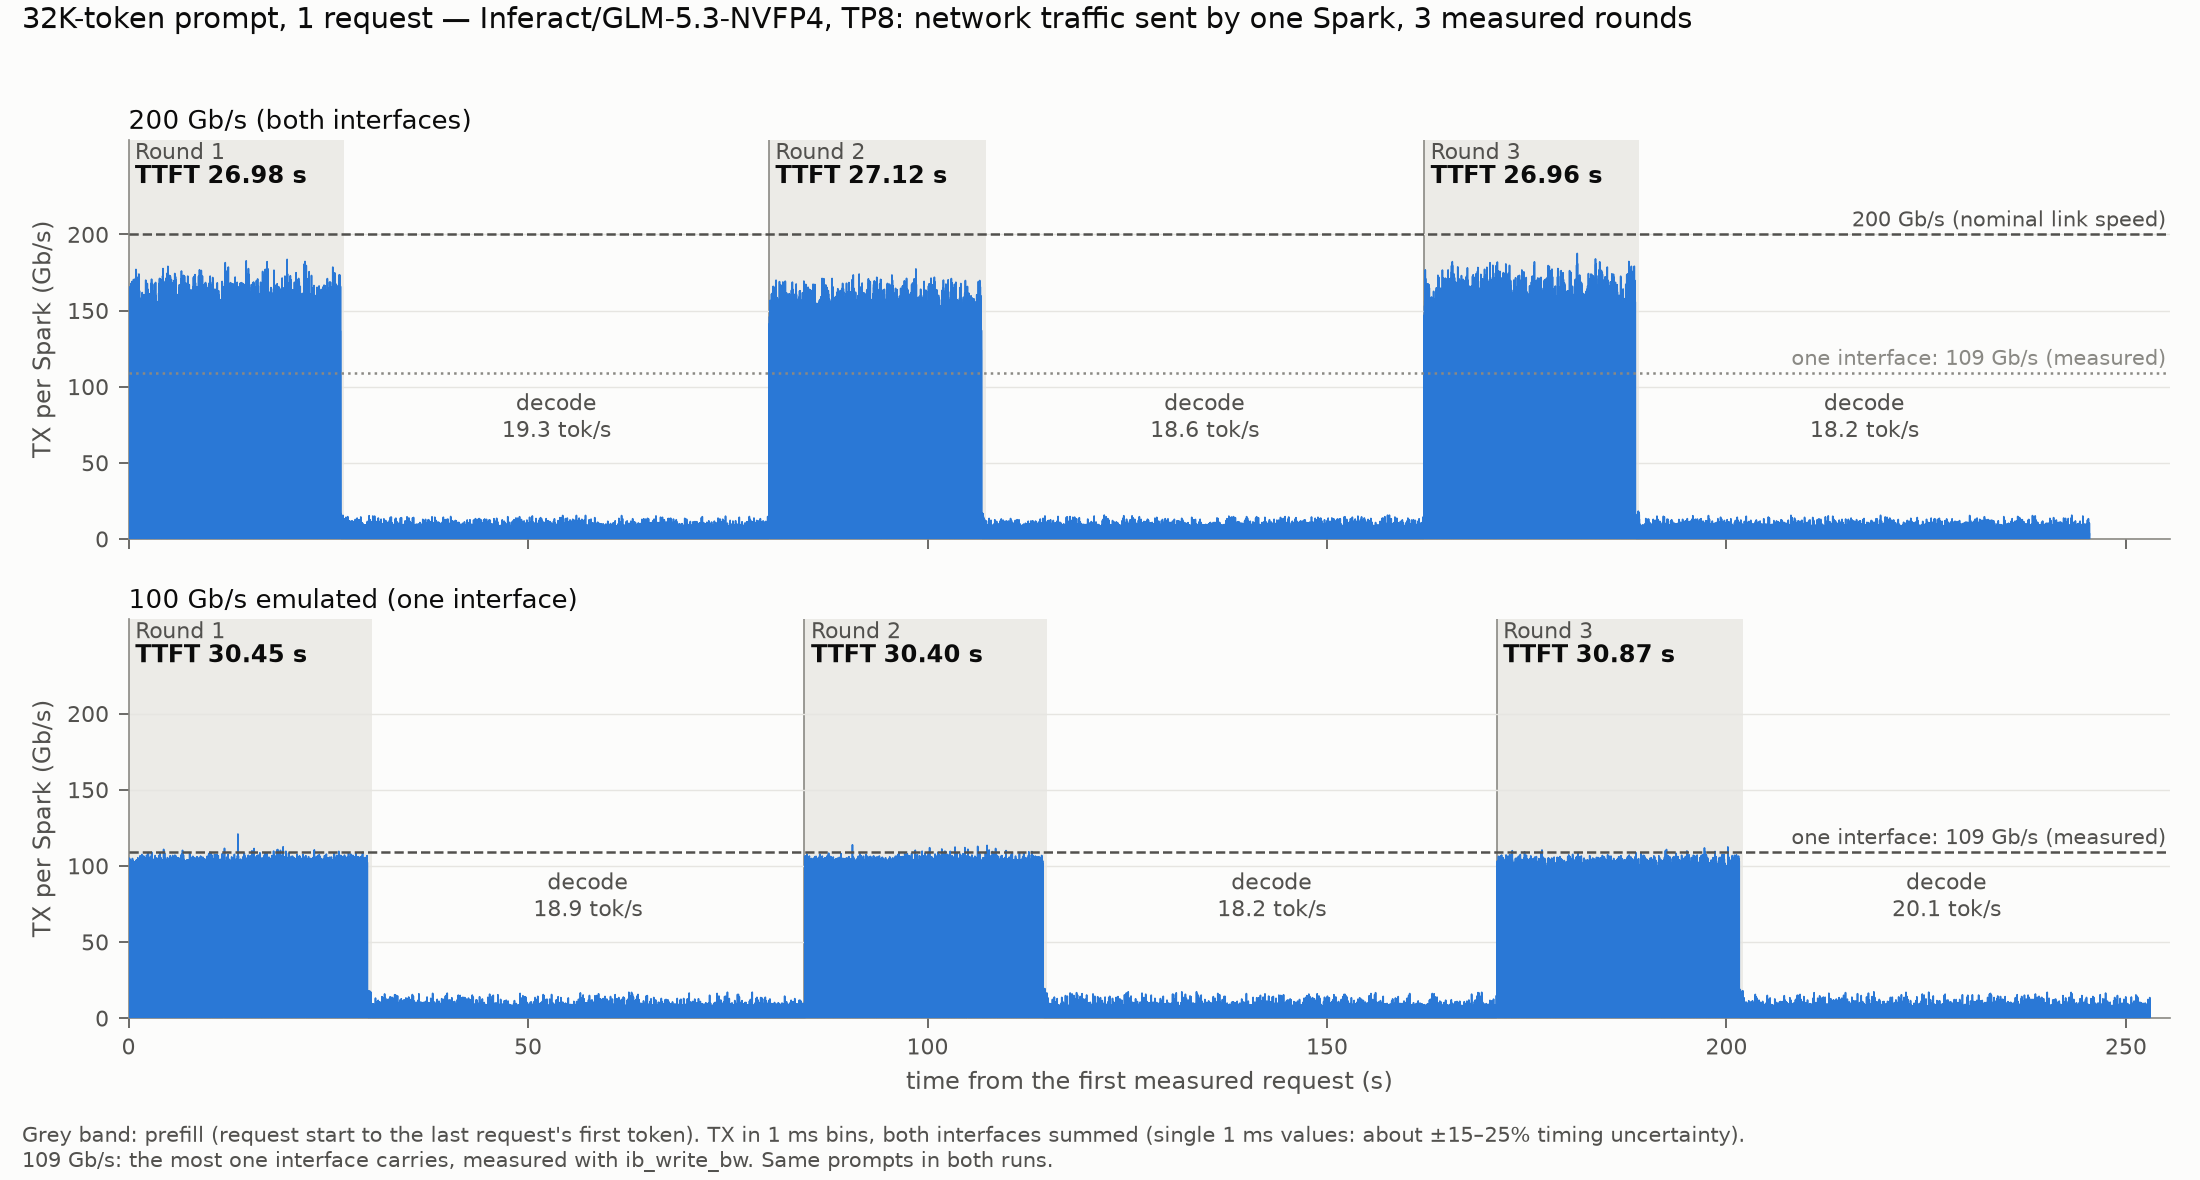
Figuur 7: P3, prompt van 32K tokens, 1 verzoek.
De prompt van 32K toont hetzelfde patroon over een langere prefill, waarbij de TTFT stijgt van 27.0 s naar 30.6 s.
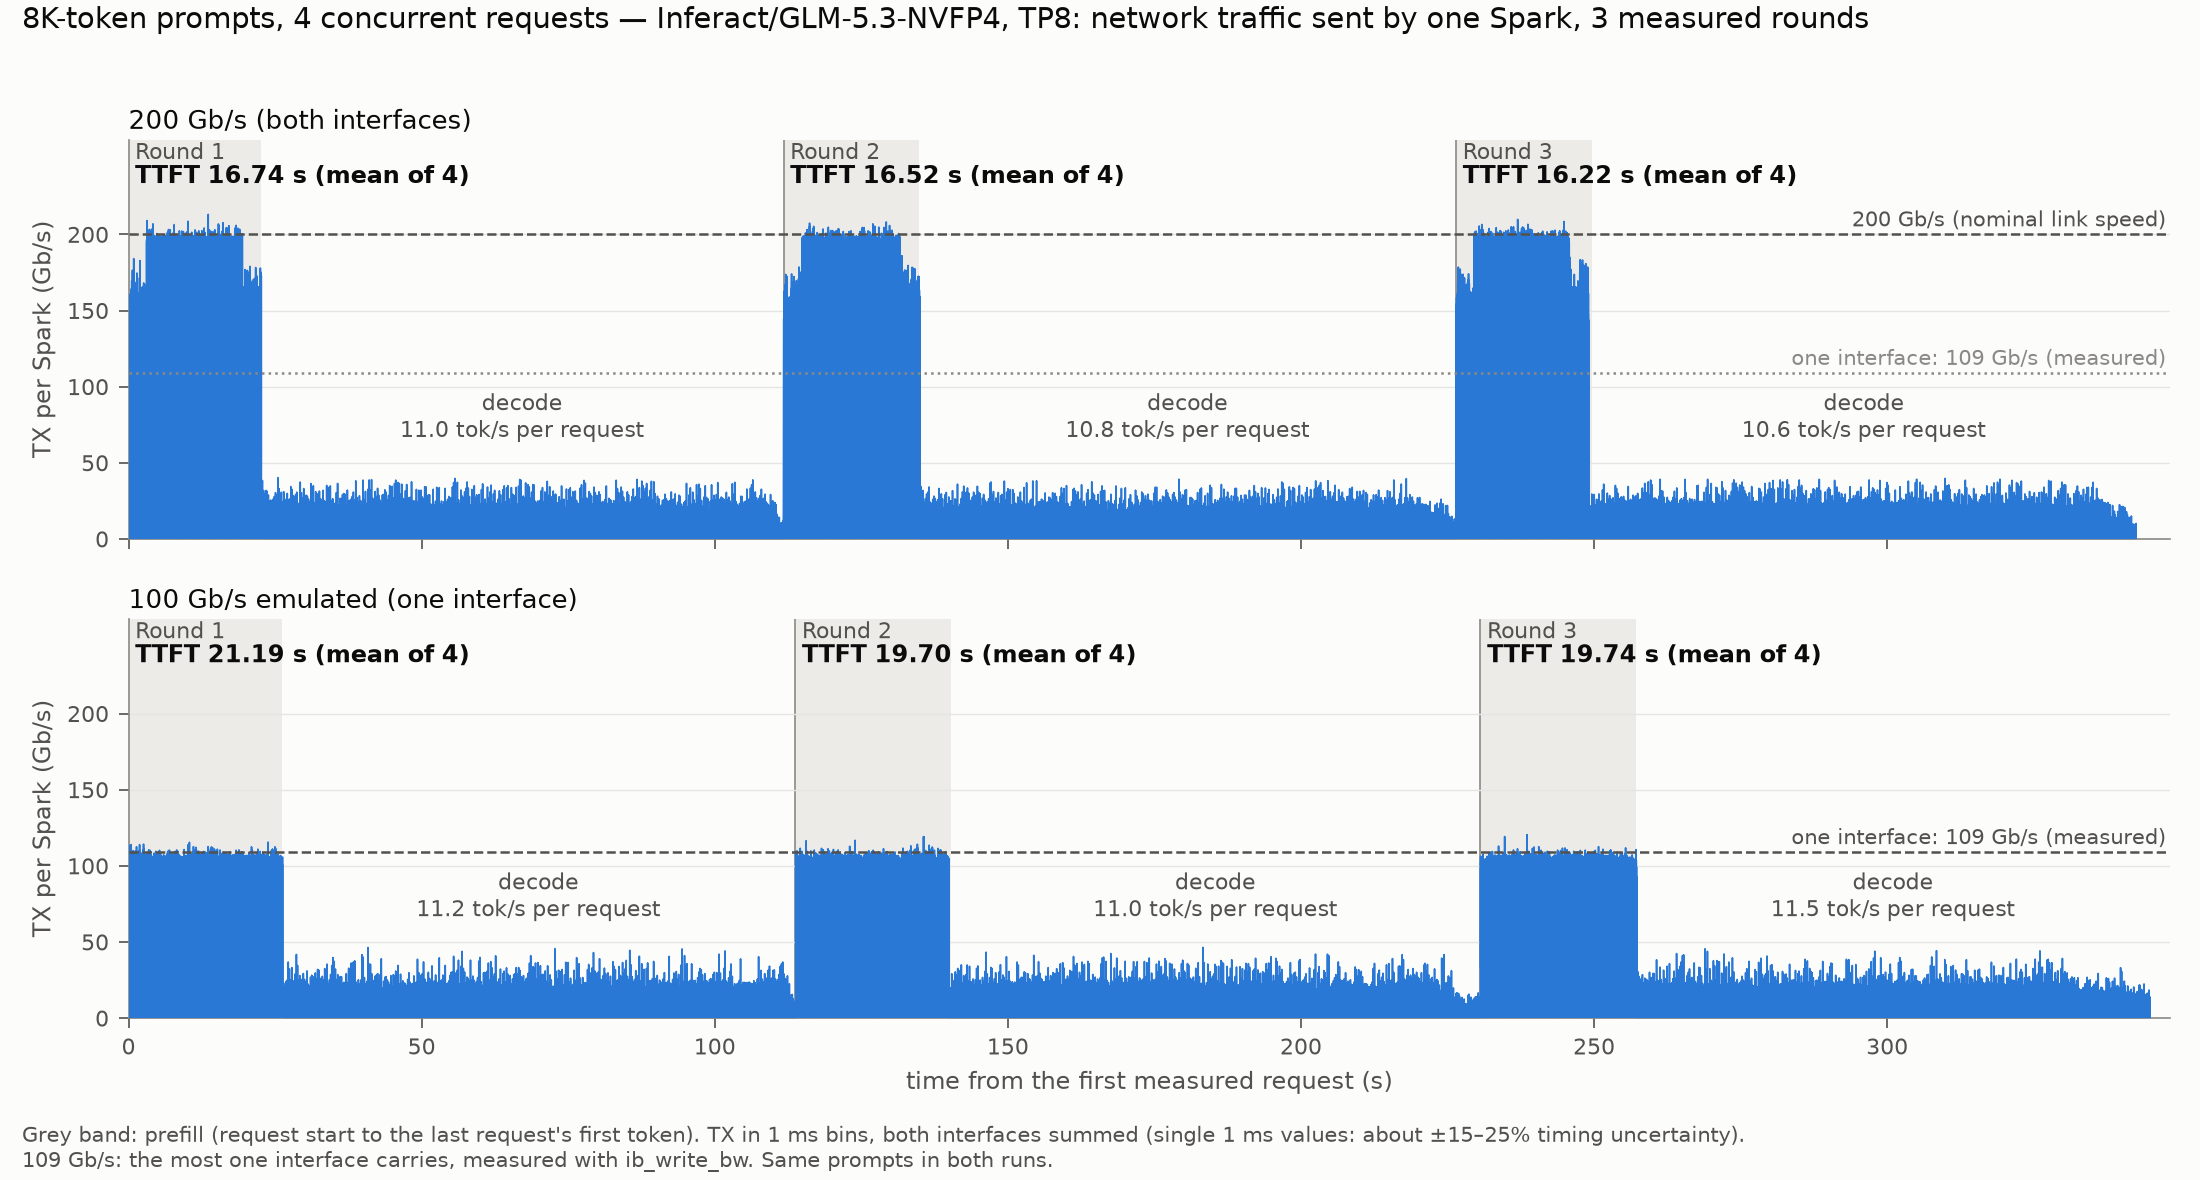
Figuur 8: P4, vier prompts van 8K tokens die tegelijk binnenkomen.
Wanneer vier prompts tegelijk binnenkomen, houdt de prefill de 200 Gb/s-link bijna volledig bezet, terwijl de geëmuleerde link de hele tijd op 109 Gb/s blijft. De tijd tot het laatste eerste token stijgt van 23.0 s naar 26.4 s. Het decode-verkeer is met vier verzoeken hoger, maar nog steeds ver onder beide linksnelheden.
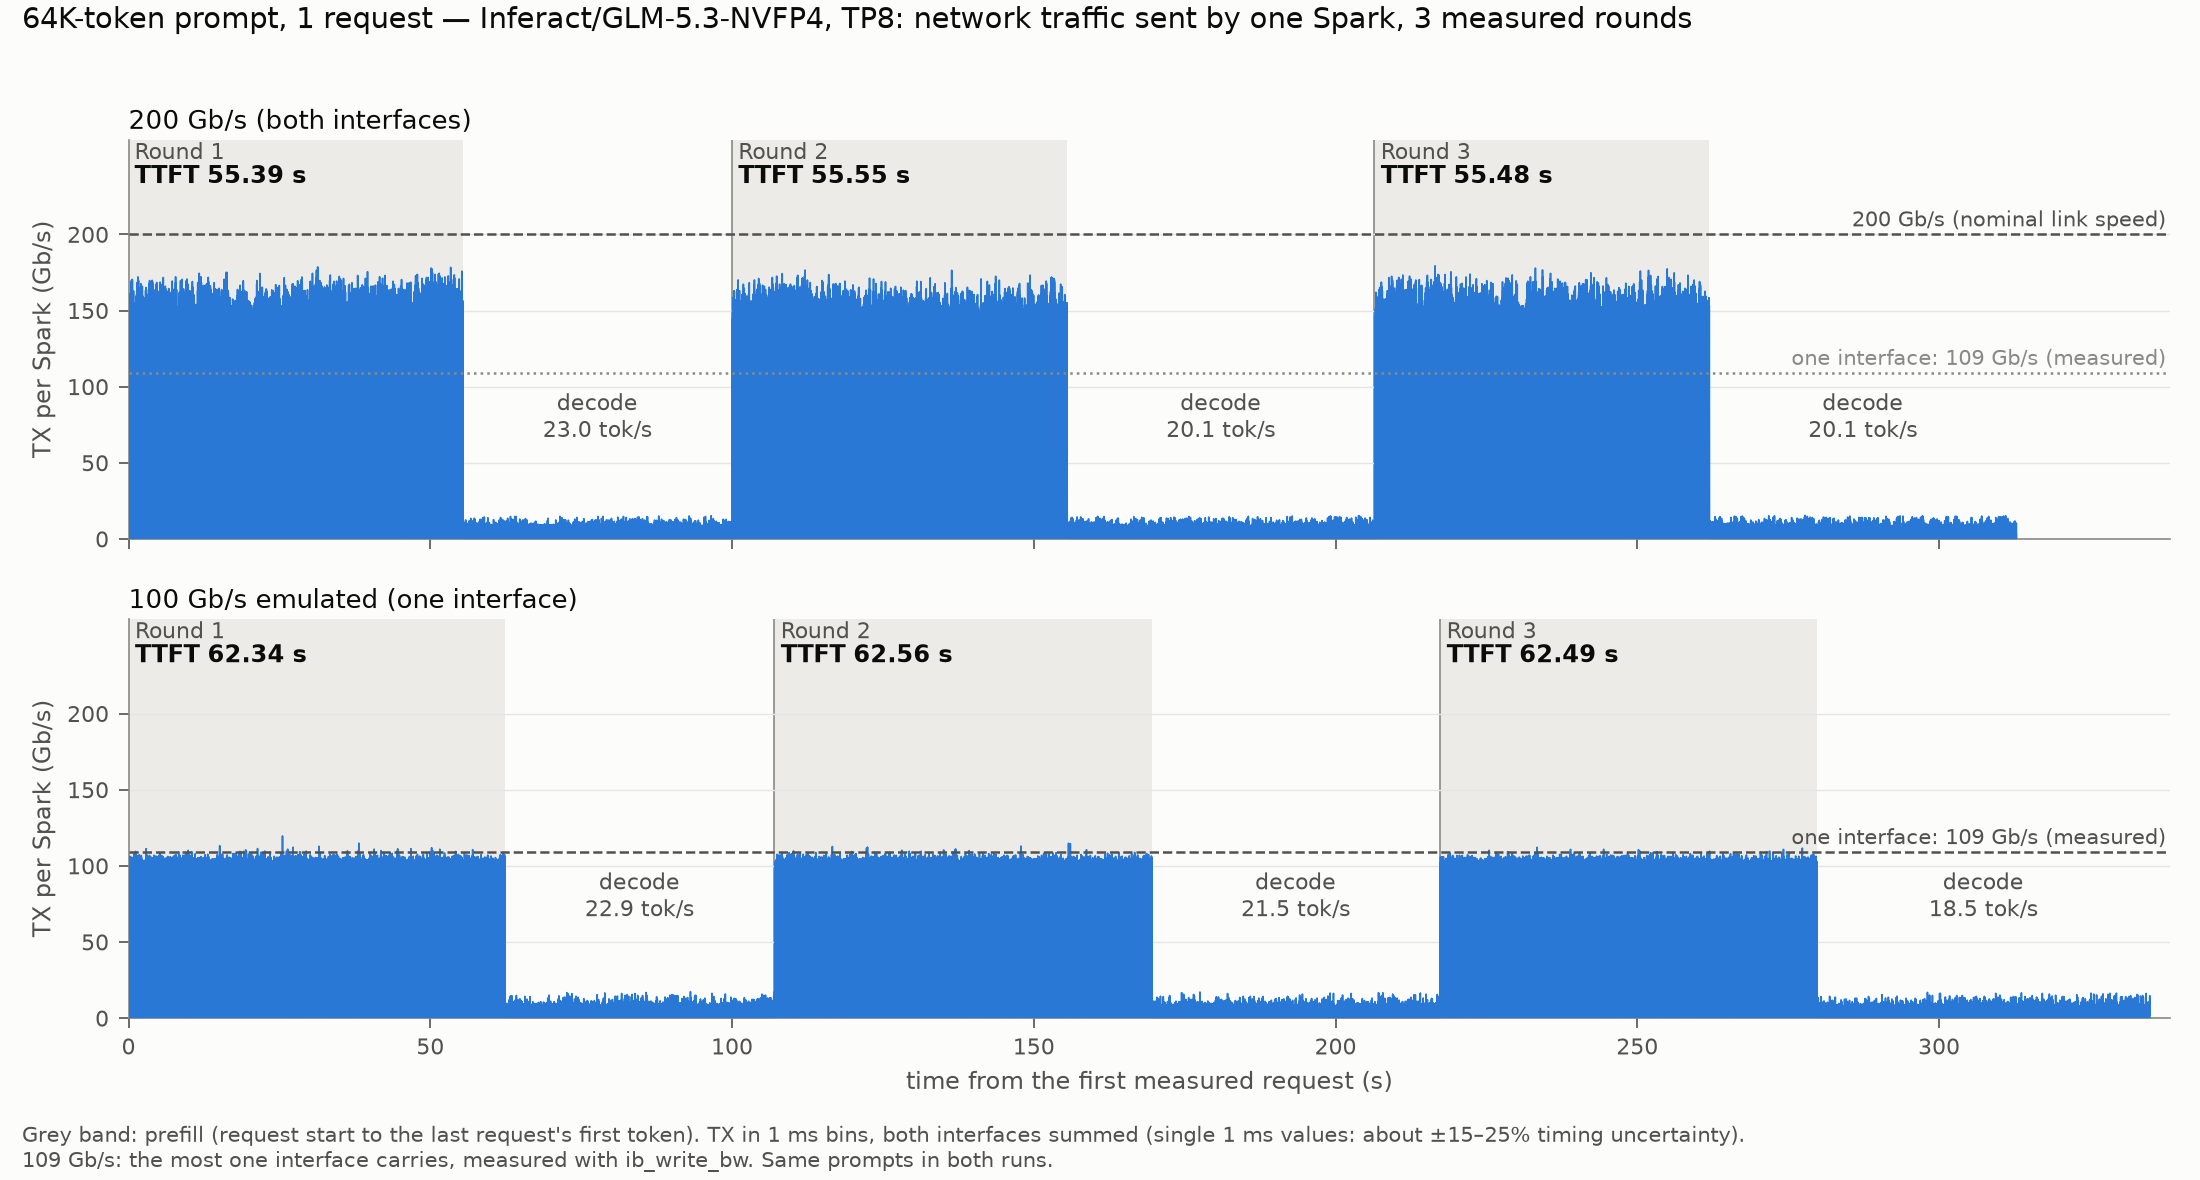
Figuur 9: P5, prompt van 64K tokens, 1 verzoek.
De prompt van 64K gedraagt zich als de prompt van 32K over twee keer de lengte: bursts van ongeveer 150–180 Gb/s op 200 Gb/s, op 109 Gb/s gehouden op de geëmuleerde link, en een TTFT die stijgt van 55.5 s naar 62.5 s. De drie rondes liggen binnen 0.2 s van elkaar.
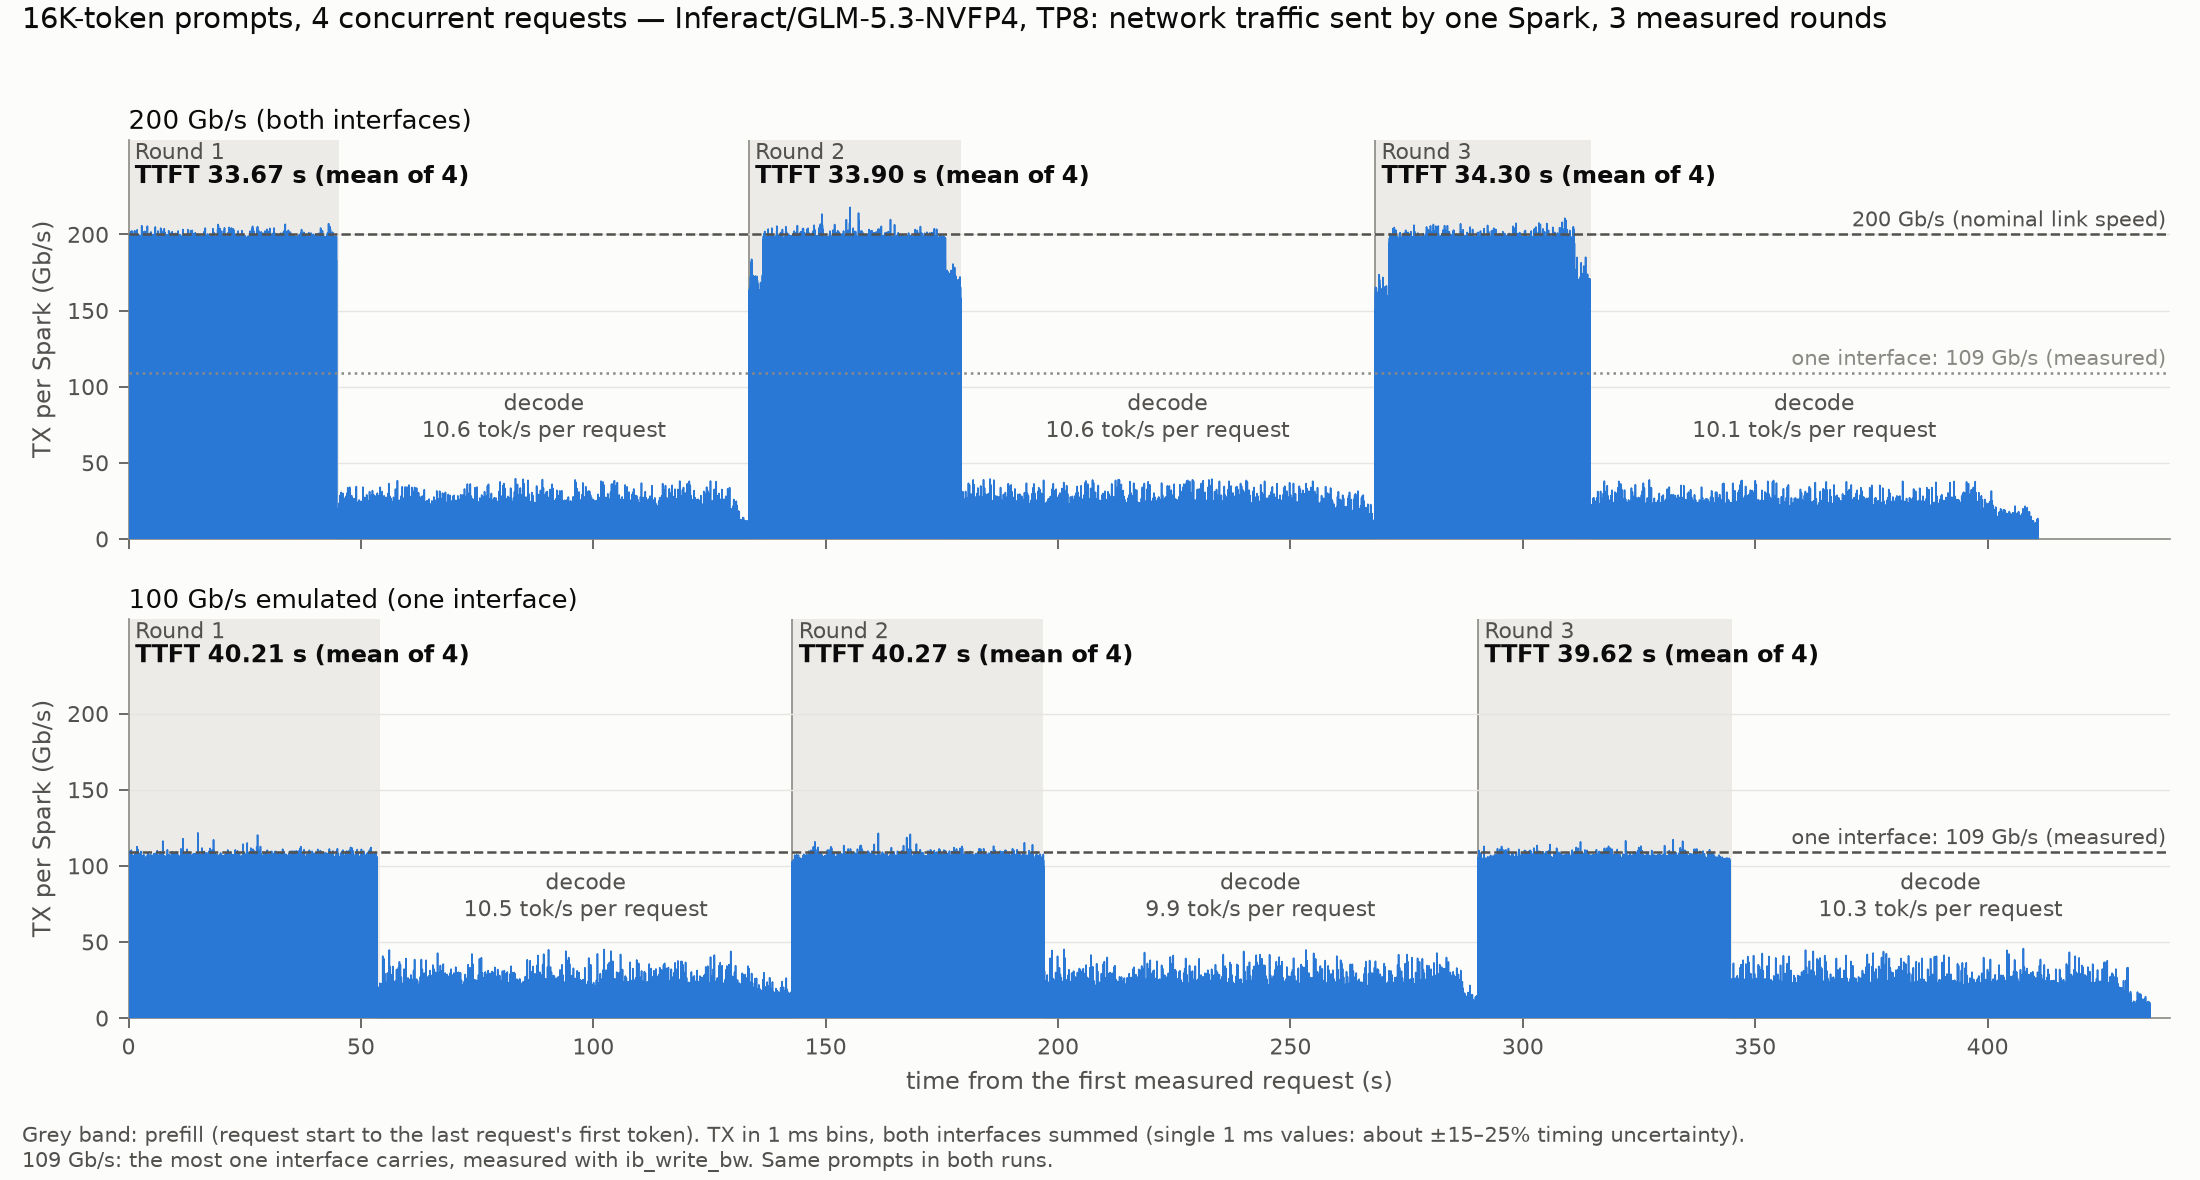
Figuur 10: P6, vier prompts van 16K tokens die tegelijk binnenkomen.
Met vier prompts van 16K houdt de prefill de 200 Gb/s-link ongeveer 46 s bijna volledig bezet, tegenover ongeveer 54 s op 109 Gb/s op de geëmuleerde link. De engine verwerkt de vier prompts in paren: de eerste twee ontvangen hun eerste tokens na ongeveer 22 s (200 Gb/s) en 27 s (geëmuleerd), de laatste twee na ongeveer 45 s en 54 s. Terwijl het tweede paar nog in prefill is, is het eerste paar al aan het decoderen.
8.3. Verkeer per prompttoken
Het gemeten prefill-verkeer was 3.54–3.60 MB per prompttoken per Spark, 5–7% meer dan de 3.38 MB van Sectie 3.3. Het verschil bestaat uit de headers van de netwerkpakketten en een kleine hoeveelheid verkeer per verzoek. De bytes waren bij beide linksnelheden gelijk, wat bevestigt dat alleen de linksnelheid veranderde.
8.4. TTFT
Gemiddelden van drie rondes, met de spreiding over de rondes tussen haakjes; voor P4 en P6 de tijd tot het laatste van de vier verzoeken zijn eerste token ontvangt. De schatting voor de geëmuleerde link (Sectie 7.3) staat ter vergelijking vermeld.
| Test | 200 Gb/s | 100 Gb/s (geëmuleerd, 109 Gb/s) | Toename |
|---|---|---|---|
| P1: 1K | 0.96 s (0.91–0.99) | 0.97 s (0.94–1.00) | +0.01 s (+1.1%), geen meetbaar verschil (schatting: ≤ +0.12 s) |
| P2: 8K | 6.36 s (6.21–6.56) | 7.24 s (7.14–7.45) | +0.88 s (+13.9%) (schatting: ≤ +0.92 s) |
| P3: 32K | 27.02 s (26.96–27.12) | 30.57 s (30.40–30.87) | +3.55 s (+13.1%) (schatting: ≤ +3.69 s) |
| P4: 4 × 8K, laatste eerste token | 23.00 s (22.61–23.19) | 26.44 s (26.20–26.59) | +3.44 s (+15.0%) (schatting: ≤ +3.69 s) |
| P5: 64K | 55.47 s (55.39–55.55) | 62.47 s (62.34–62.56) | +6.99 s (+12.6%) (schatting: ≤ +7.39 s) |
| P6: 4 × 16K, laatste eerste token | 45.82 s (45.36–46.52) | 54.26 s (54.08–54.60) | +8.44 s (+18.4%) (schatting: ≤ +7.39 s) |
Gemiddeld over de vier verzoeken van elke ronde steeg de TTFT van 16.49 s naar 20.21 s in P4 (+22.5%) en van 33.96 s naar 40.03 s in P6 (+17.9%). Dit zijn de grootste toenames die in een test zijn gemeten.
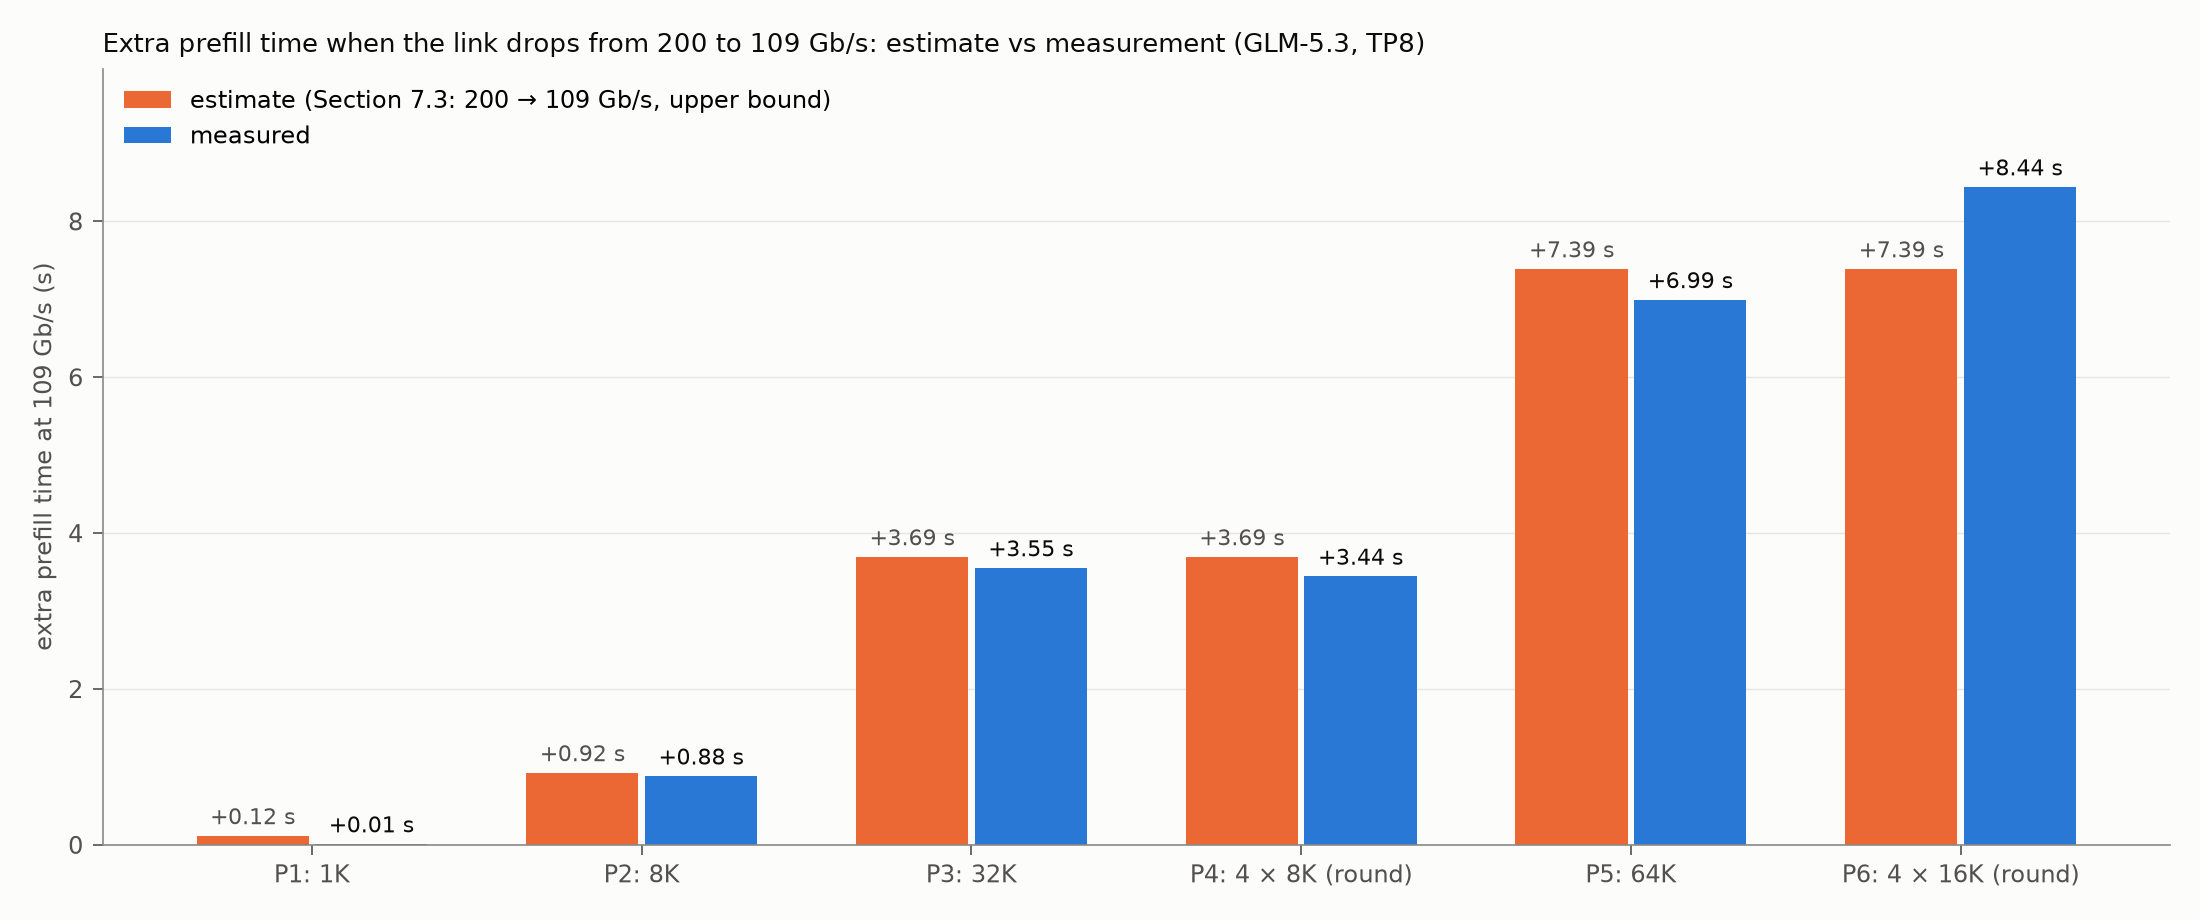
Figuur 11: Extra prefill-tijd wanneer de link van 200 naar 109 Gb/s daalt: schatting (Sectie 7.3) tegenover meting.
Voor afzonderlijke prompts van 8K–64K tokens en voor vier tegelijk binnenkomende prompts van 8K kwam de gemeten toename tot binnen enkele procenten van de schatting, iets eronder, zoals van een bovengrens te verwachten is: een klein deel van de overdrachten overlapt met rekenwerk. De schatting op basis van de architectuur van het model, de prefill-chunkgrootte van de engine en de linksnelheid voorspelt het effect van een tragere link dus goed, zonder enige meting van het rekenwerk. In seconden is de toename ongeveer 0.11 s per 1,000 prompttokens.
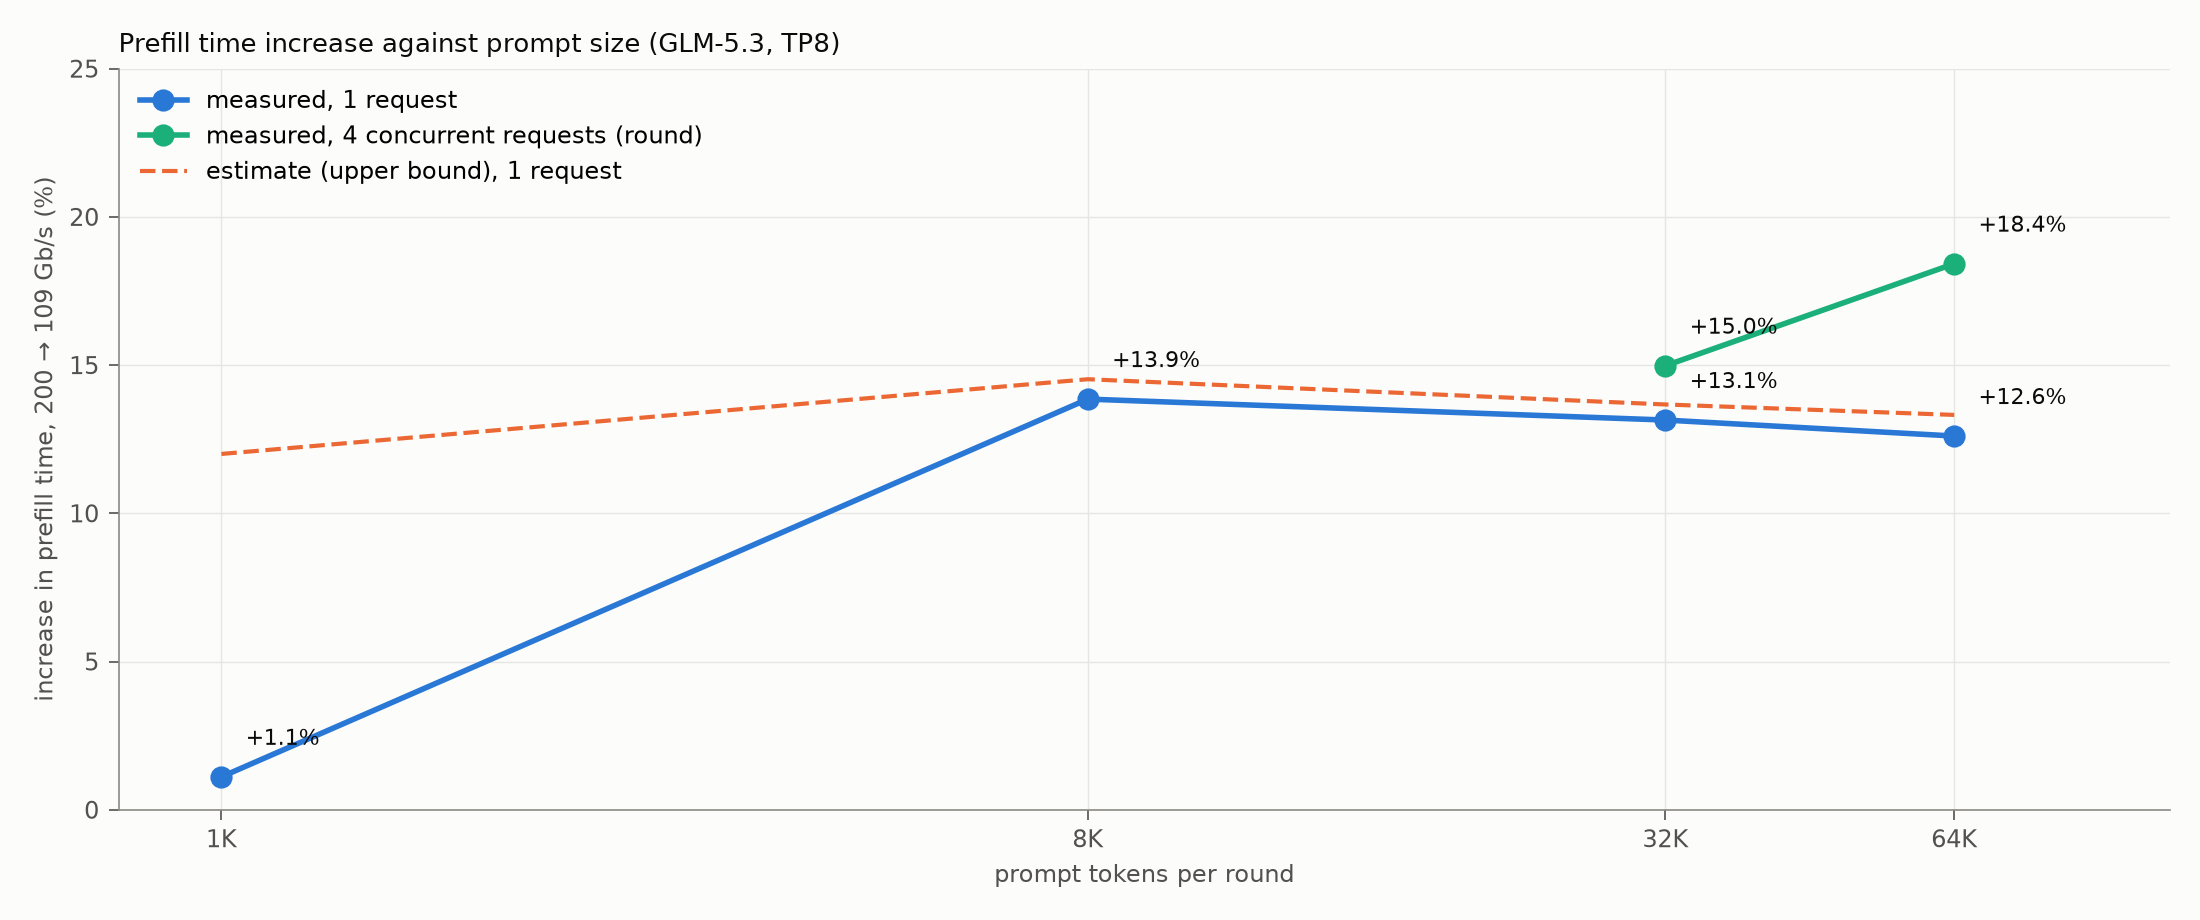
Figuur 12: Toename van de prefill-tijd tegenover de promptgrootte, gemeten en geschat.
Voor één prompt blijft het percentage van 8K tot 64K tokens vrijwel constant (13.9%, 13.1% en 12.6%), zoals Sectie 6.1 verwacht voor een model met sparse attention; de lichte daling is het deel van het attentionwerk dat nog steeds sneller groeit dan de bytes. Wanneer meerdere prompts tegelijk binnenkomen, is het percentage bij dezelfde totale promptgrootte hoger, 15.0% voor vier prompts van 8K en 18.4% voor vier prompts van 16K, zoals Sectie 6.2 verwacht.
8.5. Decodesnelheid
| Test | 200 Gb/s | 100 Gb/s (geëmuleerd) | Verandering |
|---|---|---|---|
| P1: 1K | 22.4 tokens/s | 22.5 tokens/s | +0.5% |
| P2: 8K | 21.1 tokens/s | 20.6 tokens/s | −2.3% |
| P3: 32K | 18.7 tokens/s | 19.1 tokens/s | +2.0% |
| P4: 4 × 8K | 10.8 tokens/s per verzoek | 11.2 tokens/s per verzoek | +4.3% |
| P5: 64K | 21.1 tokens/s | 21.0 tokens/s | −0.4% |
| P6: 4 × 16K | 10.5 tokens/s per verzoek | 10.2 tokens/s per verzoek | −2.1% |
De veranderingen wijzen in beide richtingen en blijven binnen de variatie tussen rondes: de decodesnelheid hangt niet af van de linksnelheid, zoals Sectie 4.2 verwacht.
8.6. Waar de meting afwijkt van de schatting
De prompt van 1K. De schatting staat tot +0.12 s toe, en de meting laat +0.01 s zien. Elke all-reduce van een prompt van 1K verstuurt slechts ongeveer 22 MB per Spark, en de bursts bereiken zelfs op 200 Gb/s maar ongeveer 100 Gb/s (Figuur 5), minder dan wat de geëmuleerde link draagt. Zoals Sectie 6.1 voorziet, overschat de grens het effect voor korte prompts.
Vier prompts van 16K die tegelijk binnenkomen. Hier is de gemeten toename ongeveer 1 s groter dan de schatting. De schatting dekt de tijd die aan het versturen van bytes wordt besteed. In deze test verwerkte de engine de prompts in paren en begon hij het eerste paar al te decoderen terwijl het tweede paar nog in prefill was (Sectie 8.2), zodat decodewerk de forward passes van de resterende prefill deelde. Hoe langer die prefill duurt, hoe meer decodewerk erin valt, en de tijd tot het laatste eerste token groeit met meer dan alleen de extra overdrachtstijd. Dit effect van de scheduling van de engine valt buiten de schatting, en het kan de vertraging vergroten wanneer meerdere lange prompts tegelijk binnenkomen.
Vier prompts van 8K die tegelijk binnenkomen. De tijd tot het laatste eerste token bleef binnen de schatting, maar de volgorde waarin de engine de vier eerste tokens vrijgaf, verschilde tussen de twee linksnelheden. De TTFT van afzonderlijke verzoeken in zulke tests hangt daarom deels af van de scheduling, niet alleen van de link.
9. Van de geëmuleerde link naar een echte 100G-kabel
De geëmuleerde link draagt tot 109 Gb/s; een echte 100 Gb/s-link draagt ten hoogste 100. Door de grens op dit verschil toe te passen, volgt het maximum dat een echte kabel aan de gemeten resultaten kan toevoegen:
aanvullende prefill-tijd ≤ gemeten prefill-bytes × (1/100 − 1/109)
| Test | Geëmuleerde 100 Gb/s (gemeten) | Echte 100 Gb/s-kabel, ten hoogste |
|---|---|---|
| P1: 1K | +1.1% | +3.6% |
| P2: 8K | +13.9% | +16.9% |
| P3: 32K | +13.1% | +16.0% |
| P4: 4 × 8K, laatste eerste token | +15.0% | +18.3% |
| P5: 64K | +12.6% | +15.4% |
| P6: 4 × 16K, laatste eerste token | +18.4% | +21.8% |
Een echte 100 Gb/s-kabel zou dus ten hoogste 2.5–3.5 procentpunt slechter zijn dan de gemeten resultaten, en de decodesnelheid zou nog steeds onaangetast blijven. In seconden geeft Sectie 5.1 ten hoogste 0.135 s per 1,000 prompttokens. Een echte 100 Gb/s-link draagt iets minder dan 100 Gb/s aan gegevens zodra de pakketoverhead wordt meegeteld, dus het werkelijke getal kan iets hoger uitvallen.
10. Projectie: hoe de vertraging verandert met de TP-grootte
Met de gemeten prefill van 8K op TP8 en 200 Gb/s als basislijn, en in de veronderstelling dat het rekenwerk gelijk over de Sparks wordt verdeeld, projecteert de grens van Sectie 5 het volgende voor een echte 100 Gb/s-link:
| TP-grootte | Geprojecteerde toename van de TTFT op 100 Gb/s, prompt van 8K |
|---|---|
| TP2 | ≤ 3% |
| TP4 | ≤ 8% |
| TP8 | ≤ 17% (gemeten op de geëmuleerde link: 13.9%; echte kabel: ≤ 16.9%) |
| TP16 | ≤ 31% |
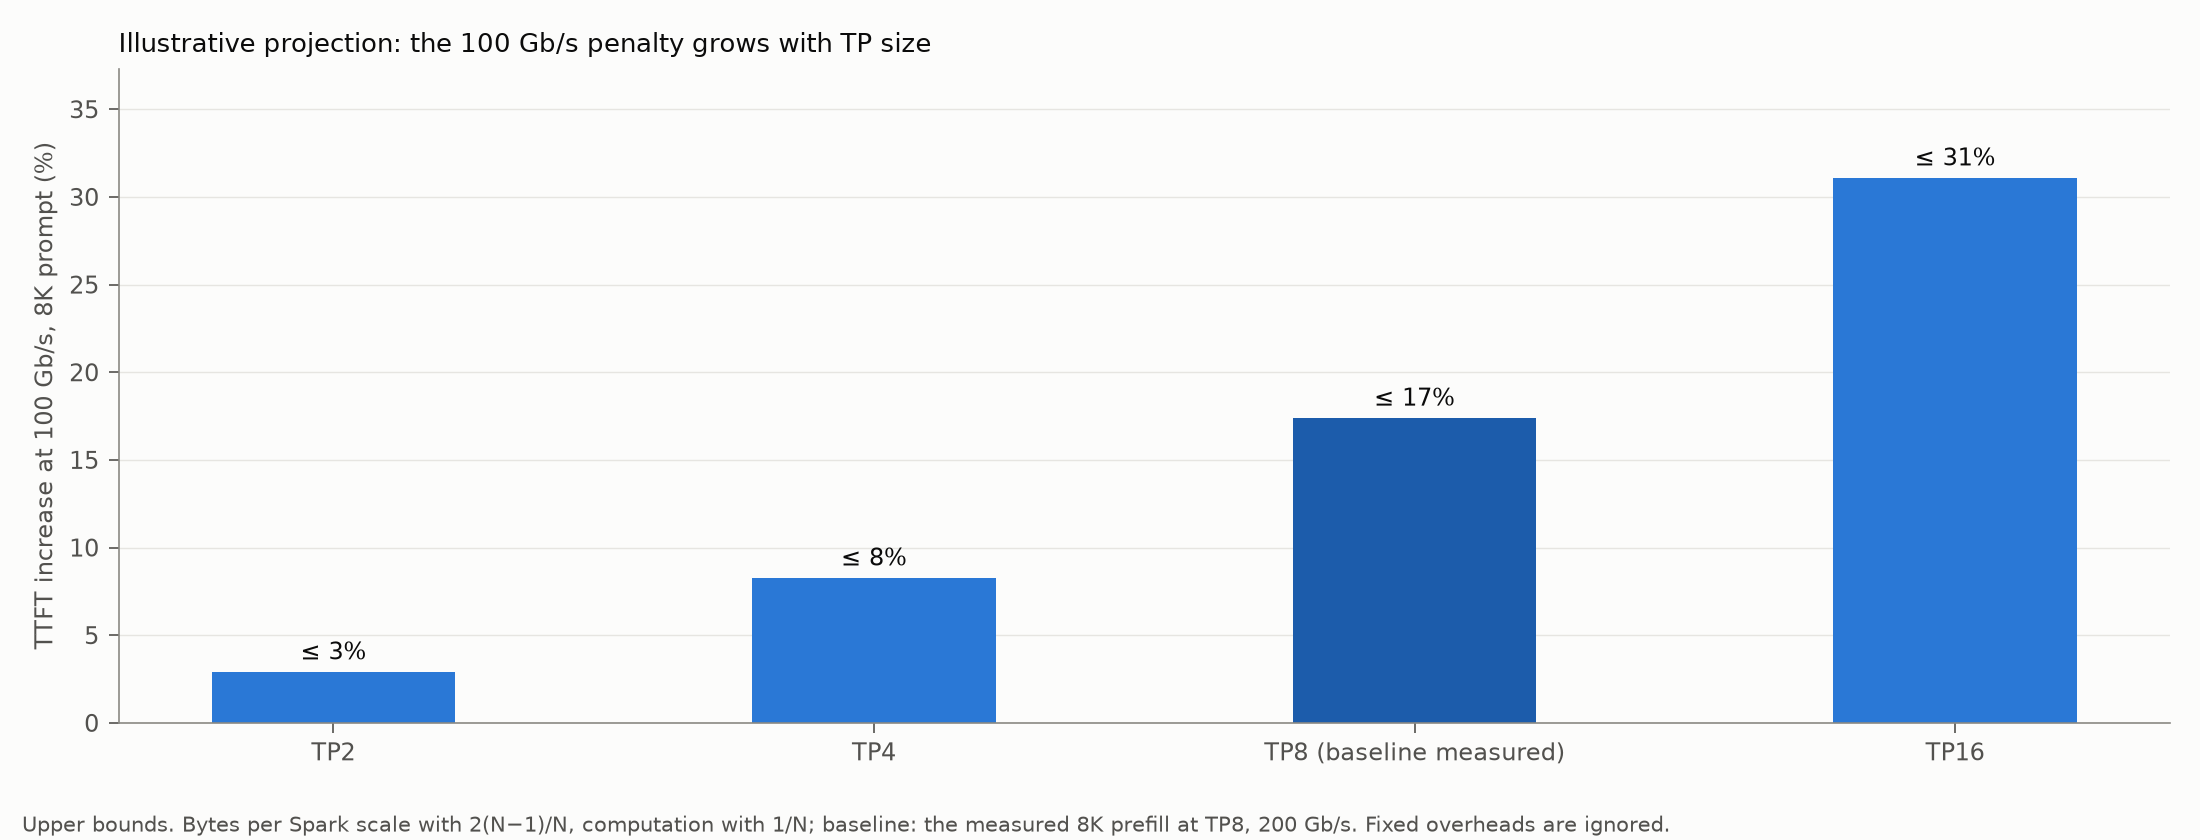
Figuur 13: Geprojecteerde TTFT-vertraging van 100 Gb/s tegenover de TP-grootte (ter illustratie).
Dit is een projectie, geen meting: GLM-5.3 past niet op 2 of 4 Sparks, en vaste overhead wordt buiten beschouwing gelaten. Ze laat de richting en de globale omvang van het effect zien: bij TP16 zou de vertraging ongeveer twee keer zo groot zijn als bij TP8. Op 16 Sparks met 100 Gb/s houden twee TP8-clusters elk de vertraging die in deze paper is gemeten, terwijl één TP16-cluster die ongeveer zou verdubbelen.
11. Zijn 8 Sparks op 100 Gb/s redelijk?
Ja. Wie een TP8-cluster van 8 Sparks van 200 Gb/s- naar 100 Gb/s-links overzet:
Het eerste token komt bij een zeer lange prompt ten hoogste ongeveer 20% later, en ten hoogste ongeveer 30% later wanneer meerdere zeer lange prompts tegelijk binnenkomen. Korte tot middellange prompts merken geen verschil. Zodra het antwoord begint, stroomt het in hetzelfde tempo.
| Workload | Gemeten (geëmuleerde 100 Gb/s) | Echte 100 Gb/s-kabel, ten hoogste |
|---|---|---|
| Chat met korte tot middellange prompts (rond 1K tokens) | geen meetbaar verschil | ongeveer +4% |
| Eén zeer lange prompt: RAG, lange documenten (8K–64K tokens) | TTFT +12.6–13.9% | TTFT +17% (ten hoogste 0.135 s per 1,000 prompttokens) |
| Meerdere zeer lange prompts die tegelijk binnenkomen | TTFT per verzoek +17.9–22.5% | TTFT per verzoek +27% |
| Decodesnelheid, in alle gevallen | ongewijzigd | ongewijzigd |
Dit zijn bovengrenzen voor de gemeten gevallen; in een gemengde workload zijn de meeste verzoeken korter of komen ze alleen binnen, en merken ze minder.
Op 100 Gb/s verbindt een CRS812 8 Sparks, genoeg voor één TP8-cluster, tegen de prijs van de langere wachttijd voor het eerste token bij lange prompts die hierboven is beschreven; het tempo waarin het antwoord stroomt, verandert niet.
Op 100 Gb/s verbindt een CRS804 16 Sparks. Als twee TP8-clusters gebruikt, krijgt elk de link per Spark die in deze paper is gemeten, zodat de resultaten hierboven voor elk gelden, mits de switch op alle poorten tegelijk verkeer op volle snelheid kan doorsturen (nog te verifiëren). Eén TP16-cluster zou de vertraging ongeveer verdubbelen (Sectie 10) en wordt op 100 Gb/s niet aanbevolen.
200 Gb/s blijft de betere keuze wanneer lange prompts met krappe TTFT-doelen de workload domineren, wanneer veel gebruikers tegelijk lange prompts versturen, of wanneer een model over meer dan acht Sparks moet worden verdeeld.
12. Beperkingen en aandachtspunten
De metingen betreffen één model (GLM-5.3), één inferentie-engine en versie (vLLM) en één TP-grootte (TP8). Andere modellen, engines en instellingen versturen andere hoeveelheden gegevens en rekenen met andere snelheden; de schattingsmethode is overdraagbaar, maar de getallen moeten opnieuw worden berekend. Het 100 Gb/s-geval werd geëmuleerd met één netwerkinterface in plaats van opgebouwd met 100G-kabels; Sectie 9 begrenst het verschil. De projectie naar TP-grootte in Sectie 10 is een berekening, geen meting.
Controleer voordat u voor 100 Gb/s kiest of de switch 4 × 100G-breakout op zijn QSFP-DD-poorten ondersteunt in de geplande configuratie, of de ConnectX-7 van de DGX Spark met de gekozen breakoutkabel op 100 Gb/s een link opbouwt, en, bij 16 Sparks, of de switch op alle poorten tegelijk verkeer op volle snelheid kan doorsturen.
Veelgemaakte fouten bij het dimensioneren van het clusternetwerk
- ✗ De verkeerde tellers aflezen: standaard Linux-tools (
ip -s link,nload,sar) zien geen RDMA-verkeer, en tonen tijdens inferentie dus een vrijwel ongebruikte link. - ✗ Het linkgebruik beoordelen op gemiddelden: gemiddelden per seconde of per switchpoort verbergen de bursts van milliseconden die de TTFT bepalen.
- ✗ Aannemen dat de halve linksnelheid de halve inferentiesnelheid betekent: alleen de bursts tijdens prefill vertragen; decode niet.
- ✗ Een model op 100 Gb/s over meer Sparks verdelen dan nodig is: de vertraging groeit met de TP-grootte.
Checklist voor het plannen van het netwerk van een cluster met 8 of 16 Sparks
- ☐ Is de TP-grootte per modelinstantie vastgesteld (TP8, of twee TP8-instanties op 16 Sparks)?
- ☐ Is de verwachte promptlengte bekend (chat, RAG, lange documenten)?
- ☐ Is er een TTFT-doel voor lange prompts?
- ☐ Is de vertraging van 100 Gb/s geschat (bytes per prompttoken × prompttokens ÷ 200 Gb/s, Sectie 5)?
- ☐ Zijn de breakoutondersteuning en het opbouwen van de ConnectX-7-link op de geplande snelheid geverifieerd?
- ☐ Wordt het RDMA-verkeer bewaakt met RDMA-tellers met een resolutie van een milliseconde?
13. Conclusie
Tensorparallelle inferentie over DGX Spark-systemen gebruikt het netwerk op twee heel verschillende manieren. Terwijl een prompt wordt verwerkt, verstuurt elke all-reduce tientallen megabytes per Spark, in bursts die een 200 Gb/s-link telkens enkele milliseconden vullen. Terwijl het antwoord wordt gegenereerd, zijn de all-reduces enkele honderden kilobytes of minder, en blijft het verkeer ver onder 100 Gb/s. Een gehalveerde linksnelheid laat de decodesnelheid daarom ongewijzigd en voegt een voorspelbare hoeveelheid toe aan het wachten op het eerste token.
Die hoeveelheid is te schatten op basis van alleen de architectuur van het model, de prefill-chunkgrootte van de engine en de linksnelheid: voor GLM-5.3 op TP8 ten hoogste 0.135 s per 1,000 prompttokens op 100 Gb/s. Gemeten op 8 Sparks met een geëmuleerde 100 Gb/s-link kregen afzonderlijke prompts van 8K–64K tokens hun eerste token 12.6–13.9% later, dicht bij de schatting; verzoeken die samen met andere lange prompts binnenkwamen 17.9–22.5% later; korte prompts en de decodesnelheid werden niet beïnvloed. Een echte 100G-kabel zou er ten hoogste nog 2.5–3.5 procentpunt aan toevoegen.
Voor een TP8-cluster van 8 Sparks met 100 Gb/s-links kunt u verwachten dat het eerste token bij een zeer lange prompt ten hoogste ongeveer 20% later komt en ten hoogste ongeveer 30% later wanneer meerdere zeer lange prompts tegelijk binnenkomen, zonder verschil voor korte tot middellange prompts en zonder verschil in hoe snel het antwoord stroomt. Omdat de vertraging groeit met de TP-grootte, zijn 16 Sparks op 100 Gb/s het best te gebruiken als twee TP8-clusters.
Bijlage A: RDMA-verkeer meten
Omdat RDMA de netwerkstack van het besturingssysteem omzeilt, tellen de gebruikelijke interfacestatistieken het niet mee. Het verkeer in deze studie werd afgelezen uit de RDMA-poorttellers van de ConnectX-7 (port_xmit_data en port_rcv_data onder /sys/class/infiniband/, in eenheden van 4 bytes) voor elk van de twee RDMA-apparaten, en per poort opgeteld. Een controle tegen de eigen bytetellers van de adapter kwam binnen 0.2% overeen.
Een kleine sampler las de tellers elke 1 ms op één Spark af en gaf elke aflezing een eigen tijdstempel, op dezelfde klok die de benchmark voor zijn verzoeken gebruikte. Snelheden over 1 ms en langere intervallen werden berekend door de bytes van elk bemonsteringsinterval te verdelen over de middelingsintervallen die het overlapt. De bytetellingen zijn exact, maar het tijdstip van elke aflezing is slechts tot ongeveer ±0.1–0.2 ms bekend, zodat één waarde over 1 ms een onzekerheid van ongeveer ±15–25% heeft; daarom liggen sommige waarden over 1 ms in de figuren iets boven de linksnelheid. Gemiddelden over 5 ms of langer zijn tot op enkele procenten nauwkeurig.
De keuze van het middelingsinterval verandert de hoogste waarde die een meting rapporteert, zoals Sectie 8.1 laat zien: hetzelfde verkeer piekt op 181 Gb/s in intervallen van 1 ms, 96 Gb/s in intervallen van 5 ms en 44 Gb/s in intervallen van 100 ms, terwijl het gemiddelde in alle gevallen gelijk is. Een piekwaarde heeft alleen betekenis samen met haar middelingsinterval.
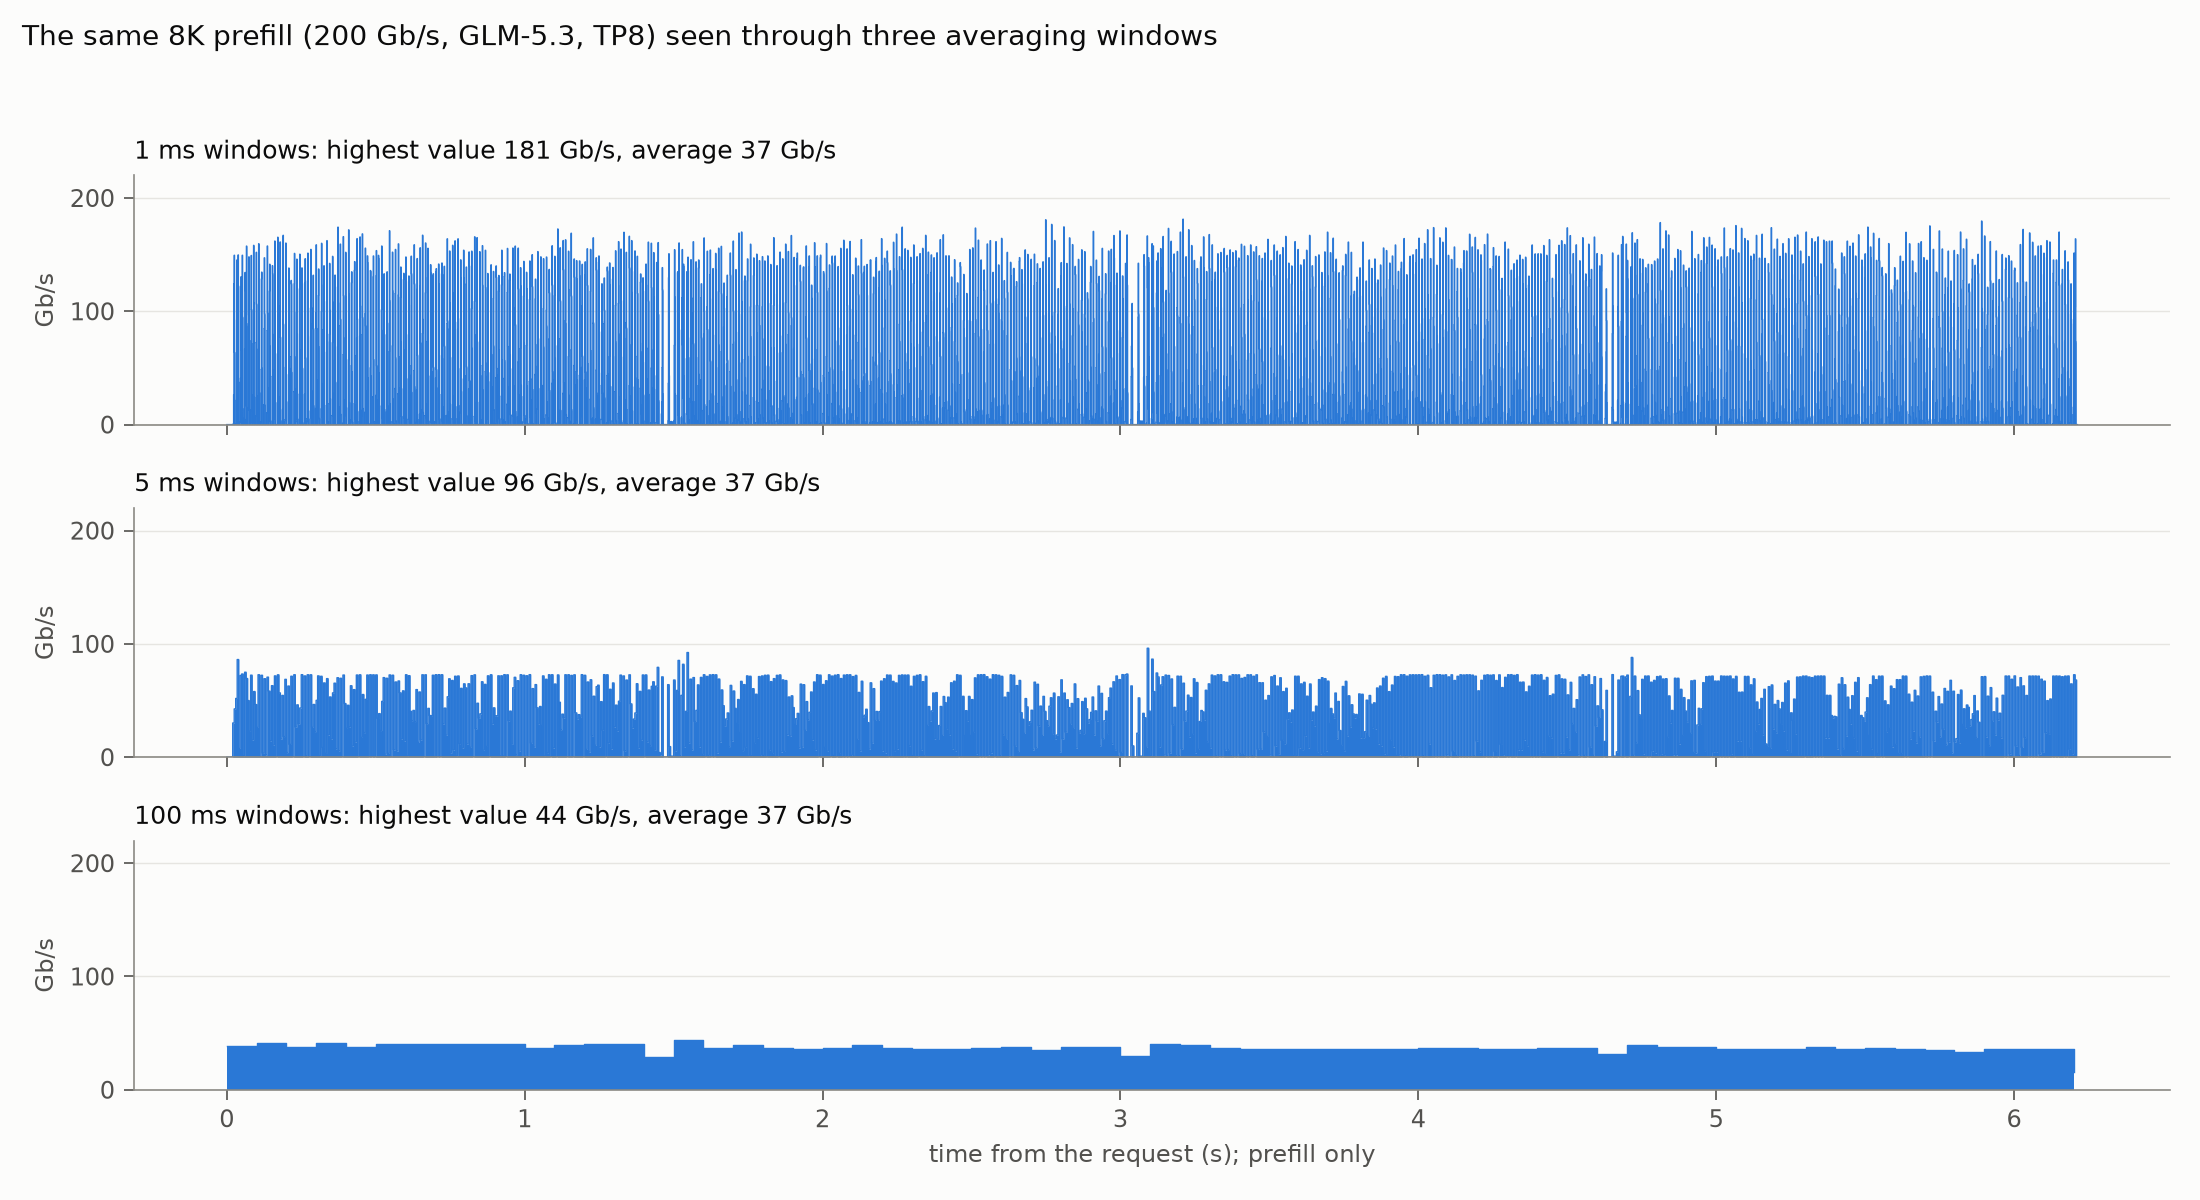
Figuur A1: Hetzelfde prefill-verkeer, gemiddeld over intervallen van 1 ms, 5 ms en 100 ms.
De meting zelf had geen invloed op het netwerk: bandbreedte- en latentietests (ib_write_bw, ib_write_lat) met de sampler actief en gestopt lieten dezelfde bandbreedte zien (109.07, 109.08 en 109.15 Gb/s) en ten hoogste ongeveer 1% verschil in latentie. De sampler en de benchmarkdriver gebruikten samen ruim minder dan één van de 20 CPU-cores van de Spark.
Bijlage B: Reproduceerbaarheid
| Onderdeel | Waarde |
|---|---|
| Testdriver | verstuurt de testverzoeken als streamingverzoeken naar de engine, geeft het eerste en elk volgend token van elk antwoord een tijdstempel, en registreert daarnaast de RDMA-tellers op dezelfde klok (Secties 7.4–7.6, Bijlage A) |
| Model | Inferact/GLM-5.3-NVFP4 |
| Engine | vLLM 0.1.dev20133+gb5f995e73, container vllm-node-b12x, NCCL 2.28.3 |
| Serve-instellingen | --tensor-parallel-size 8, --max-num-batched-tokens 4096, --long-prefill-token-threshold 2048, --max-num-seqs 8, --max-model-len 262144, --kv-cache-dtype fp8, --gpu-memory-utilization 0.726, --enable-chunked-prefill, --enable-prefix-caching; speculatieve decodering: MTP, 4 tokens, draft niet verdeeld |
| NCCL | NCCL_IB_HCA met beide RDMA-apparaten (200 Gb/s); tweede apparaat uitgesloten (emulatie van 100 Gb/s); RoCE v2, GID-index 3 |
| Plan | tests P1–P6 (Sectie 7.4), 1 opwarmronde en 3 meetrondes, vaste seed, 1,024 uitvoertokens |
Woordenlijst
- Activaties: De vectoren die elk token vertegenwoordigen terwijl het door de lagen van het model gaat.
- All-reduce: Een collectieve bewerking die gegevens optelt die in delen op elk apparaat staan, en elk apparaat de volledige som geeft.
- Bandbreedtegebonden / latentiegebonden: Een overdracht is bandbreedtegebonden wanneer haar duur wordt bepaald door hoe snel de link bytes verplaatst (grote overdrachten), en latentiegebonden wanneer die wordt bepaald door vaste vertragingen (kleine overdrachten).
- Breakoutkabel: Een kabel die één snelle switchpoort (bijvoorbeeld 400 Gb/s) splitst in meerdere tragere links (bijvoorbeeld 4 × 100 Gb/s).
- ConnectX-7: De netwerkadapter van NVIDIA die in de DGX Spark is ingebouwd.
- Decode: De fase die het antwoord genereert, één forward pass tegelijk.
- Decodesnelheid: Hoe snel het antwoord stroomt: uitvoertokens per seconde na het eerste token.
- Emulatie: Het nabootsen van een situatie (hier een 100 Gb/s-link) op de echte hardware, in tegenstelling tot het modelleren ervan in software.
- Forward pass: Eén doorloop van de lagen van het model over de tokens die op dat moment worden verwerkt.
- Verborgen dimensie: De lengte van de vector die elk token binnen het model vertegenwoordigt (6,144 voor GLM-5.3).
- MTP (multi-token prediction): Een vorm van speculatieve decodering waarbij het model meerdere tokens als draft voorstelt, die vervolgens in één forward pass worden gecontroleerd.
- NCCL: De bibliotheek van NVIDIA voor communicatie tussen GPU’s, die de inferentie-engine voor all-reduce gebruikt.
- Netwerkinterface: Wat het besturingssysteem ziet van een verbinding van een netwerkadapter; hier verschijnt elke ConnectX-7-poort als twee interfaces, één per PCIe-link.
- Netwerkaandeel van de prefill-tijd: De tijd die nodig is om de prefill-bytes op 200 Gb/s te versturen, gedeeld door de prefill-tijd.
- Nominale linksnelheid: De opgegeven snelheid van een link (hier 200 Gb/s), vóór protocoloverhead.
- NVFP4: Het 4-bits floating-pointgetalformaat van NVIDIA, met een schaalfactor die gedeeld wordt door elke groep van 16 waarden.
- Prefill: De fase die de prompt verwerkt vóór het eerste uitvoertoken.
- Prefill-chunk: Het deel van een prompt dat in één forward pass wordt verwerkt (hier maximaal 4,096 tokens).
- RDMA: Remote direct memory access: de netwerkadapter leest en schrijft rechtstreeks in het geheugen van applicaties, zonder dat de gegevens door de netwerkstack van het besturingssysteem gaan.
- Ring-all-reduce: Een all-reduce waarbij apparaten segmenten van de gegevens in een ring doorgeven; elk apparaat verstuurt in totaal 2 × (N − 1) / N keer de gegevens.
- RoCE v2: RDMA over Converged Ethernet, versie 2: RDMA-pakketten die binnen UDP/IP over standaard-Ethernet worden getransporteerd.
- Tensorparallellisme (TP): Het verdelen van elke gewichtsmatrix van een model over meerdere apparaten, die na elke stap hun deelresultaten combineren.
- TTFT (time to first token): De tijd van het versturen van een verzoek tot het ontvangen van het eerste token van het antwoord.
Bronnen
Hardware:
- NVIDIA DGX Spark — https://www.nvidia.com/en-us/products/workstations/dgx-spark/
- Documentatie van de NVIDIA ConnectX-7-adapter — https://docs.nvidia.com/networking/display/connectx7vpi/introduction
- MikroTik CRS804 DDQ — https://mikrotik.com/product/crs804_ddq
- MikroTik CRS812 DDQ — https://mikrotik.com/product/crs812_ddq
Model en software:
- GLM-5.3 NVFP4-checkpoint — https://huggingface.co/Inferact/GLM-5.3-NVFP4
- vLLM — https://github.com/vllm-project/vllm
- NCCL — https://github.com/NVIDIA/nccl
- perftest (
ib_write_bw,ib_write_lat) — https://github.com/linux-rdma/perftest
Gerelateerde papers:
- Installatiehandleiding voor een DGX Spark AI-cluster met 8 nodes
- Schaling van Qwen3.6-27B op een DGX Spark-cluster
- Handleiding voor lokaal LLM-gebruik
Opmerkingen
- Schattingen: Secties 3–6 gebruiken alleen de configuratie van het model, de instellingen van de engine en de linksnelheid; de grenzen zijn bovengrenzen. De projectie naar TP-grootte (Sectie 10) gebruikt de gemeten TP8-basislijn en dient ter illustratie.
- Metingen: Alle prestatiecijfers zijn gemeten op 8× DGX Spark met GLM-5.3 op TP8, zoals beschreven in Sectie 7; het netwerkverkeer werd afgelezen uit de RDMA-tellers van de ConnectX-7 van één Spark (Bijlage A).
- Emulatie: 100 Gb/s werd geëmuleerd door de communicatie te beperken tot een van de twee netwerkinterfaces van elke ConnectX-7-poort, die tot 109 Gb/s draagt; Sectie 9 begrenst het verschil met een echte 100G-kabel.
- Actualiteit: Engineversies en instellingen veranderen snel; de resultaten gelden voor de vermelde versies, met de stand van oktober 2026.
Laten we samen het netwerk van uw DGX Spark-cluster plannen. Voor een dimensionering die rekening houdt met modelgrootte, tensorparallellisme en linksnelheid, neem contact op met OpenZeka: support@openzeka.com · openzeka.com