Yayın tarihi: Ekim 2026 Kapsam: Tensör paralel (TP) çıkarımın DGX Spark sistemleri arasındaki ağı nasıl kullandığı, bağlantı hızını yarıya indirmenin etkisinin modelin mimarisinden ve çıkarım motorunun ayarlarından nasıl tahmin edileceği, ve GLM-5.3 ile TP8’de 8× DGX Spark üzerinde 200 Gb/s ile emüle edilmiş 100 Gb/s bağlantıların ölçülerek karşılaştırılması. Not: Ölçümler, Bölüm 7’de listelenen model, çıkarım motoru, sürümler ve ayarlar için geçerlidir. Bölüm 3–6’daki tahmin yöntemi başka model ve ayarlara da uygulanabilir; ölçülen sayılar ise uygulanamaz.
Hazırlayan: Openzeka Teknoloji A.Ş. — NVIDIA Türkiye & MEA Resmî Embedded Compute Distribütörü ve NVIDIA Elite Partner
İçindekiler
- Yönetici Özeti
- 1. Giriş
- I. Kısım: Teori
- II. Kısım: Ölçüm
- 7. Test Tasarımı
- 8. Sonuçlar: TP8’de 200 Gb/s ve Emüle Edilmiş 100 Gb/s
- 9. Emüle Edilmiş Bağlantıdan Gerçek 100G Kabloya
- 10. Öngörü: Kayıp TP Boyutuyla Nasıl Değişir
- 11. 100 Gb/s’de 8 Spark Makul mü?
- 12. Sınırlar ve Dikkat Edilmesi Gerekenler
- 13. Sonuç
- Ek A: RDMA Trafiğini Ölçmek
- Ek B: Tekrarlanabilirlik
- Sözlük (Terimler)
- Kaynaklar
Yönetici Özeti
- Soru: bir modeli 8 sistem üzerinde tensör paralelliğiyle sunan bir DGX Spark cluster’ı hızlı switch portlarına ihtiyaç duyar. Spark başına 200 Gb/s’de bir MikroTik CRS812 4 ila 6 Spark bağlar; 100 Gb/s’de 8 Spark bağlar. Bir CRS804, 200 Gb/s’de 8 Spark’ı, 100 Gb/s’de 16 Spark’ı bağlar. Bu çalışma, Spark başına 100 Gb/s’nin çıkarım hızına neye mal olduğunu soruyor.
- Tensör paralelliğinin ağı kullanma biçimi: her Spark her ağırlık matrisinin sekizde birini tutar, bu yüzden her biri her sonucun yalnızca bir kısmını hesaplar. Spark’lar her katmanda iki kez, kısmi sonuçlarını ağ üzerinden all-reduce adı verilen bir işlemle toplar. Prompt işlenirken (prefill) her all-reduce’ta toplanan veri büyüktür; cevap üretilirken (decode) küçüktür.
- Tahmin: prefill aktarımları tam bağlantı hızında çalışacak kadar büyüktür; bu yüzden bağlantıyı yarıya indirmek bu aktarımları uzatır ve ilk token’ı geciktirir. GLM-5.3 ile TP8 için modelin mimarisinden yapılan tahmin, 100 Gb/s’de 1,000 prompt token’ı başına ilk token süresine (TTFT) en fazla 0.135 s ek süre öngörür. Decode aktarımları ise bağlantı hızının önem taşıyamayacağı kadar küçüktür.
- Cluster 200 Gb/s’nin tamamını kullanıyor mu? Hem evet hem hayır. Milisaniye çözünürlüğünde ölçüldüğünde prefill trafiği, birkaç milisaniyelik patlamalar halinde 150–200 Gb/s’ye ulaşır. Aynı trafiğin bir saniyelik ortalaması yaklaşık 40 Gb/s’dir; decode ise birkaç Gb/s düzeyinde kalır.
- GLM-5.3 ile TP8’de, 200 Gb/s ile emüle edilmiş 100 Gb/s bağlantı (en fazla 109 Gb/s taşır) karşılaştırılarak ölçülen sonuçlar:
- decode hızı değişmiyor (−%2.3 ile +%4.3 arası, test turları arasındaki değişkenlik içinde);
- 8K–64K token’lık tekil prompt’larda TTFT %12.6–13.9 artıyor, yani 1,000 prompt token’ı başına yaklaşık 0.11 s; bu, tahmine yakın;
- dört uzun prompt aynı anda geldiğinde, her isteğin TTFT’si %17.9–22.5 artıyor;
- kısa prompt’lar etkilenmiyor (1K token’da +%1).
- Gerçek bir 100 Gb/s kablo buna en fazla 2.5–3.5 puan daha ekler.
- Değerlendirme: 8 Spark’lık bir TP8 cluster’ı 200 Gb/s’den 100 Gb/s bağlantılara geçirildiğinde, ilk token’ın çok uzun bir prompt’ta en fazla yaklaşık %20, birkaç çok uzun prompt aynı anda geldiğinde ise en fazla yaklaşık %30 daha geç gelmesi beklenmelidir. Kısa ve orta uzunluktaki prompt’larda değişiklik olmaz ve cevap bir kez başladığında aynı hızda akar. 16 Spark’ta tek bir TP16 cluster yerine iki TP8 cluster çalıştırın: kayıp, TP boyutuyla birlikte büyür.
1. Giriş
Tek bir DGX Spark 128 GB birleşik bellek (unified memory) barındırır. Bundan büyük modeller, ConnectX-7 ağ adaptörleri ve bir switch üzerinden birbirine bağlanan birkaç Spark’a bölünerek sunulur. Tensör paralelliği (tensor parallelism) ile modelin her katmanı tüm Spark’lara bölünür; bu yüzden Spark’lar modelin işlediği her token için defalarca veri alışverişi yapar ve çıkarımın (inference) her adımı ağı bekler.
Bu da switch’i bir tasarım kararı haline getirir. Her Spark’ı 200 Gb/s yerine 100 Gb/s ile çalıştırmak, aynı 8 Spark’a daha küçük bir switch’in hizmet etmesini ya da aynı switch’in iki katı Spark’a hizmet etmesini sağlar. Bunun kabul edilebilir olup olmadığı, Spark’lar arasındaki bağlantı yarı hızda olduğunda tensör paralel çıkarımın ne kadar yavaşladığına bağlıdır.
Bu çalışmanın I. Kısmı (Bölüm 2–6), tensör paralelliğinin ağ üzerinden ne gönderdiğini, prompt işlemenin ve cevap üretiminin ağı neden çok farklı yüklediğini ve bağlantı hızını yarıya indirmenin etkisinin yalnızca modelin mimarisi, çıkarım motorunun ayarları ve bağlantı hızından nasıl tahmin edileceğini anlatır. II. Kısım (Bölüm 7–10), GLM-5.3’ü TP8’de sunan 8× DGX Spark üzerinde 200 Gb/s’yi emüle edilmiş 100 Gb/s bağlantıyla karşılaştırarak ölçer, sonuçları tahminle kıyaslar ve gerçek bir 100 Gb/s kabloya dönüştürür. Bölüm 11, 8 ve 16 Spark’lık cluster’lar için boyutlandırma cevabını verir.
I. Kısım: Teori
2. DGX Spark Ağı
2.1. ConnectX-7 adaptörü ve iki PCIe bağlantısı
Her DGX Spark’ta iki QSFP portlu bir ConnectX-7 ağ adaptörü bulunur. Bu çalışmadaki cluster’lar Spark başına bir port kullanır; port, switch’e 200 Gb/s nominal bağlantı hızıyla kablolanmıştır.
Adaptör GB10 yongasına PCIe Gen5 üzerinden, her biri dört hatlı (×4) iki ayrı bağlantıyla bağlanır. Tek bir ×4 bağlantı 100 Gb/s’nin biraz üzerinde veri taşır (Bölüm 7.3); bu, 200 Gb/s’lik bir portu tek başına doldurmaya yetmez, iki bağlantı birlikte yeter. Linux adaptörü her PCIe bağlantısı için bir kez görür; bu yüzden tek fiziksel port iki kez görünür: her biri kendi RDMA cihazına sahip iki ağ arayüzü olarak (enp1s0f1np1 ve enP2p1s0f1np1). İki arayüz de aynı porta ait olduğu için ikisi de 200 Gb/s bağlantı hızı bildirir, ancak her biri yalnızca kendi PCIe bağlantısının taşıyabildiği kadarını aktarabilir.
Çıkarım motorunun Spark’lar arası iletişim için kullandığı kütüphane olan NCCL, iki RDMA cihazını iki ayrı ağ yolu olarak ele alır ve trafiğini ikisine dağıtır; portun 200 Gb/s’sine ancak ikisi birlikte ulaşır. Aynı düzen, II. Kısım’daki 100 Gb/s durumunu donanıma dokunmadan mümkün kılar: NCCL’i iki arayüzden yalnızca birine sınırlamak, her Spark’ı tek bir PCIe bağlantısının taşıyabildiğiyle sınırlar.
Spark’lar arasındaki trafik RDMA (remote direct memory access, uzak doğrudan bellek erişimi) kullanır: adaptör veriyi gönderen uygulamanın belleğinden okur ve doğrudan alıcı uygulamanın belleğine yazar; veri işletim sisteminin ağ yığınından geçmez. Bu, her aktarımın gecikmesini düşük tutar. Olağan Linux ağ istatistiklerinin bu trafiği göstermemesinin nedeni de budur (Ek A). Burada RDMA, RDMA paketlerini UDP/IP içinde taşıyan RoCE v2 (RDMA over Converged Ethernet, sürüm 2) ile sıradan Ethernet üzerinde çalışır.
2.2. Bağlantı, sistemdeki en yavaş yoldur
200 Gb/s, 25 GB/s eder. Bir DGX Spark kendi belleğini 273 GB/s ile, yani yaklaşık 11 kat daha hızlı okur. Spark’lar arasında ağı geçmesi gereken her şey, bir Spark’ın kendi belleğinden okuduğu her şeyden çok daha yavaş taşınır; bağlantı hızının ne kadar önemli olduğunu, tensör paralelliğinin ağ üzerinden ne kadar veri gönderdiği ve bunun zamanlaması belirler.
2.3. Switch’ler ve breakout seçenekleri
CRS804 ve CRS812, 400 Gb/s QSFP-DD portlara sahiptir. Bir breakout kablosu bu portların her birini, her Spark için bir tane olmak üzere birkaç daha yavaş bağlantıya böler:
| Switch | 400G QSFP-DD port | 200 Gb/s’de Spark (port başına 2 × 200G) | 100 Gb/s’de Spark (port başına 4 × 100G) |
|---|---|---|---|
| MikroTik CRS812 | 2 (artı 2 × 200G QSFP56) | 4 (QSFP56 portlarla 6) | 8 |
| MikroTik CRS804 | 4 | 8 | 16 |
Spark başına 100 Gb/s’de 8 Spark’lık bir cluster bir CRS812’ye sığar ve bir CRS804 16 Spark’a hizmet edebilir.
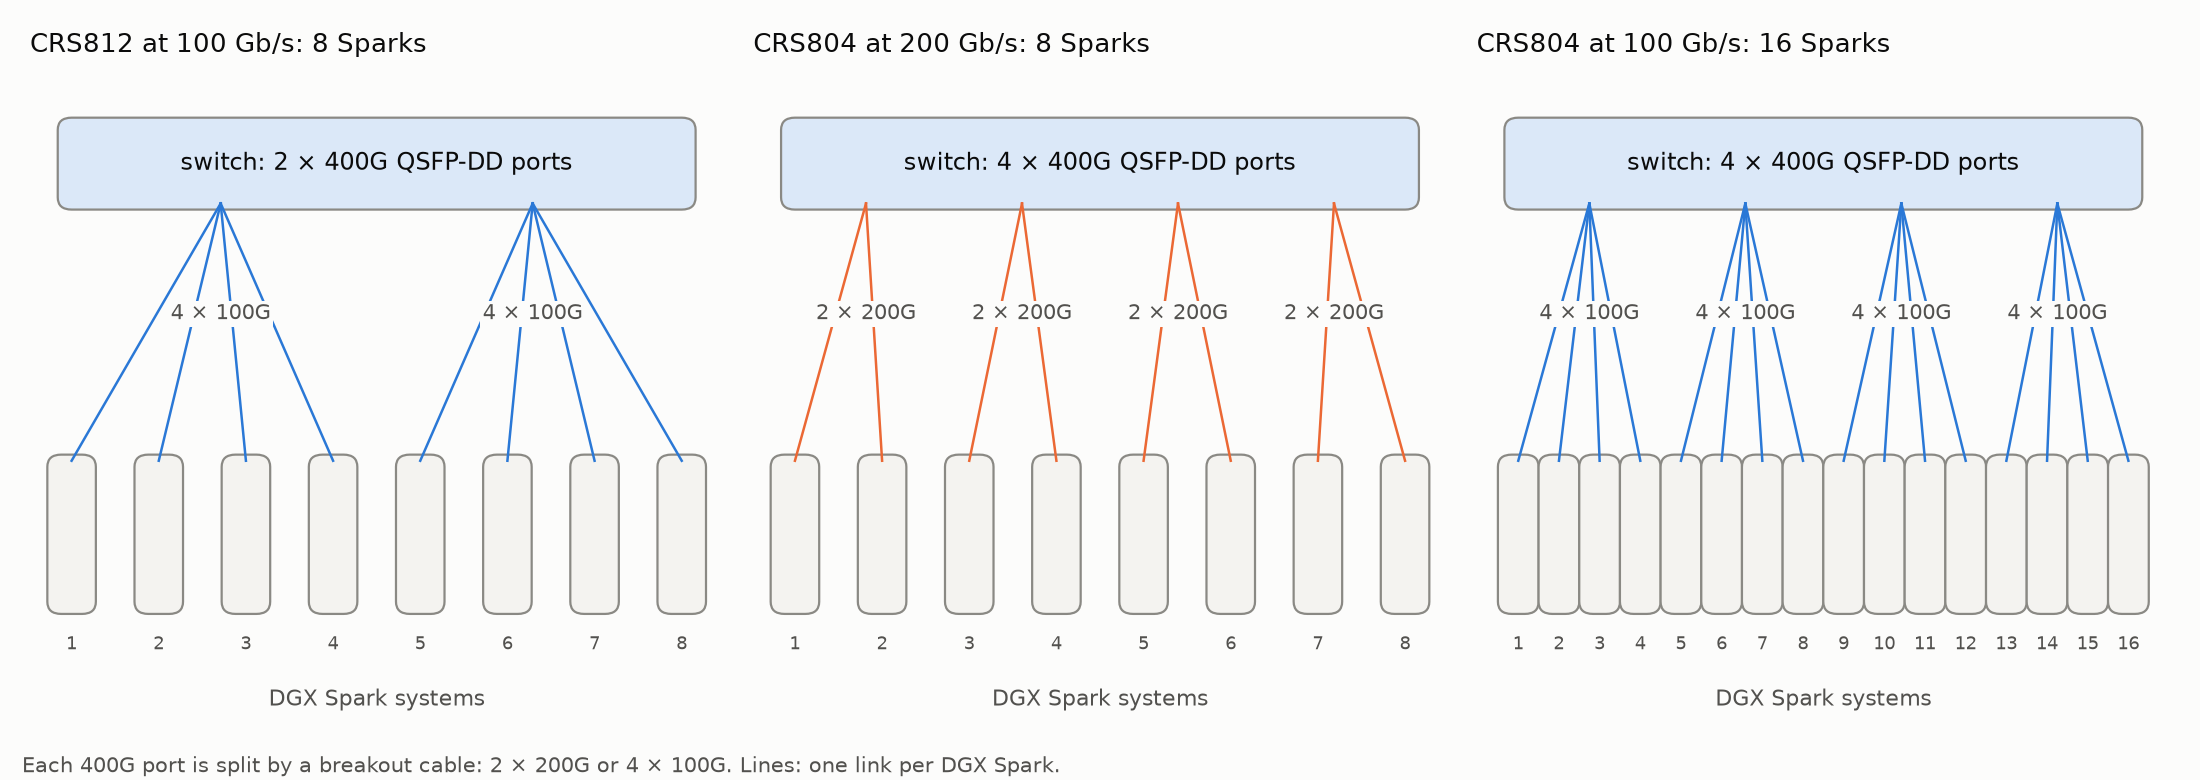
Şekil 1: Breakout seçenekleri, her DGX Spark için bir bağlantı.
3. Tensör Paralelliğinin Ağı Kullanma Biçimi
3.1. Modeli bölmek
8 Spark’lı tensör paralelliğinde (TP8), modelin her büyük ağırlık matrisi 8 dilime kesilir ve her Spark bir dilim tutar. Attention bloklarında attention başlıkları Spark’lar arasında paylaştırılır. İleri beslemeli (feed-forward) ve Uzmanların Karışımı (Mixture-of-Experts, MoE) bloklarında her uzmanın matrisleri de dilimlenir; böylece her Spark her uzmanın bir kısmını tutar. Her Spark kendi belleğinden ağırlıkların yalnızca kendi sekizde birini okur; bir Spark’tan büyük bir modelin sığmasını ve her Spark’ın her şeyi okuması gereken duruma göre daha hızlı çalışmasını sağlayan budur.
3.2. Kısmi sonuçlar ve all-reduce
Bir ağırlık matrisini bu şekilde bölmek, hiçbir Spark’ın bir çarpımı tek başına tamamlayamayacağı anlamına gelir. Bir katmanın her çıktı değeri, ağırlıklar ile girdilerin çarpımlarından oluşan uzun bir toplamdır; ağırlıklar sekize bölündüğünde her Spark bu toplamın sekizde birini hesaplar. Söz konusu değerler modelin aktivasyonlarıdır: her token’ı katmanlardan geçerken temsil eden vektörler. GLM-5.3 her token’ı 6,144 değerlik bir vektörle temsil eder (gizli boyutu). Bir seferde 4,096 token işlenen bir prompt için her Spark sonunda 4,096 × 6,144 kısmi değer tutar; bu, değer başına 2 bayt ile 50.3 MB eder. Asıl sonuç sekiz Spark’ın bloklarının toplamıdır ve model devam edebilmeden önce her Spark’ın bu toplamın tamamına ihtiyacı vardır.
Bunu üretmek bir all-reduce‘un işidir: bloklar birleştirildiği (burada toplandığı) için reduce, her katılımcı sonucu aldığı için all. Bir transformer katmanı iki tane gerektirir: biri attention bloğundan, biri ileri beslemeli ya da MoE bloğundan sonra; girdi embedding’inde de bir tane daha gerekir. Her Spark her all-reduce’ta sekizinin de katkısını verene kadar bekler; bu yüzden ağ, her katmanın yolu üzerindedir.
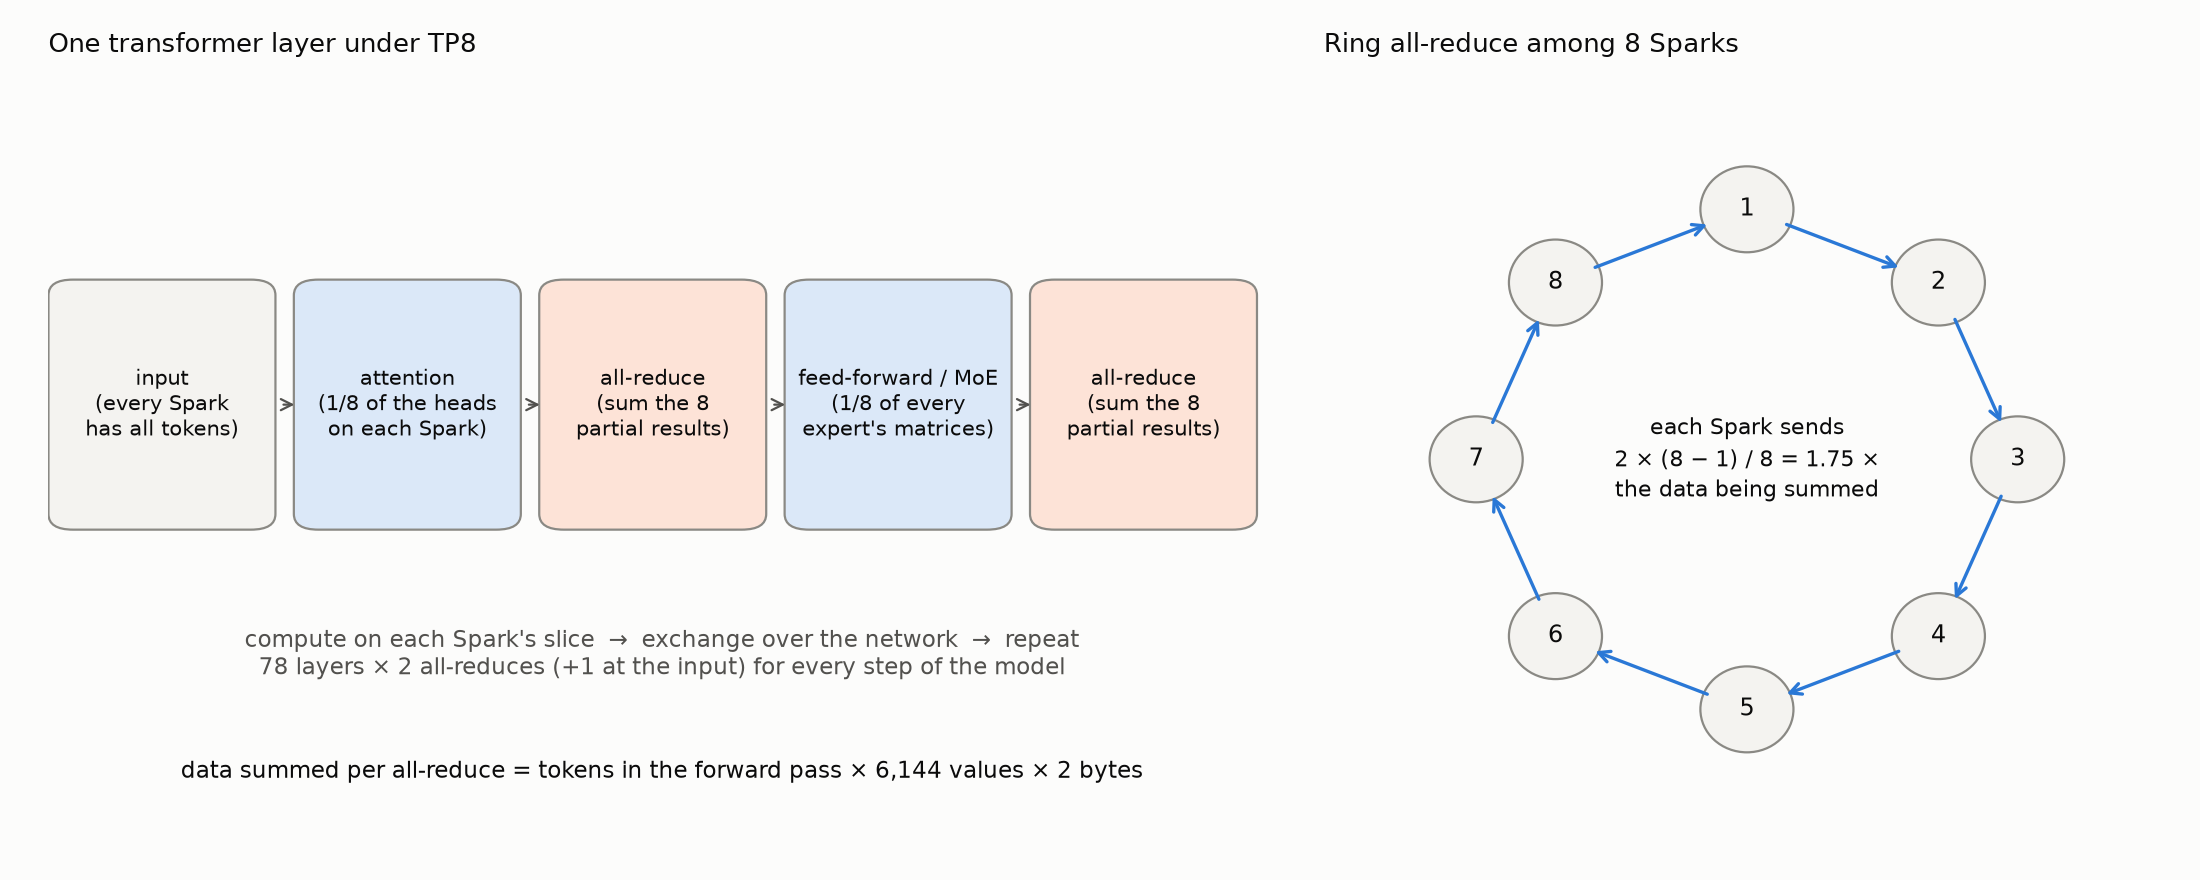
Şekil 2: Tensör paralelliği altında bir transformer katmanı ve 8 Spark arasındaki halka all-reduce.
3.3. Halka all-reduce nasıl çalışır
Doğrudan yaklaşım, yani her Spark’ın tüm bloğunu diğer yedisine göndermesi, her Spark’a 7 × 50.3 MB gönderme yükü bindirir ve eklenen her Spark’la yük büyür. NCCL bunun yerine yaygın olarak bir halka (ring) kullanır. Spark’lar bir çember şeklinde dizilir, her biri yalnızca bir sonrakine gönderir ve her blok Spark sayısı kadar segmente kesilir. İş ardından iki aşamada ilerler; Şekil 3’te dört Spark için gösterilmiştir.
İlk aşama olan reduce-scatter‘da her Spark her halka adımında bir sonraki Spark’a bir segment gönderir ve alan Spark bunu o segmentin kendi kopyasına ekler. Her Spark aynı anda farklı bir segment üzerinde çalışır; böylece N − 1 halka adımından sonra her Spark tam olarak bir segmentin eksiksiz toplamını tutar. İkinci aşama olan all-gather‘da tamamlanmış segmentler, bu kez toplanmadan kopyalanarak halkayı bir kez daha dolaşır; başka N − 1 halka adımından sonra her Spark toplamın tamamına sahip olur.
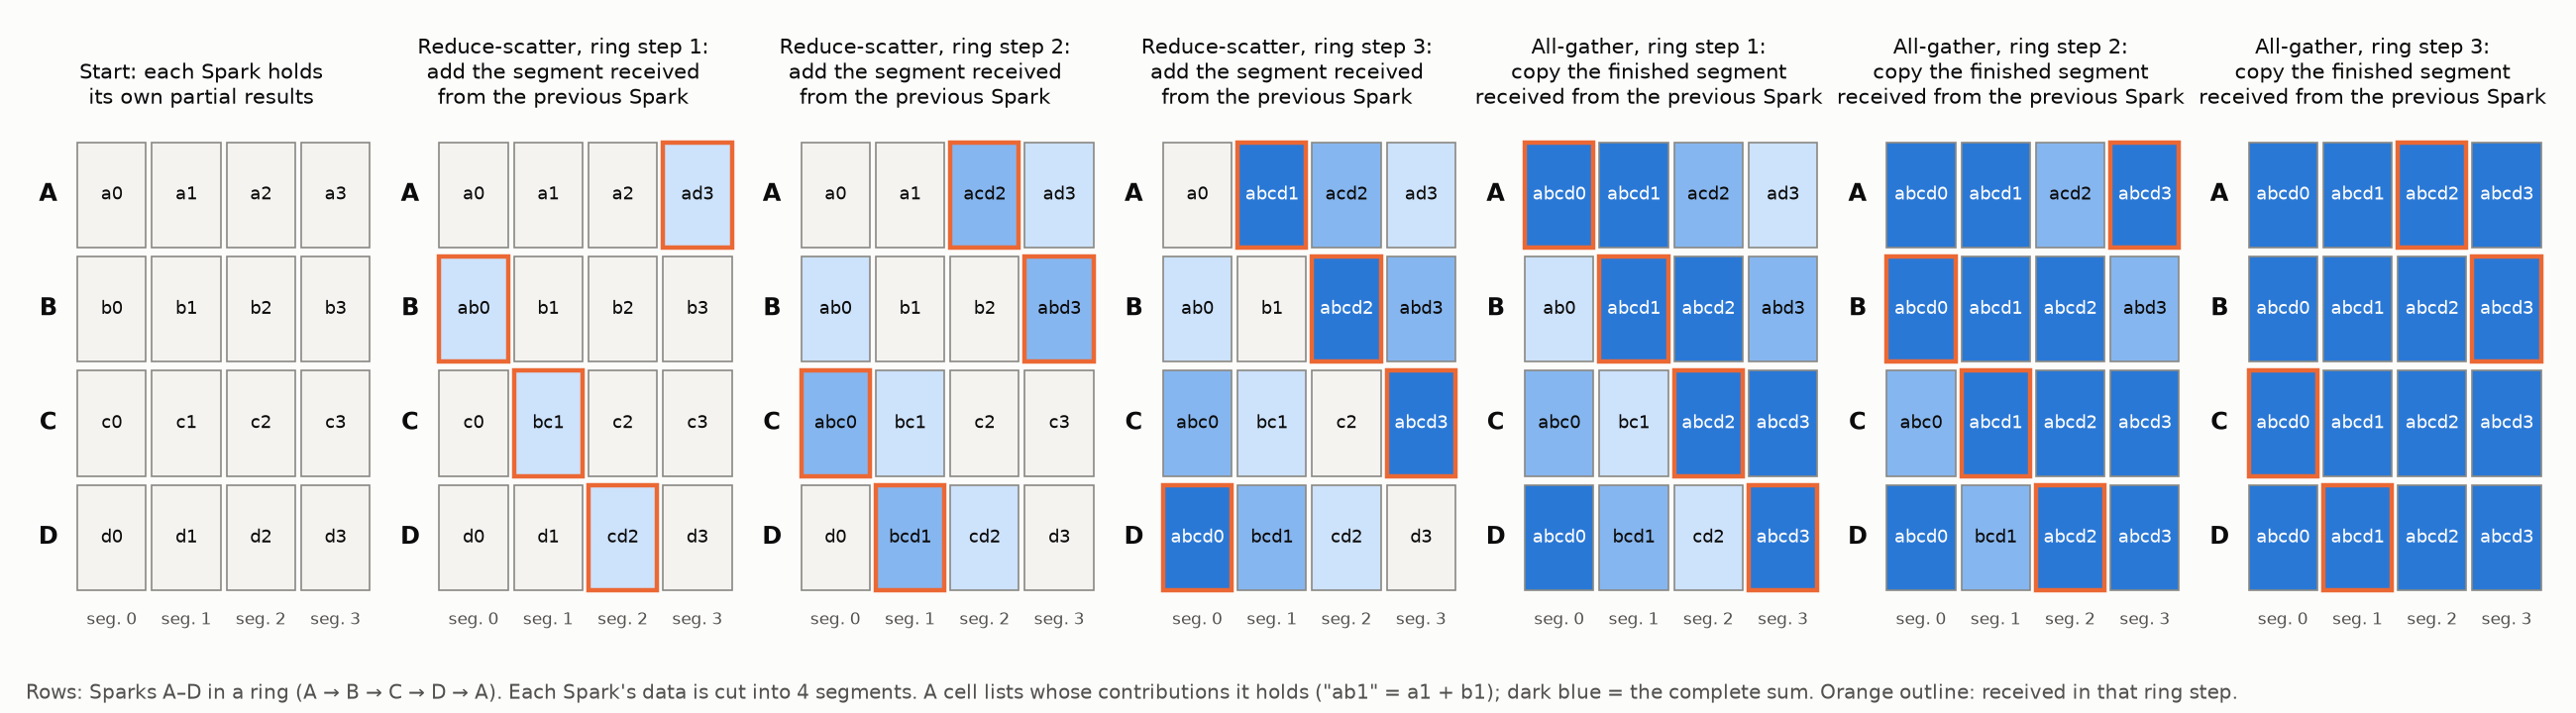
Şekil 3: Dört Spark arasında halka all-reduce. Üç reduce-scatter adımından sonra her Spark bir eksiksiz toplam tutar; üç all-gather adımından sonra her Spark dördünü de tutar.
2 × (N − 1) halka adımının her birinde bir Spark, bloğunun 1/N’i olan bir segment gönderir. Dolayısıyla her Spark toplamda bloğun 2 × (N − 1) / N katını gönderir: sekiz Spark için 1.75 kat ve kaç Spark katılırsa katılsın hiçbir zaman 2 kattan fazla değil. GLM-5.3 ile TP8’de her Spark all-reduce başına 1.75 × 50.3 MB = 88.1 MB gönderir; bu, her biri yaklaşık 6.3 MB’lık 14 halka adımında gerçekleşir. Her Spark aynı miktarı gönderdiği için tek bir Spark’ta ölçülen trafik sekizini de temsil eder.
Modeldeki tüm all-reduce’lar (78 katman × 2, artı 1) toplandığında, her prompt token’ı her Spark’a
(2 × 78 + 1) × 6,144 değer × 2 bayt × 1.75 = 3.38 MB ağ trafiğine mal olur.
NCCL, farklı miktarlarda veri gönderen başka all-reduce algoritmaları da seçebilir; II. Kısım bu değeri ölçülen trafikle karşılaştırır.
3.4. Spark sayısıyla ne değişir
Spark eklemek hesaplamayı böler, ama toplanması gereken veriyi bölmez. Yalnızca ağırlıklar bölünür: her Spark, her çıktı değeri için toplamın bir parçasını hesaplar; bu yüzden kısmi değerlerden oluşan bloğu, model ister iki ister on altı Spark üzerinde çalışsın, 4,096 × 6,144 değerde (50.3 MB) kalır. TP boyutu her iki katına çıktığında her Spark’ın hesaplaması yarıya iner; her Spark’ın all-reduce başına gönderdiği miktar ise, yani bloğun 2 × (N − 1) / N katı, biraz artar:
| TP boyutu | Spark başına hesaplama | All-reduce başına Spark’ın gönderdiği |
|---|---|---|
| TP2 | modelin 1/2’si | 1.0 × 50.3 MB = 50.3 MB |
| TP4 | 1/4 | 1.5 × 50.3 MB = 75.5 MB |
| TP8 | 1/8 | 1.75 × 50.3 MB = 88.1 MB |
| TP16 | 1/16 | 1.875 × 50.3 MB = 94.3 MB |
Böylece TP8’den TP16’ya geçmek, her Spark’ın hesaplamaya harcadığı süreyi yarıya indirir ama veri göndermeye harcadığı süreyi neredeyse hiç değiştirmez; ağ, her ileri yayılımın daha büyük bir payını alır. Bunun bağlantı hızı açısından ne anlama geldiği Bölüm 6.3’te hesaplanıyor.
4. Prefill ve Decode: Ağ Üzerinde İki Farklı Yük
Çıkarım, ağı zıt biçimlerde kullanan iki aşamada ilerler. Her all-reduce’un ne kadar veri taşıdığı, modelden bir ileri yayılımın (forward pass) kaç token işlediğine bağlıdır; bunu da çıkarım motorunun ayarları belirler. Aşağıdaki değerler II. Kısım’da kullanılan vLLM yapılandırmasını izler.
4.1. Prefill: tam bağlantı hızında büyük aktarımlar
Prefill sırasında vLLM, prompt’u ileri yayılım başına en fazla 4,096 token’lık prefill parçaları (chunk) halinde işler (--max-num-batched-tokens 4096); bu yüzden her all-reduce Bölüm 3.2’deki 50.3 MB’lık bloğu toplar ve her Spark 88.1 MB gönderir:
| Bağlantı hızı | 88.1 MB’ı gönderme süresi |
|---|---|
| 200 Gb/s | 3.5 ms |
| 100 Gb/s | 7.0 ms |
Her aktarım ayrıca yazılımda, senkronizasyonda ve ağ donanımında bir miktar sabit ek yük taşır. Bu tür ek yük için cömert bir 100 µs bile bu sürelerin yanında küçüktür: 200 Gb/s’de bağlantı 100 µs’de yalnızca 2.5 MB taşır, gönderilmesi gereken ise 88.1 MB’tır. Bir prefill all-reduce’unun süresi bu yüzden neredeyse tamamen bağlantının baytları ne kadar hızlı taşıdığıyla belirlenir; başka bir deyişle prefill iletişimi bant genişliğiyle sınırlıdır. All-reduce’lar arasında Spark’lar katmanın bir sonraki kısmını hesaplar; bu yüzden prefill trafiği, hesaplama boşluklarıyla ayrılmış, tam bağlantı hızında ya da ona yakın birkaç milisaniyelik patlamalar halinde görünmelidir. Bağlantı hızını yarıya indirmek her patlamanın süresini ikiye katlar ve ilk token’ı geciktirir.
4.2. Decode: sabit gecikmelerin belirlediği küçük aktarımlar
Decode sırasında her ileri yayılım her isteğin yalnızca en yeni token’ını işler. II. Kısım’daki gibi çok token’lı tahmin (multi-token prediction, MTP) ile spekülatif kod çözme kullanıldığında model aynı yayılımda 4 taslak token’ı da kontrol eder; böylece istek başına 5 token işler. Her all-reduce bu durumda 5 × 6,144 × 2 bayt = 61 KB toplar ve bunun için her Spark yaklaşık 108 KB gönderir. Çıktı katmanının token puanlarının toplanması dahil, ileri yayılım başına her Spark yaklaşık 18 MB gönderir.
108 KB göndermek 200 Gb/s’de 4.3 µs, 100 Gb/s’de 8.7 µs sürer. Ancak all-reduce sırayla 14 halka adımından geçer ve her birinin yazılımdan, senkronizasyondan ve ağ donanımından kaynaklanan sabit bir gecikmesi vardır. İki sistem arasındaki RDMA aktarımları çok küçük veri miktarlarında bile mikrosaniyeler mertebesinde sürer; bu gecikmeler baytları göndermeye harcanan süreden fazlasını tutar. Decode iletişimi bu yüzden gecikmeyle (latency) sınırlıdır ve süresi bağlantı hızına pek bağlı değildir.
Decode trafiğinin toplam miktarı da sınırlıdır. Her ileri yayılım en azından modelin aktif ağırlıklarını bellekten okumak zorundadır. GLM-5.3 token başına yaklaşık 40 milyar aktif parametreye sahiptir; bunların çoğu NVIDIA’nın 4 bitlik kayan nokta formatı NVFP4’te, ölçekleme faktörleri dahil ağırlık başına yaklaşık 4.5 bit ile saklanır. Bu, Spark başına yaklaşık 2.8 GB eder ve 273 GB/s’de okunması en az 10 ms sürer. Her ileri yayılım bu sınırda çalışsa bile decode trafiği tek bir istek için yaklaşık 14 Gb/s‘de ya da altında kalır, 100 Gb/s’nin çok altında; bağlantıyı yarıya indirmek de 10 ms ya da daha uzun süren her yayılıma en fazla 0.7 ms ekler. Aktarımlar gecikmeyle sınırlı olduğu için pratikte eklenen süre çok daha azdır.
Ağ bu yüzden cevabın ne kadar hızlı yazıldığını değil, prompt’un ne kadar hızlı okunduğunu belirler. Bağlantı hızının önem taşıdığı yer, geri getirmeyle zenginleştirilmiş üretim (RAG), uzun belgeler ya da geniş bağlamlı agent’lar gibi uzun prompt’lu iş yükleridir. Kısa sohbet prompt’ları bağlantıya neredeyse hiç dokunmaz ve decode hızı hiç değişmemelidir.
5. Bağlantıyı Yarıya İndirmenin Etkisini Tahmin Etmek
5.1. Üst sınır
Her prefill aktarımı tam bağlantı hızında çalışıyor ve hiçbiri hesaplamayla örtüşmüyorsa, bağlantı hızını B_old’dan B_new’e düşürmek tam olarak aynı baytları göndermek için gereken ek süreyi ekler:
ek prefill süresi ≤ Spark başına prefill baytı × (1 / B_new − 1 / B_old)
Bu bir üst sınırdır: hesaplamayla örtüşen ya da hiçbir zaman tam hıza ulaşmayan aktarımlar daha az ekler. Sınır için yalnızca Bölüm 3.3’teki prompt token’ı başına bayt miktarı ve prompt uzunluğu gerekir; Spark’ların ne kadar hızlı hesapladığına dair hiçbir bilgi gerekmez.
200’den 100 Gb/s’ye, (1/100 − 1/200) = 1/200 olduğu için ek süre, prefill baytlarının 200 Gb/s’de gönderilme süresine eşittir. GLM-5.3 ile TP8 için:
ek TTFT ≤ 3.38 MB × 8 bit ÷ 200 Gb/s = 1,000 prompt token’ı başına 0.135 s
5.2. Altı test durumu
| Test | Prompt token’ı | Spark başına prefill baytı | Ek prefill süresi, 200 → 100 Gb/s |
|---|---|---|---|
| P1: 1K prompt, 1 istek | 1,024 | 3.5 GB | ≤ +0.14 s |
| P2: 8K prompt, 1 istek | 8,192 | 27.7 GB | ≤ +1.11 s |
| P3: 32K prompt, 1 istek | 32,768 | 110.6 GB | ≤ +4.43 s |
| P4: aynı anda gelen 4 × 8K prompt | 32,768 | 110.6 GB | ≤ +4.43 s |
| P5: 64K prompt, 1 istek | 65,536 | 221.3 GB | ≤ +8.85 s |
| P6: aynı anda gelen 4 × 16K prompt | 65,536 | 221.3 GB | ≤ +8.85 s |
Dört istekli testlerde baytlar dört prompt’un tamamına aittir ve süre, dört istekten sonuncusunun ilk token’ını alana kadar geçen süredir.
5.3. Saniyeden yüzdeye
TTFT’nin payı olarak sınır şu hale gelir:
TTFT artışı ≤ ağ payı × (B_old / B_new − 1); 200 → 100 Gb/s için bu basitçe ≤ ağ payı olur;
burada ağ payı, prefill baytlarını 200 Gb/s’de göndermek için gereken sürenin prefill süresine bölümüdür.
Prefill süresinin kendisi mimariden güvenilir biçimde türetilemez. Aritmetik işlem sayısından ve GB10’un tepe hesaplama gücünden yapılan bir hesap bir büyüklük mertebesi kadar sapar; çünkü gerçek hız, motorun kernel’lerinin MoE uzmanlarını, attention’ı ve zamanlamayı ne kadar verimli işlediğine bağlıdır. Yüzde bu yüzden ölçülmüş bir girdiye, 200 Gb/s’deki TTFT’ye ihtiyaç duyar; bunu II. Kısım sağlar.
6. Kaybı Büyüten ve Küçülten Etkenler
Kayıp en fazla prefill süresindeki ağ payı kadar olduğu için, bu payı artıran her şey kaybı da artırır.
6.1. Prompt uzunluğu
Her prompt token’ı aynı 3.38 MB’a mal olur; bu yüzden baytlar prompt’la orantılı büyür. Matris hesaplaması da orantılı büyür. Her token’ı kendinden önceki token’larla karşılaştıran attention ise, her token’ın tüm bağlamla ilişki kurduğu bir modelde prompt’tan daha hızlı büyür; orada ağ payı, ve onunla birlikte yüzde olarak kayıp, çok uzun prompt’larda yavaşça düşer. GLM-5.3, her token’ın daha önceki yaklaşık 2,048 token’dan oluşan seçilmiş bir kümeyle ilişki kurduğu DeepSeek Sparse Attention (DSA) kullanır; bu yüzden hesaplaması prompt’la orantılıya yakın kalır ve uzun prompt’larda yüzde olarak kayıp kabaca sabit kalmalıdır. Saniye cinsinden kayıp ise her iki durumda da prompt uzunluğuyla büyümeye devam eder.
Kısa prompt’lar farklıdır. 1K token’lık bir prompt tek bir küçük prefill parçasına sığar ve her all-reduce’unda Spark başına yalnızca yaklaşık 22 MB gönderir; bu, 200 Gb/s’de bir milisaniyenin altındadır. Bu kadar kısa aktarımlar tam bağlantı hızına ulaşamayabilir ve her ileri yayılımın sabit ek yükü daha ağır basar; bu yüzden sınır etkiyi abartabilir.
6.2. Aynı anda birkaç istek
Birkaç prompt birlikte geldiğinde prefill parçaları ileri yayılımları paylaşır. Prompt token’ı başına bayt aynı kalır, ancak token başına hesaplama düşer; çünkü her prompt daha kısa bir bağlam üzerinde attention yapar ve iş daha dolu batch’lerde yürür. Sürenin daha büyük bir kısmı iletişime gider; bu yüzden kayıp, aynı toplam uzunluktaki tek bir prompt’tan daha büyüktür. Motorun prompt’ları hangi sırayla işlediği ve ilklerinin ne zaman üretime başladığı da her isteğin kendi TTFT’sini etkiler.
6.3. TP boyutu
TP8’e göre, Spark başına token başına bayt ve Spark başına hesaplama şöyle değişir:
| TP boyutu | Spark başına bayt | Spark başına hesaplama |
|---|---|---|
| TP2 | 0.57× | 4× |
| TP4 | 0.86× | 2× |
| TP8 | 1× | 1× |
| TP16 | 1.07× | 0.5× |
Ağ payı, ve onunla birlikte kayıp, TP boyutuyla hızla büyür: düşük bağlantı hızını kabul etmek düşük TP boyutlarında en kolaydır ve bir model daha fazla Spark’a yayıldıkça daha pahalıya mal olur. Bölüm 10, ölçülen TP8 temel değerini kullanarak bunu sayılara döker.
II. Kısım: Ölçüm
7. Test Tasarımı
7.1. Yalnızca bağlantıyı değiştirmek
Karşılaştırma ancak bağlantı hızı iki yapılandırma arasındaki tek fark olduğunda işe yarar. İkisinde de aynı model, motor, ayarlar, prompt’lar ve test planı kullanıldı; yalnızca ağ yolu değişti.
7.2. Kurulum
| Öğe | Değer |
|---|---|
| Sistemler | 8× NVIDIA DGX Spark (GB10, 128 GB birleşik bellek), sürücü 580.173.02 |
| Switch | MikroTik CRS804, 400G QSFP-DD portlar 2 × 200G breakout ile |
| Model | GLM-5.3 NVFP4 (Inferact/GLM-5.3-NVFP4): 753B parametreli MoE, token başına yaklaşık 40B aktif; gizli boyut 6,144; 78 katman; DeepSeek Sparse Attention |
| Motor | vLLM 0.1.dev20133+gb5f995e73 (container vllm-node-b12x), PyTorch 2.13, NCCL 2.28.3, Ray |
| Paralellik | TP8: 8 Spark’ın tamamına yayılmış tek bir model örneği |
| Temel ayarlar | en fazla 4,096 token’lık prefill parçaları, FP8 KV cache, MTP ile spekülatif kod çözme (4 taslak token; taslak model Spark’lara bölünmez, bu yüzden ağ trafiği eklemez), CUDA graph’ları, en fazla 8 eşzamanlı istek |
GLM-5.3, 8 Spark’ın tamamına ihtiyaç duyan büyük bir MoE modelidir; cluster ağının en çok önem taşıdığı durum budur.
7.3. 100 Gb/s’yi emüle etmek
100 Gb/s durumu yeni kablolarla kurulmak yerine emüle edildi: NCCL, her Spark’taki iki ağ arayüzünden yalnızca birini kullanacak şekilde yapılandırıldı (NCCL_IB_HCA ikinci RDMA cihazını dışarıda bırakacak şekilde). Fiziksel olarak hiçbir şey değişmez; kablolar, switch portları ve diğer tüm ayarlar aynı kalır ve modeli bu ayar olmadan yeniden başlatmak 200 Gb/s’yi geri getirir. Her emüle edilmiş koşuda benchmark, adaptörün sayaçlarından tüm trafiğin kalan tek arayüz üzerinden geçtiğini doğruladı.
Tek bir arayüz, PCIe Gen5 ×4 bağlantısının izin verdiği kadarını taşır: 4 hat × 32 GT/s, hat kodlamasıyla (128b/130b) 126 Gb/s’ye, PCIe paket ve akış kontrolü ek yüküyle yaklaşık 111 Gb/s‘ye düşer. ib_write_bw ile ölçüldüğünde tek bir arayüz 109 Gb/s taşır. Emüle edilmiş bağlantı bu yüzden gerçek bir 100 Gb/s bağlantıdan yaklaşık %9 daha hızlıdır.
B_new = 100 yerine 109 Gb/s alındığında Bölüm 5.1’deki sınır şu hale gelir:
ek prefill süresi ≤ prefill baytı × (1/109 − 1/200); GLM-5.3 ile TP8 için 1,000 prompt token’ı başına yaklaşık 0.11 s
| Test | Tahmin, 200 → 100 Gb/s (Bölüm 5.2) | Tahmin, 200 → 109 Gb/s (bu deney) |
|---|---|---|
| P1: 1K | ≤ +0.14 s | ≤ +0.12 s |
| P2: 8K | ≤ +1.11 s | ≤ +0.92 s |
| P3: 32K | ≤ +4.43 s | ≤ +3.69 s |
| P4: 4 × 8K | ≤ +4.43 s | ≤ +3.69 s |
| P5: 64K | ≤ +8.85 s | ≤ +7.39 s |
| P6: 4 × 16K | ≤ +8.85 s | ≤ +7.39 s |
Bölüm 9, ölçülen sonuçları gerçek bir 100 Gb/s kabloya geri dönüştürür.
7.4. Test planı
| Test | İstekler | Prompt → çıktı token’ı | Amaç |
|---|---|---|---|
| P1 | 1 | 1,024 → 1,024 | küçük aktarımlı kısa bir prompt |
| P2 | 1 | 8,192 → 1,024 | tipik bir uzun prompt |
| P3 | 1 | 32,768 → 1,024 | uzun bir belge |
| P4 | 4, aynı anda gelen | 4 × 8,192 → 1,024 | birkaç istek, P3 ile aynı toplam prompt boyutu |
| P5 | 1 | 65,536 → 1,024 | çok uzun bir prompt |
| P6 | 4, aynı anda gelen | 4 × 16,384 → 1,024 | birkaç istek, P5 ile aynı toplam prompt boyutu |
Her test, sayılmayan bir ısınma turu ve üç ölçüm turu koştu. Çıktı tam olarak 1,024 token’a sabitlendi; böylece her istek aynı miktarda decode yaptı ve decode hızları doğrudan karşılaştırılabilir oldu.
7.5. Neler ölçüldü
- TTFT (time to first token, ilk token süresi): bir isteğin gönderilmesinden ilk token’ının alınmasına kadar geçen süre. P4 ve P6 için dört istekten sonuncusunun ilk token’ını alana kadar geçen süre de raporlanır; bu süre dört prompt’un tüm baytlarını kapsar ve tahminin tarif ettiği büyüklüktür.
- Decode hızı: cevabın ne kadar hızlı aktığı, ilk token’dan sonra saniye başına token olarak: (çıktı token’ı − 1) ÷ (son token’ın zamanı − ilk token’ın zamanı). Tüm istek süresine, TTFT dahil, bölen bir saniye başına token değeri decode karşılaştırmalarında kullanılmaz; çünkü decode hızı değişmediğinde bile uzun prompt’larla düşer.
- Ağ trafiği: tek bir Spark’ın ConnectX-7’sinin RDMA sayaçlarından baytlar ve hızlar (Ek A). Halka all-reduce’ta her Spark aynı miktarı gönderdiği için tek bir Spark sekizini de temsil eder.
7.6. Koşuları karşılaştırılabilir tutmak
Prompt’lar sabit bir prompt kümesinden alındı ve sabit bir rastgele tohumla hedef uzunluğa dolduruldu; böylece iki yapılandırma da aynı prompt’ları aldı. Her isteğin dolgusu farklı sıralandı; böylece motor daha önceki bir istekten önbelleğe alınmış işi yeniden kullanamadı. Test için gerekmeyen servisler tüm Spark’larda durduruldu ve her koşu ancak bağlantı 10 saniye boyunca hiç trafik taşımadıktan sonra başladı. İstekler ve trafik örnekleri aynı Spark’ta ve aynı saatle zaman damgalandı; böylece her isteğin prefill ve decode trafiği tam olarak ayrılabilir.
Tüm ölçüm turları kullanıldı ve turlar arasındaki aralıkla birlikte ortalama olarak raporlandı. Turlar tutarlıydı: bir test içinde prefill süreleri tek isteklerde en fazla 0.6 s, dört istekte en fazla 1.2 s değişti.
8. Sonuçlar: TP8’de 200 Gb/s ve Emüle Edilmiş 100 Gb/s
8.1. Cluster 200 Gb/s’nin ne kadarını kullanıyor
Şekil 4, 200 Gb/s’lik cluster’da 8K token’lık tek bir istek sırasında bir Spark’ın gönderdiği trafiği gösteriyor. Prefill sırasında, Bölüm 4.1’de anlatıldığı gibi, tam bağlantı hızına yakın birkaç milisaniyelik patlamalar Spark’ların hesap yaptığı boşluklarla dönüşümlü olarak görülür; 200 ms’lik yakınlaştırmada her patlama bir prefill all-reduce’udur. İlk token’dan sonra decode trafiği düşük ve sabittir.
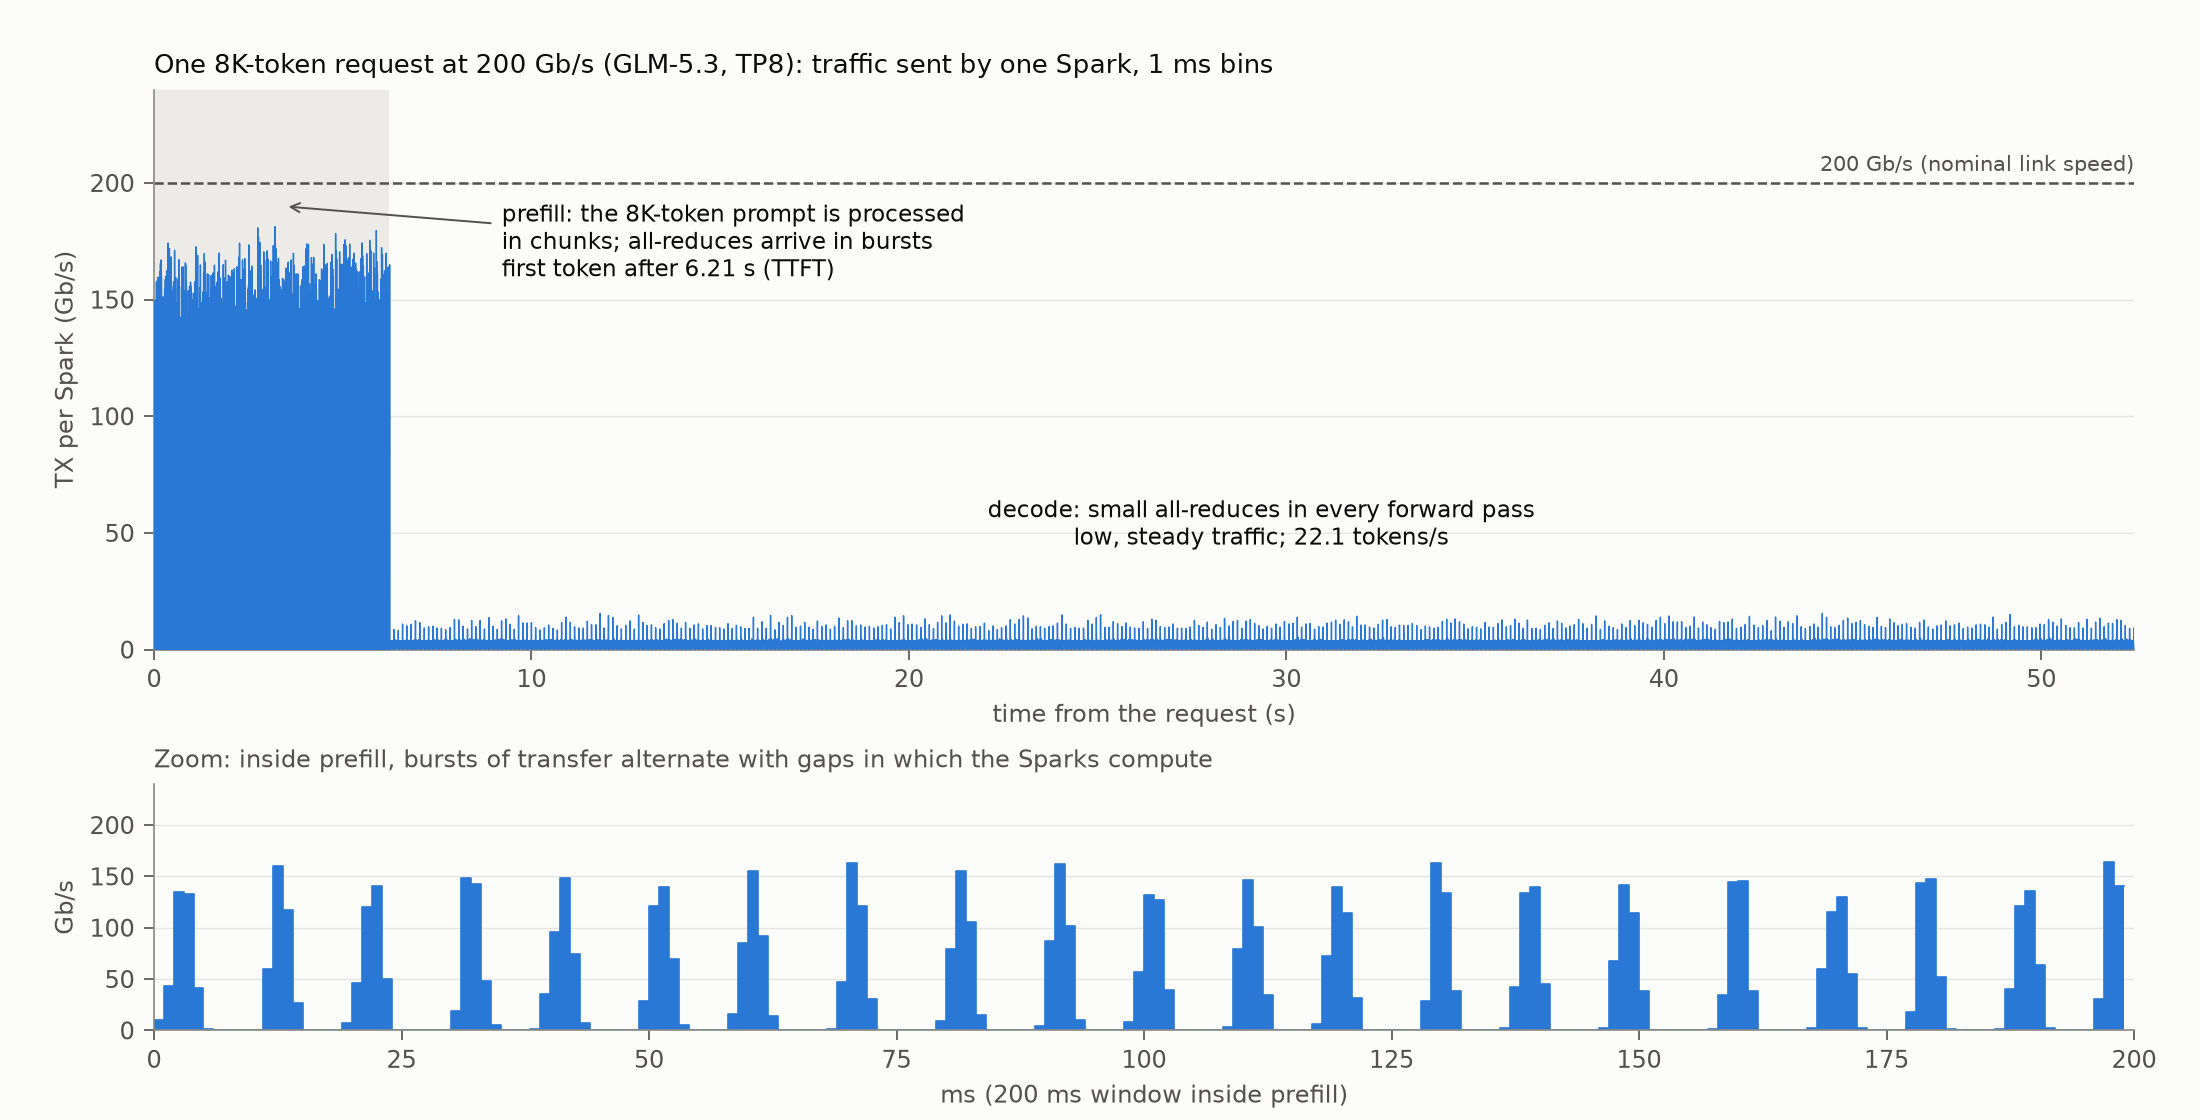
Şekil 4: 200 Gb/s’de 8K token’lık tek bir istek, bir Spark’ın gönderdiği trafik, 1 ms aralıklarla; altta prefill içinden 200 ms’lik bir pencere.
1 ms aralıklarla ölçüldüğünde, 8K–64K’lık tekil prompt’ların patlamaları yaklaşık 150–180 Gb/s’ye, aynı anda gelen dört prompt’unkiler ise 200 Gb/s’ye yakın değerlere ulaşır. Ancak 8K’lık bir prefill’in tamamı üzerinden ortalaması alındığında trafik 37 Gb/s’dir; çünkü Spark’lar hesap yaparken bağlantı hiçbir şey taşımaz. Decode ortalaması tek istek için yaklaşık 3 Gb/s, dört istek için yaklaşık 6 Gb/s‘dir; bu değerler Bölüm 4.2’de tahmin edilen sınırların içindedir. Cluster 200 Gb/s’nin tamamını kullanır, ama bir seferde yalnızca birkaç milisaniye için.
Bir ölçümün bu iki tablodan hangisini göstereceğini ortalama alma aralığı belirler. Aynı 8K prefill şu en yüksek değerleri verir:
| Ortalama alma aralığı | En yüksek değer |
|---|---|
| 1 ms | 181 Gb/s |
| 5 ms | 96 Gb/s |
| 100 ms | 44 Gb/s |
| 1 s | 40 Gb/s |
| prefill’in tamamı (ortalama) | 37 Gb/s |
Bir saniyelik ortalamalar raporlayan bir switch yaklaşık 40 Gb/s gösterir ve neredeyse boşta bir bağlantı izlenimi verir. TTFT’yi belirleyen patlamalar yalnızca milisaniye çözünürlüğünde görünür (Ek A).
8.2. Her testteki trafik
Şekil 5–10, her testin üç ölçüm turu sırasında bir Spark’ın gönderdiği trafiği, üstte 200 Gb/s ve altta emüle edilmiş 100 Gb/s olmak üzere aynı zaman ekseninde gösteriyor. Gri bant prefill’dir ve ilk token’da biter.
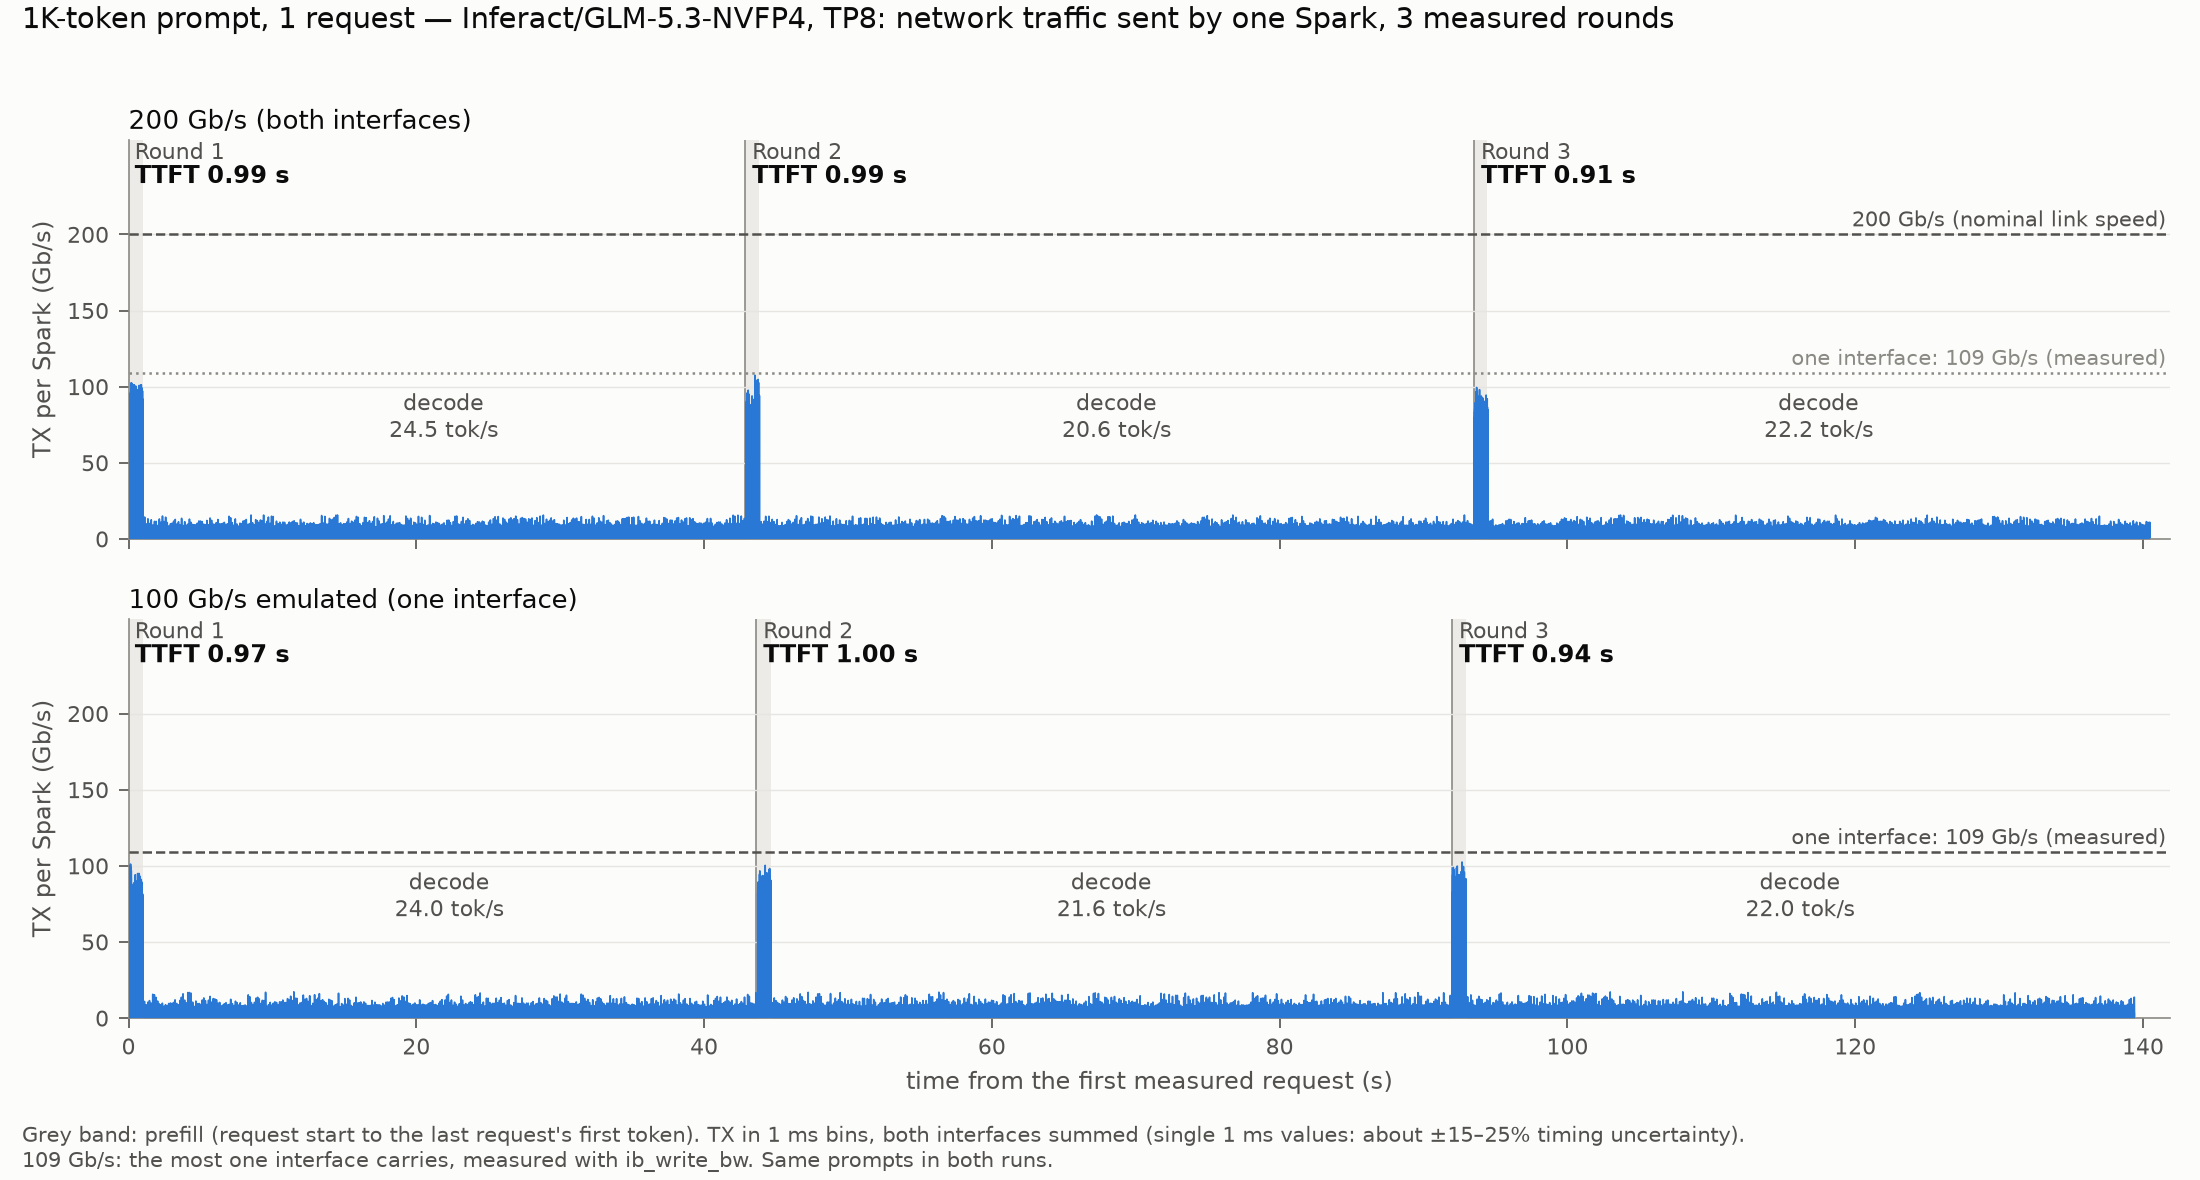
Şekil 5: P1, 1K token’lık prompt, 1 istek.
1K’lık bir prompt’ta prefill patlamaları 200 Gb/s’lik cluster’da bile yalnızca yaklaşık 100 Gb/s’ye ulaşır; bu, tek bir arayüzün taşıyabileceğinin altındadır, bu yüzden emüle edilmiş bağlantı onları yavaşlatmaz. TTFT her iki bağlantı hızında da aynıdır: 0.96 s ve 0.97 s.
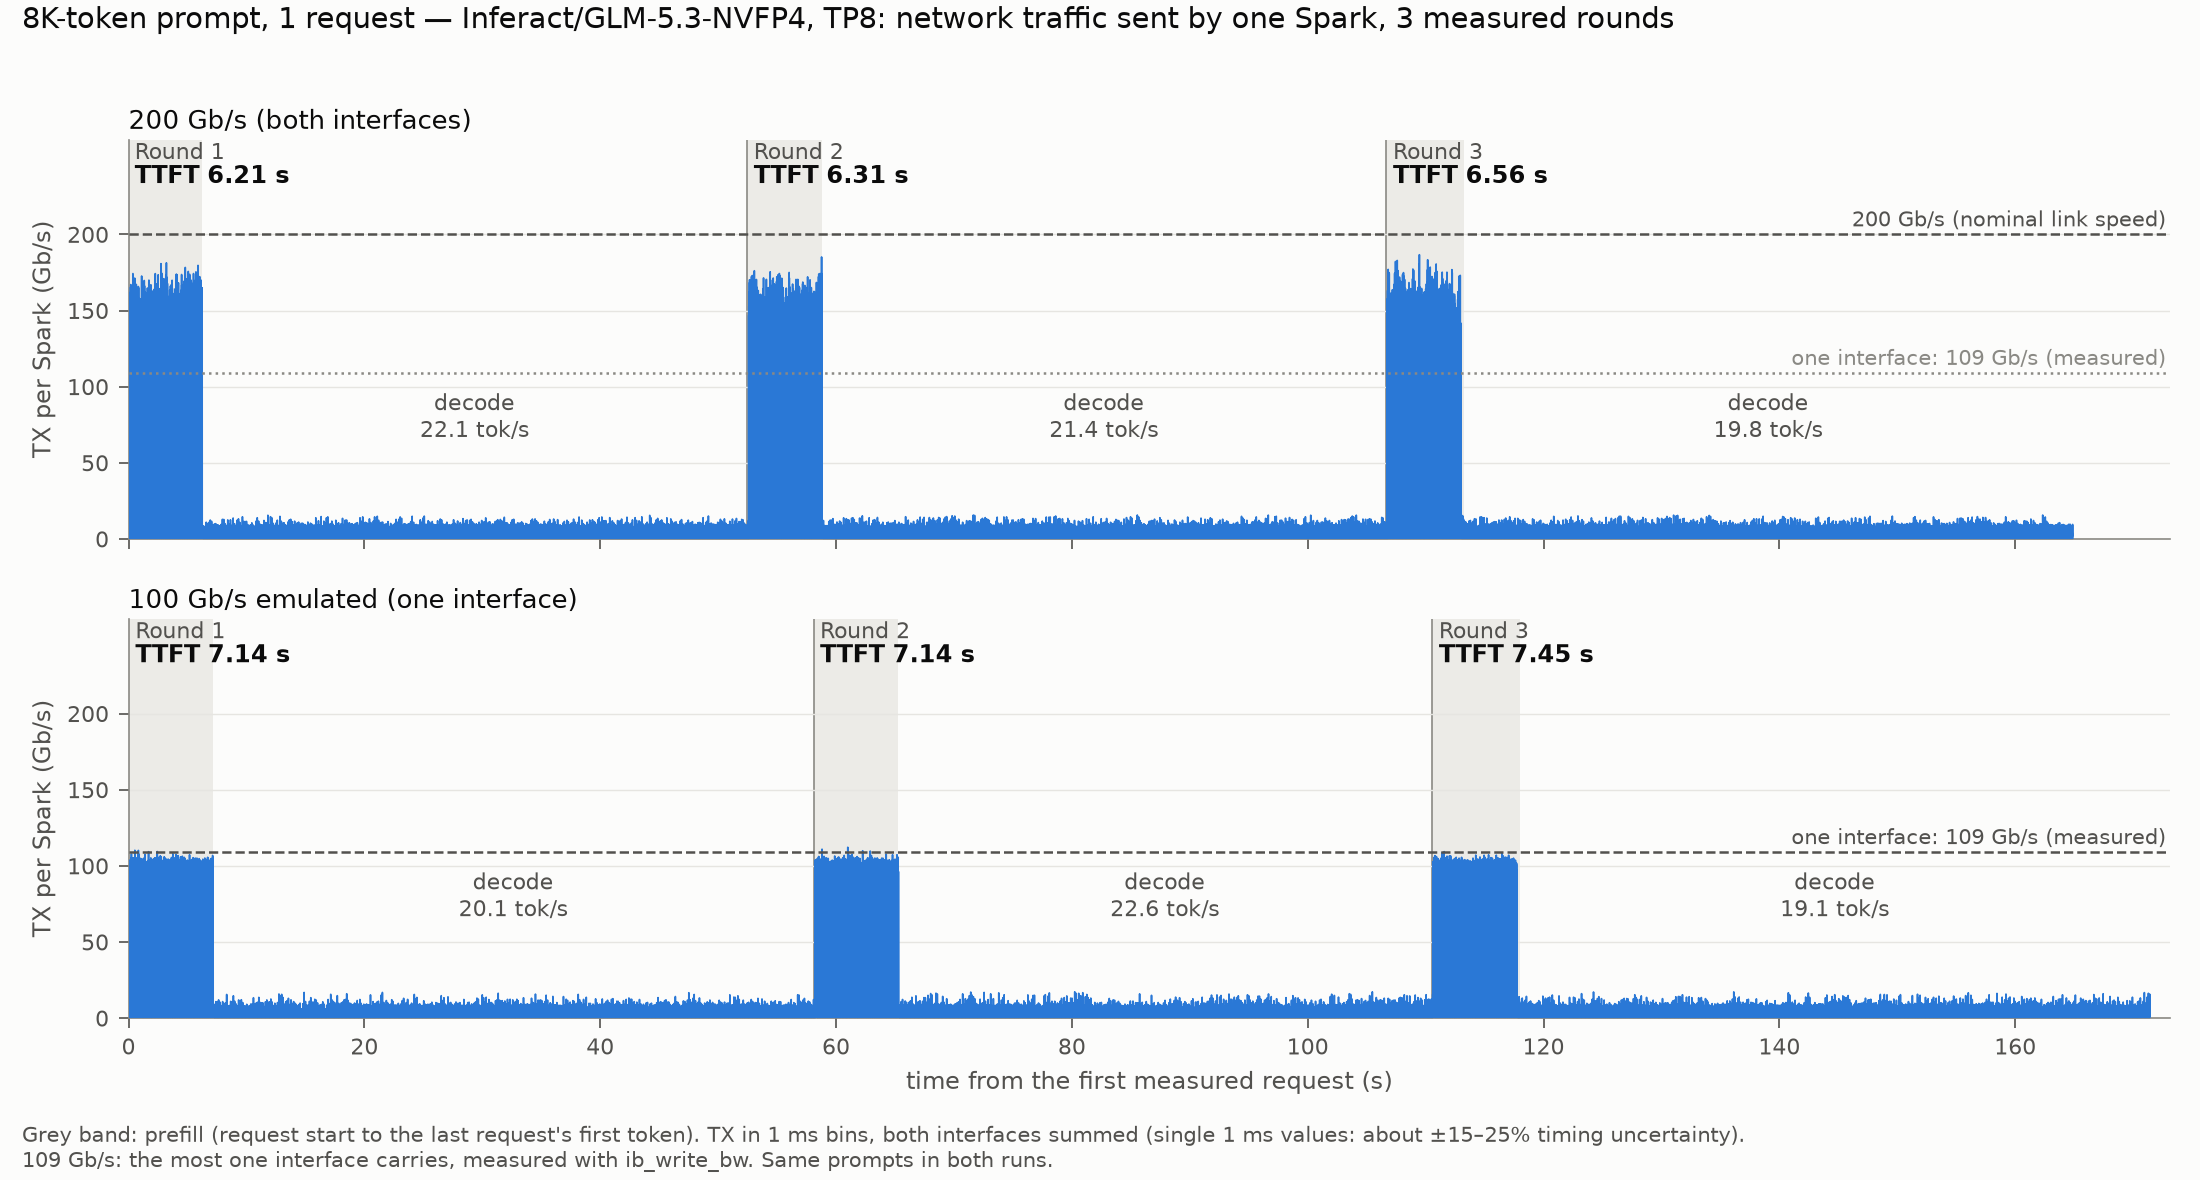
Şekil 6: P2, 8K token’lık prompt, 1 istek.
8K’lık bir prompt’ta prefill 200 Gb/s’de yaklaşık 150–180 Gb/s’de çalışır. Emüle edilmiş bağlantıda aynı patlamalar yaklaşık 105–109 Gb/s’de tutulur ve daha uzun sürer; TTFT 6.36 s’den 7.24 s’ye çıkar. Decode trafiği iki panelde de aynı görünür.
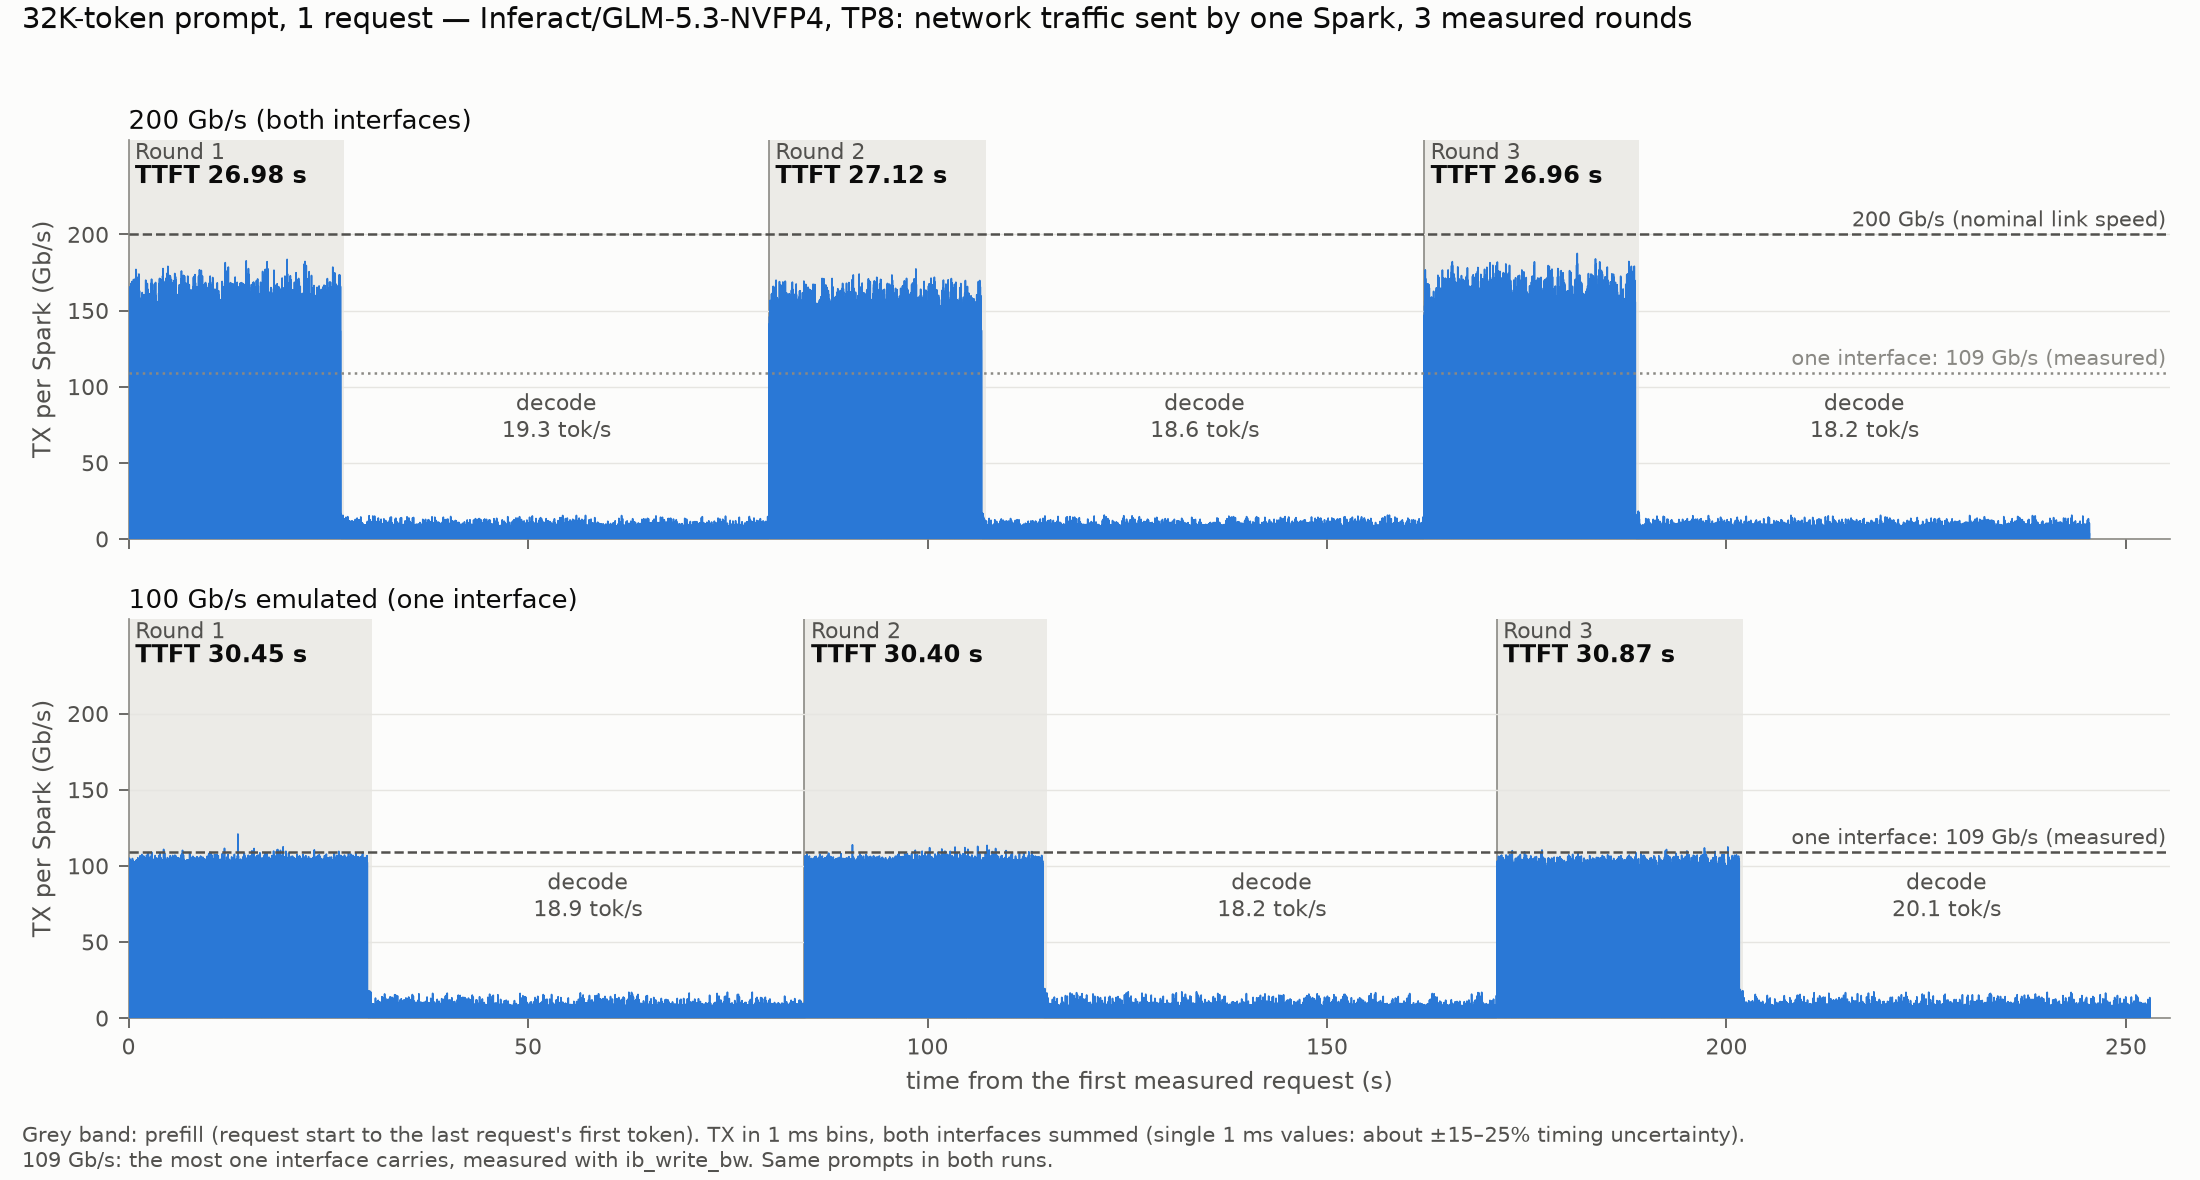
Şekil 7: P3, 32K token’lık prompt, 1 istek.
32K’lık prompt aynı örüntüyü daha uzun bir prefill boyunca gösterir; TTFT 27.0 s’den 30.6 s’ye çıkar.
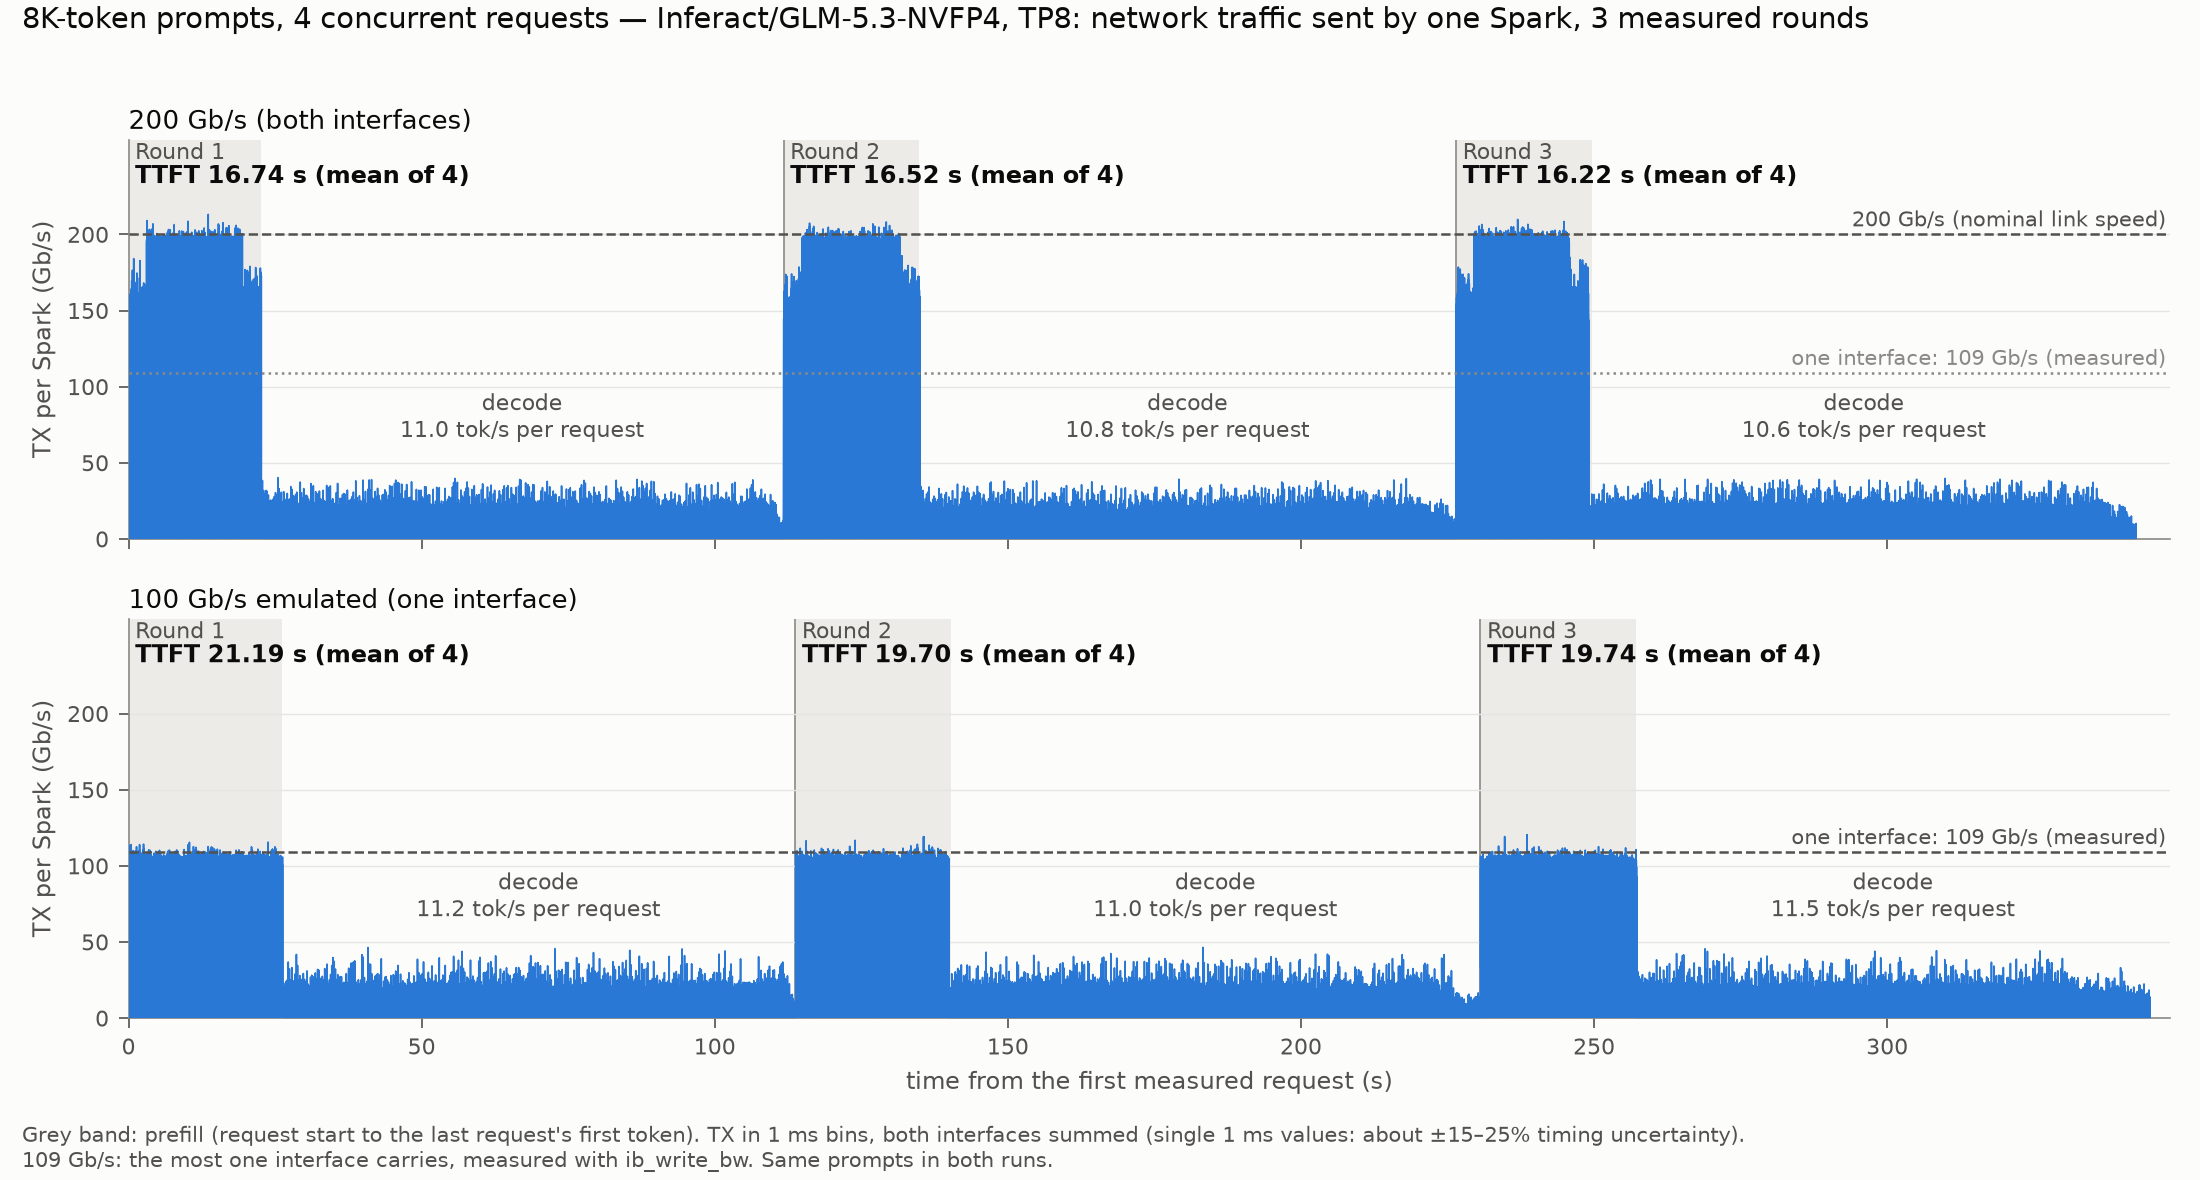
Şekil 8: P4, aynı anda gelen dört 8K token’lık prompt.
Dört prompt aynı anda geldiğinde prefill, 200 Gb/s’lik bağlantıyı neredeyse tamamen kullanılır halde tutarken, emüle edilmiş bağlantı baştan sona 109 Gb/s’de kalır. Son ilk token’a kadar geçen süre 23.0 s’den 26.4 s’ye çıkar. Decode trafiği dört istekte daha yüksektir, ama yine de iki bağlantı hızının da çok altındadır.
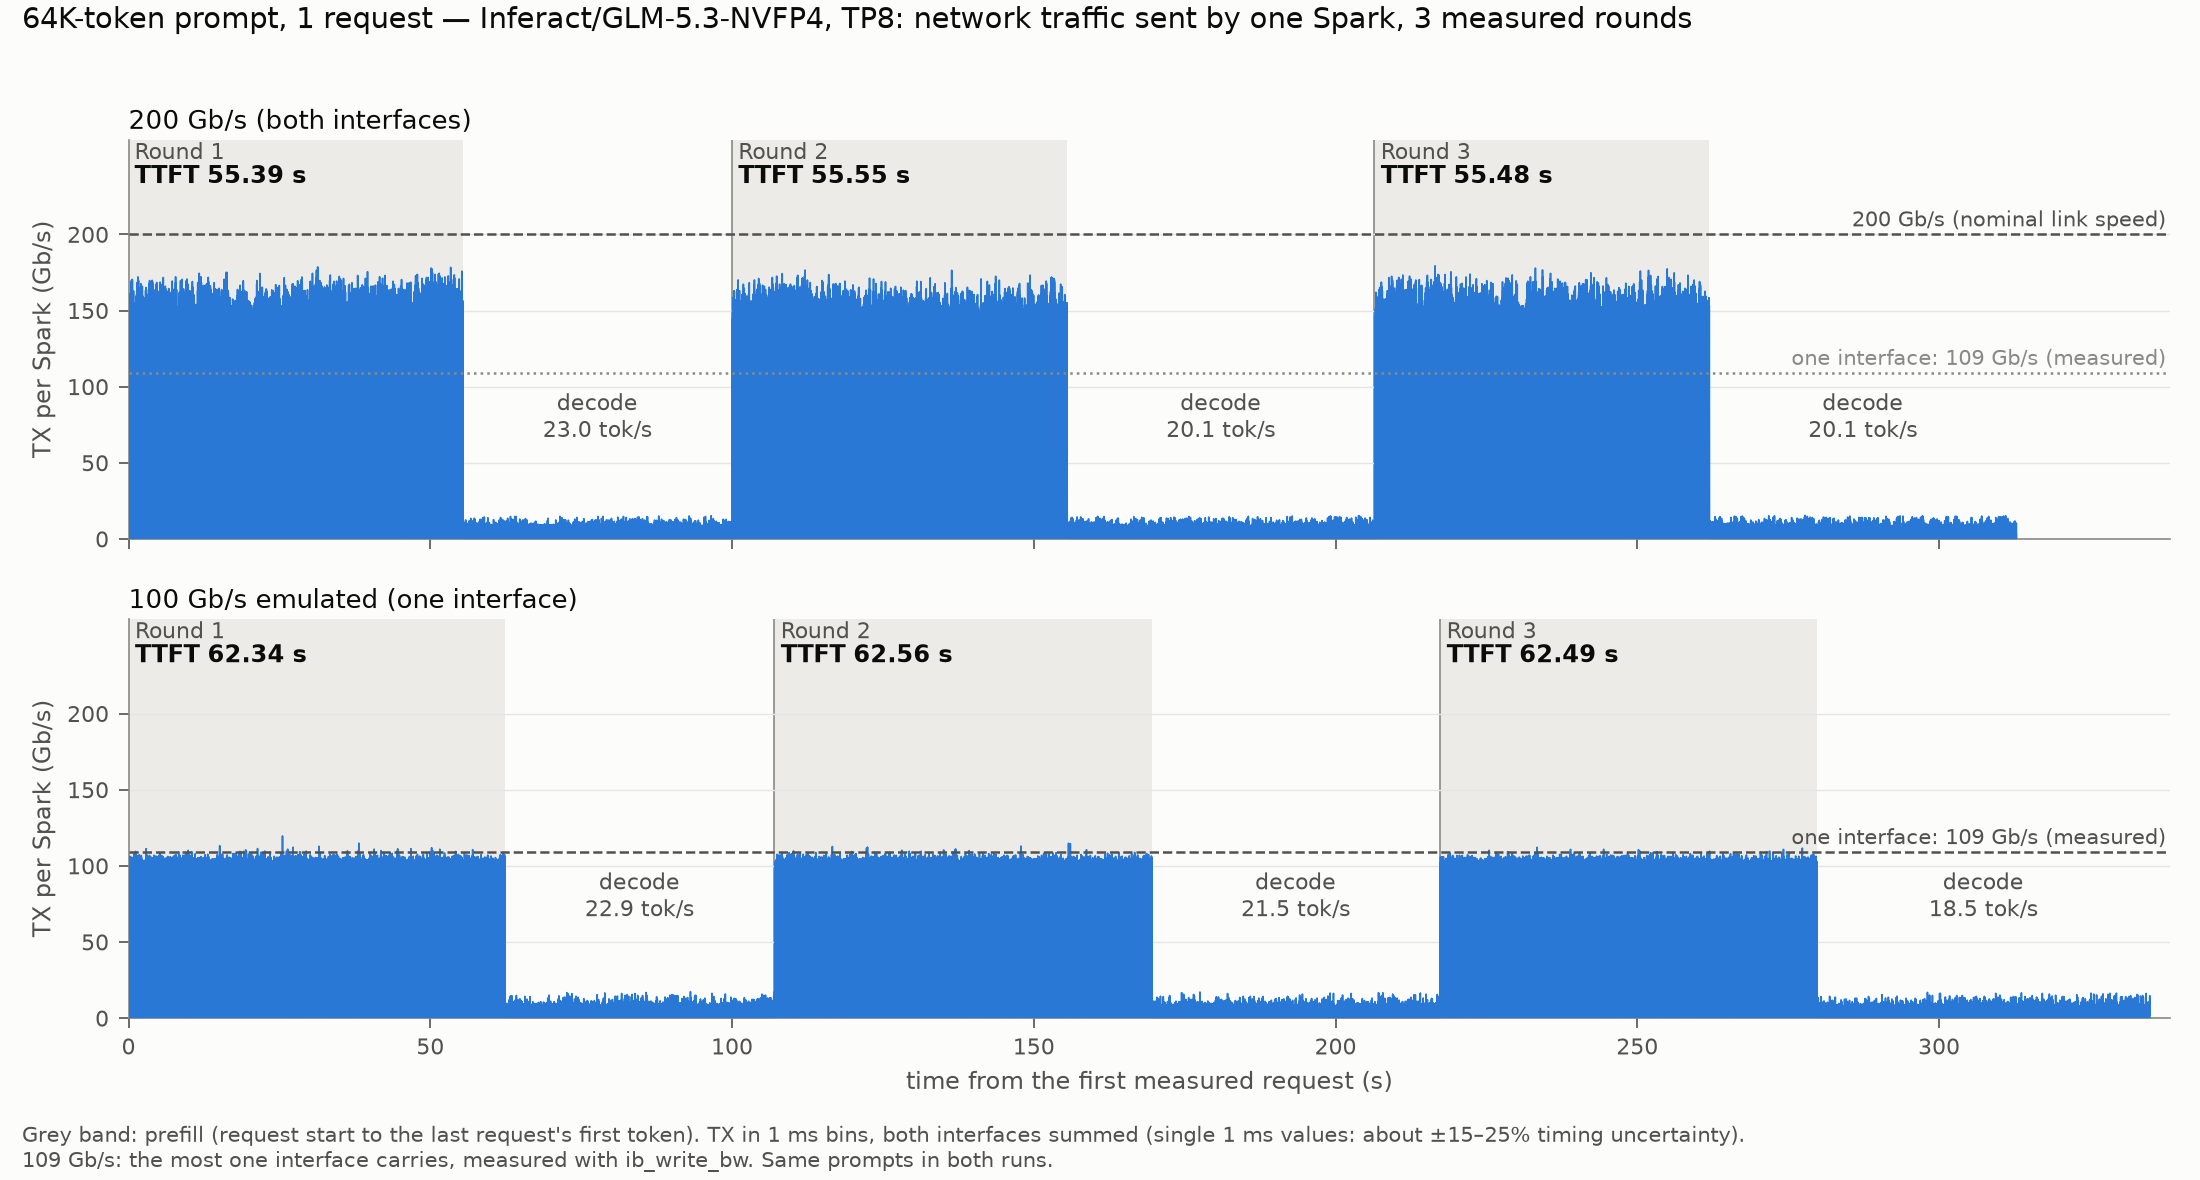
Şekil 9: P5, 64K token’lık prompt, 1 istek.
64K’lık prompt, iki kat uzunlukta 32K’lık prompt gibi davranır: 200 Gb/s’de yaklaşık 150–180 Gb/s’lik patlamalar, emüle edilmiş bağlantıda 109 Gb/s’de tutulur ve TTFT 55.5 s’den 62.5 s’ye çıkar. Üç tur 0.2 s içinde birbiriyle uyumludur.
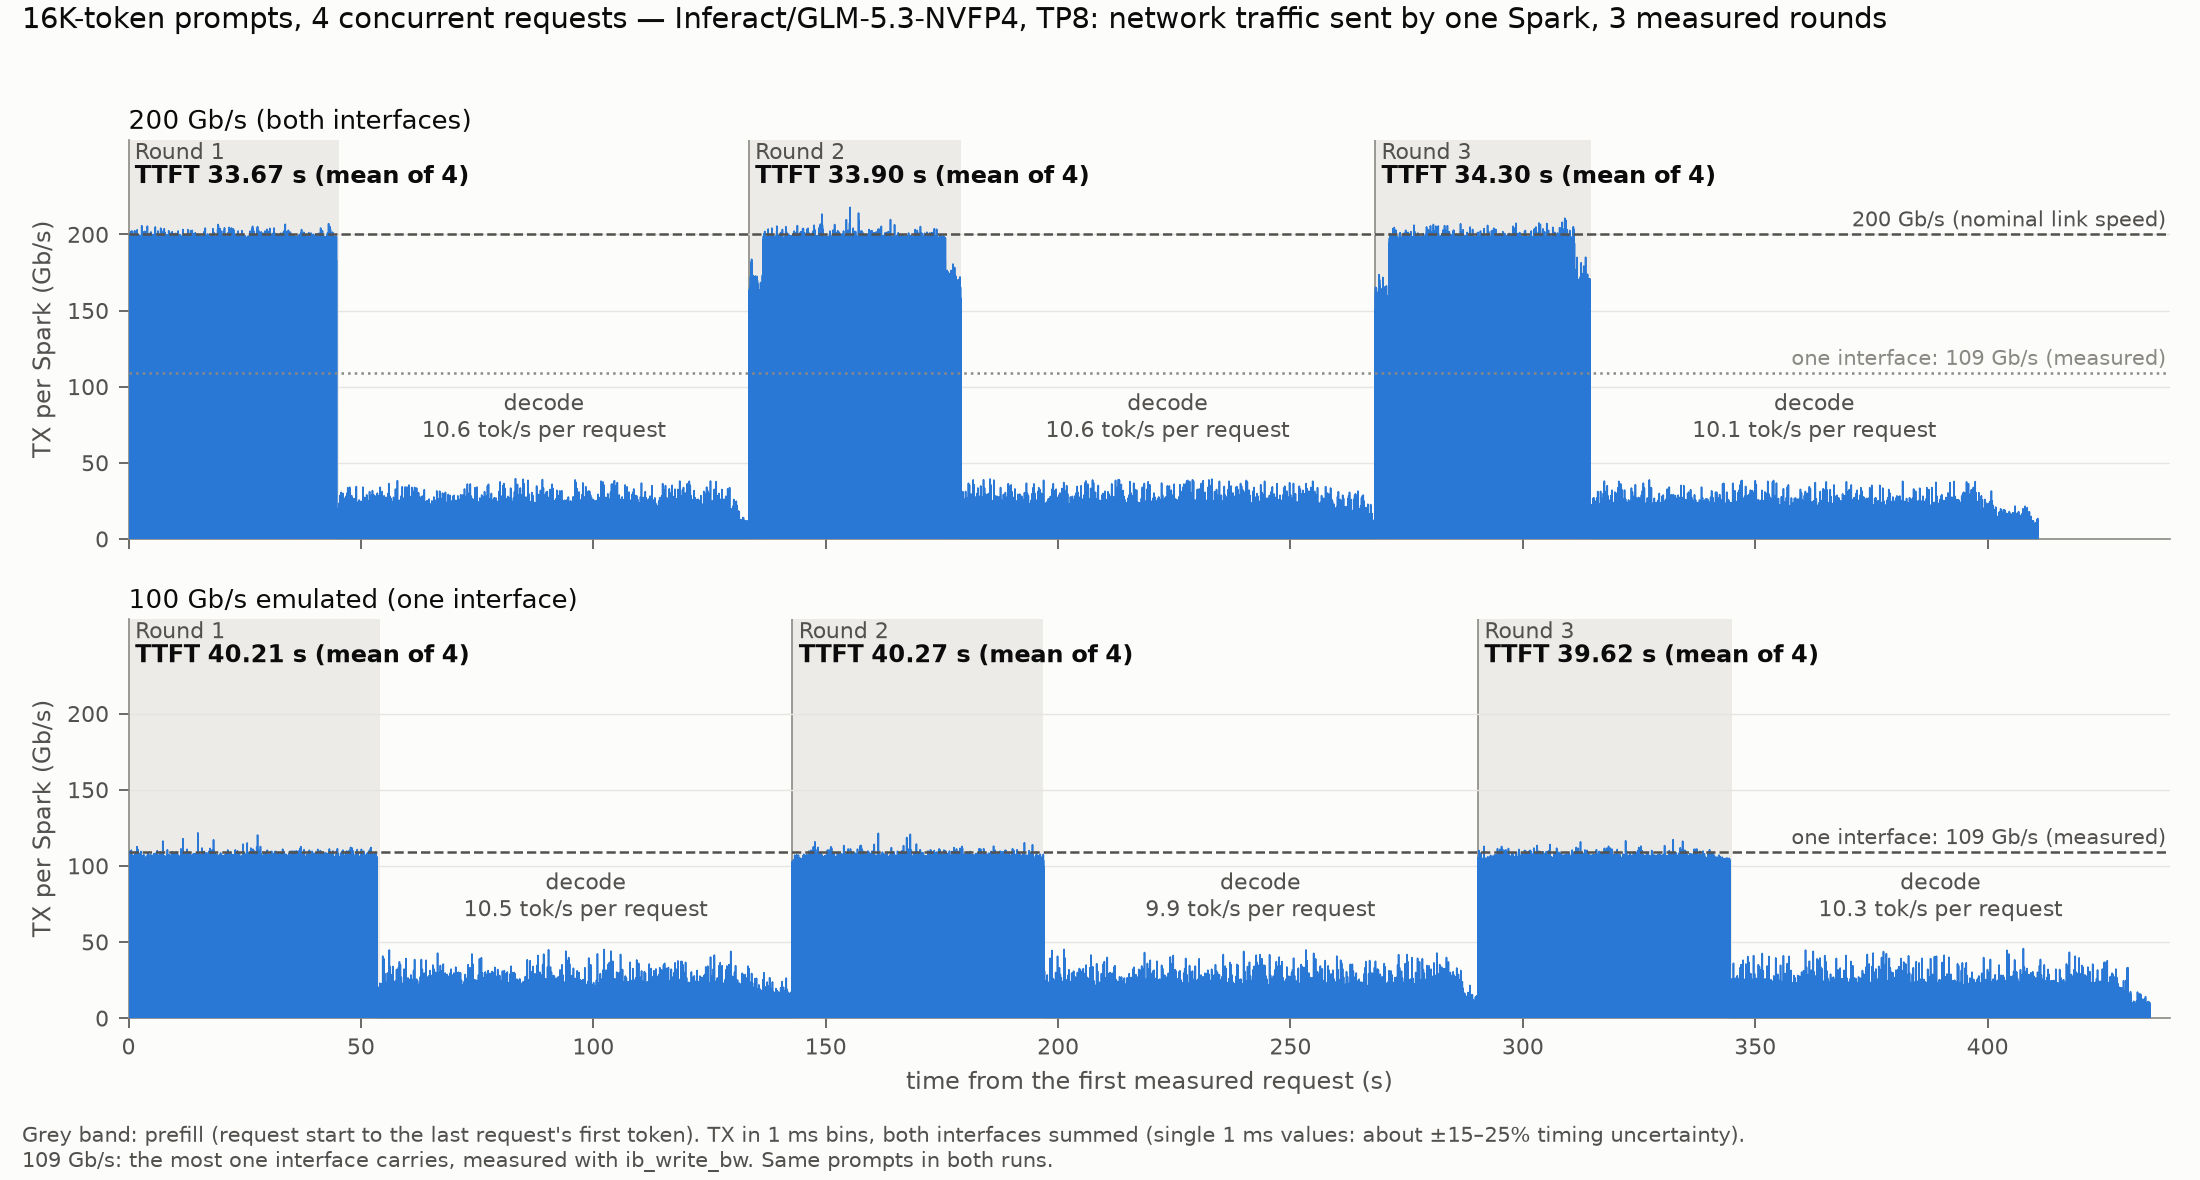
Şekil 10: P6, aynı anda gelen dört 16K token’lık prompt.
Dört 16K’lık prompt’ta prefill, 200 Gb/s’lik bağlantıyı yaklaşık 46 s boyunca neredeyse tamamen kullanılır halde tutar; emüle edilmiş bağlantıda bu, 109 Gb/s’de yaklaşık 54 s’dir. Motor dört prompt’u çiftler halinde işler: ilk ikisi ilk token’larını yaklaşık 22 s’de (200 Gb/s) ve 27 s’de (emüle edilmiş), son ikisi yaklaşık 45 s’de ve 54 s’de alır. İkinci çift hâlâ prefill’deyken ilk çift zaten decode yapmaktadır.
8.3. Prompt token’ı başına trafik
Ölçülen prefill trafiği Spark başına prompt token’ı başına 3.54–3.60 MB oldu; bu, Bölüm 3.3’teki 3.38 MB’tan %5–7 fazladır. Fark, ağ paketlerinin başlıklarından ve istek başına küçük bir miktar trafikten kaynaklanır. Baytlar her iki bağlantı hızında da aynıydı; bu, yalnızca bağlantı hızının değiştiğini doğrular.
8.4. TTFT
Üç turun ortalamaları, parantez içinde turlar arasındaki aralıkla; P4 ve P6 için dört istekten sonuncusunun ilk token’ını alana kadar geçen süre. Karşılaştırma için emüle edilmiş bağlantıya ait tahmin (Bölüm 7.3) de verilmiştir.
| Test | 200 Gb/s | 100 Gb/s (emüle edilmiş, 109 Gb/s) | Artış |
|---|---|---|---|
| P1: 1K | 0.96 s (0.91–0.99) | 0.97 s (0.94–1.00) | +0.01 s (+%1.1), ölçülebilir fark yok (tahmin: ≤ +0.12 s) |
| P2: 8K | 6.36 s (6.21–6.56) | 7.24 s (7.14–7.45) | +0.88 s (+%13.9) (tahmin: ≤ +0.92 s) |
| P3: 32K | 27.02 s (26.96–27.12) | 30.57 s (30.40–30.87) | +3.55 s (+%13.1) (tahmin: ≤ +3.69 s) |
| P4: 4 × 8K, son ilk token | 23.00 s (22.61–23.19) | 26.44 s (26.20–26.59) | +3.44 s (+%15.0) (tahmin: ≤ +3.69 s) |
| P5: 64K | 55.47 s (55.39–55.55) | 62.47 s (62.34–62.56) | +6.99 s (+%12.6) (tahmin: ≤ +7.39 s) |
| P6: 4 × 16K, son ilk token | 45.82 s (45.36–46.52) | 54.26 s (54.08–54.60) | +8.44 s (+%18.4) (tahmin: ≤ +7.39 s) |
Her turun dört isteği üzerinden ortalama alındığında TTFT, P4’te 16.49 s’den 20.21 s’ye (+%22.5), P6’da 33.96 s’den 40.03 s’ye (+%17.9) çıktı. Bunlar, herhangi bir testte ölçülen en büyük artışlardır.
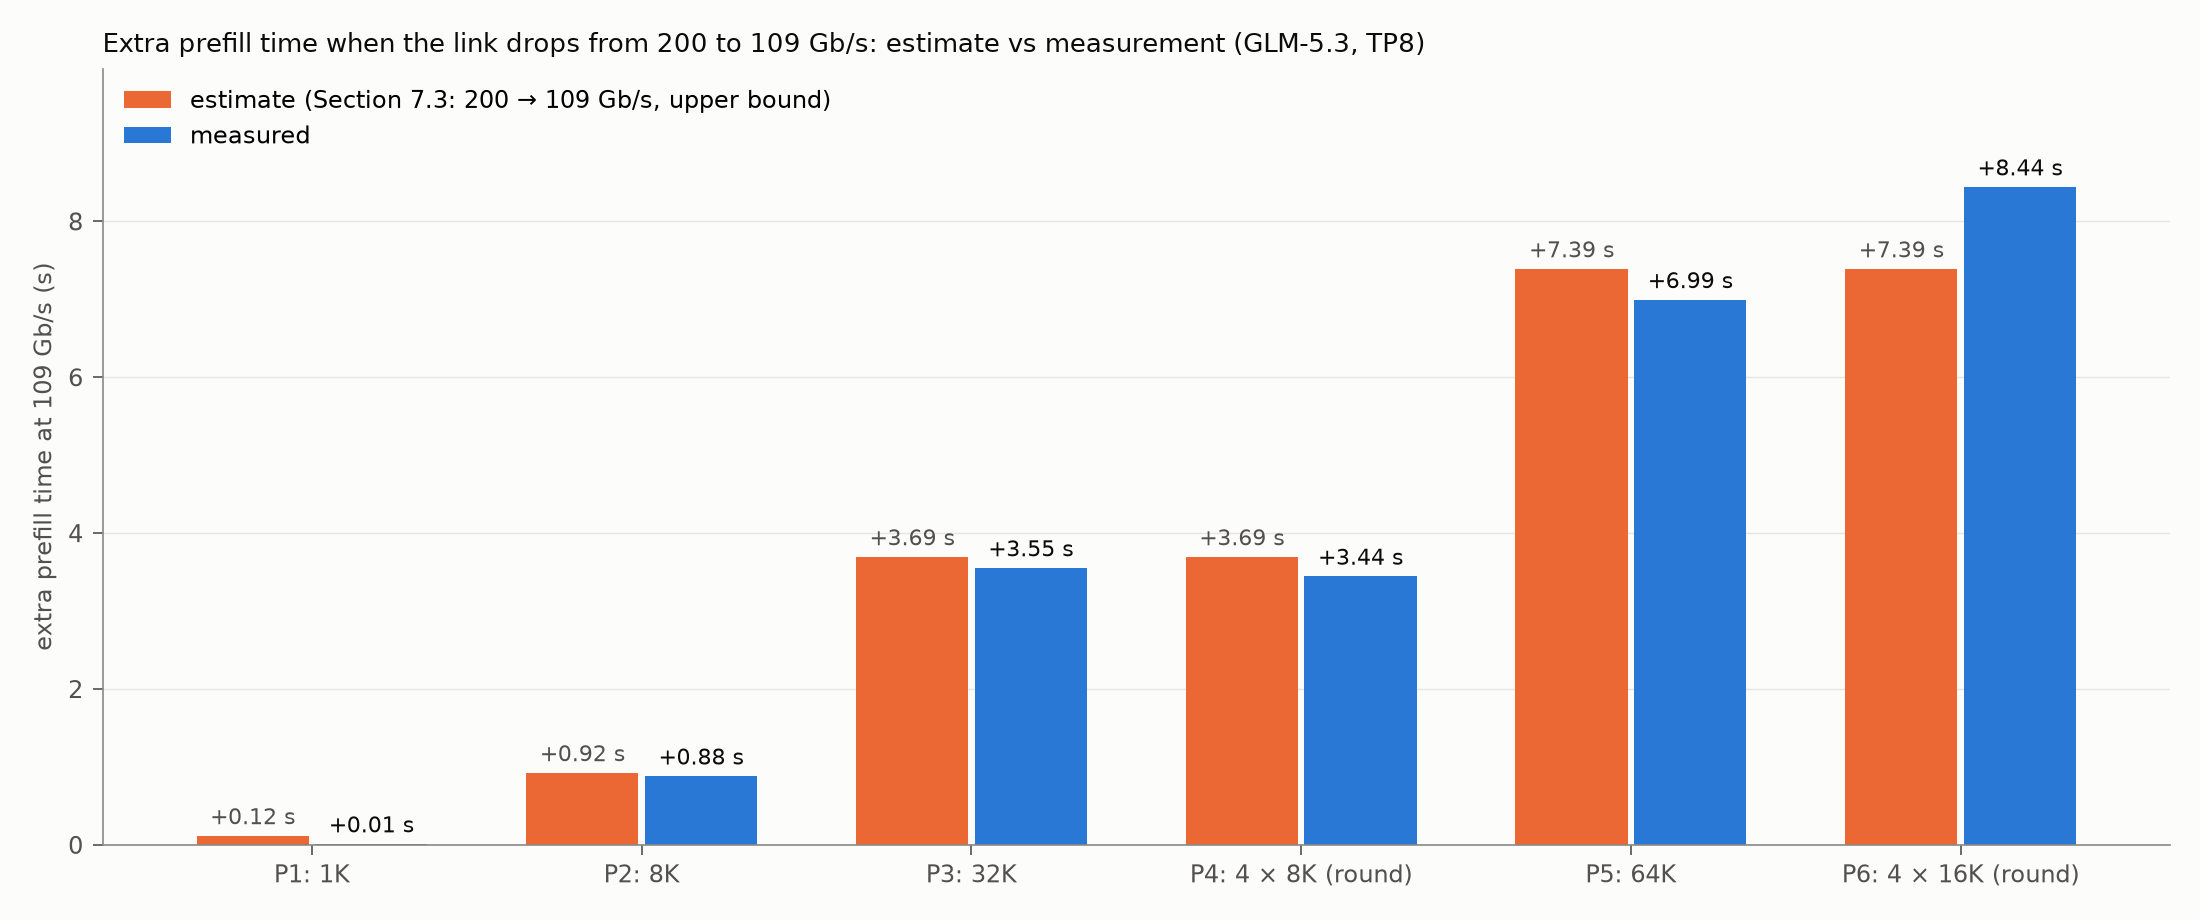
Şekil 11: Bağlantı 200’den 109 Gb/s’ye düştüğünde ek prefill süresi: tahmin (Bölüm 7.3) ve ölçüm.
8K–64K token’lık tekil prompt’larda ve aynı anda gelen dört 8K’lık prompt’ta ölçülen artış, tahminin birkaç yüzde yakınında ve bir üst sınırdan beklendiği gibi biraz altında kaldı: aktarımların küçük bir kısmı hesaplamayla örtüşür. Modelin mimarisinden, motorun prefill parçası boyutundan ve bağlantı hızından yapılan tahmin, hesaplamaya dair hiçbir ölçüm gerektirmeden daha yavaş bir bağlantının etkisini iyi öngörür. Saniye cinsinden artış 1,000 prompt token’ı başına yaklaşık 0.11 s‘dir.
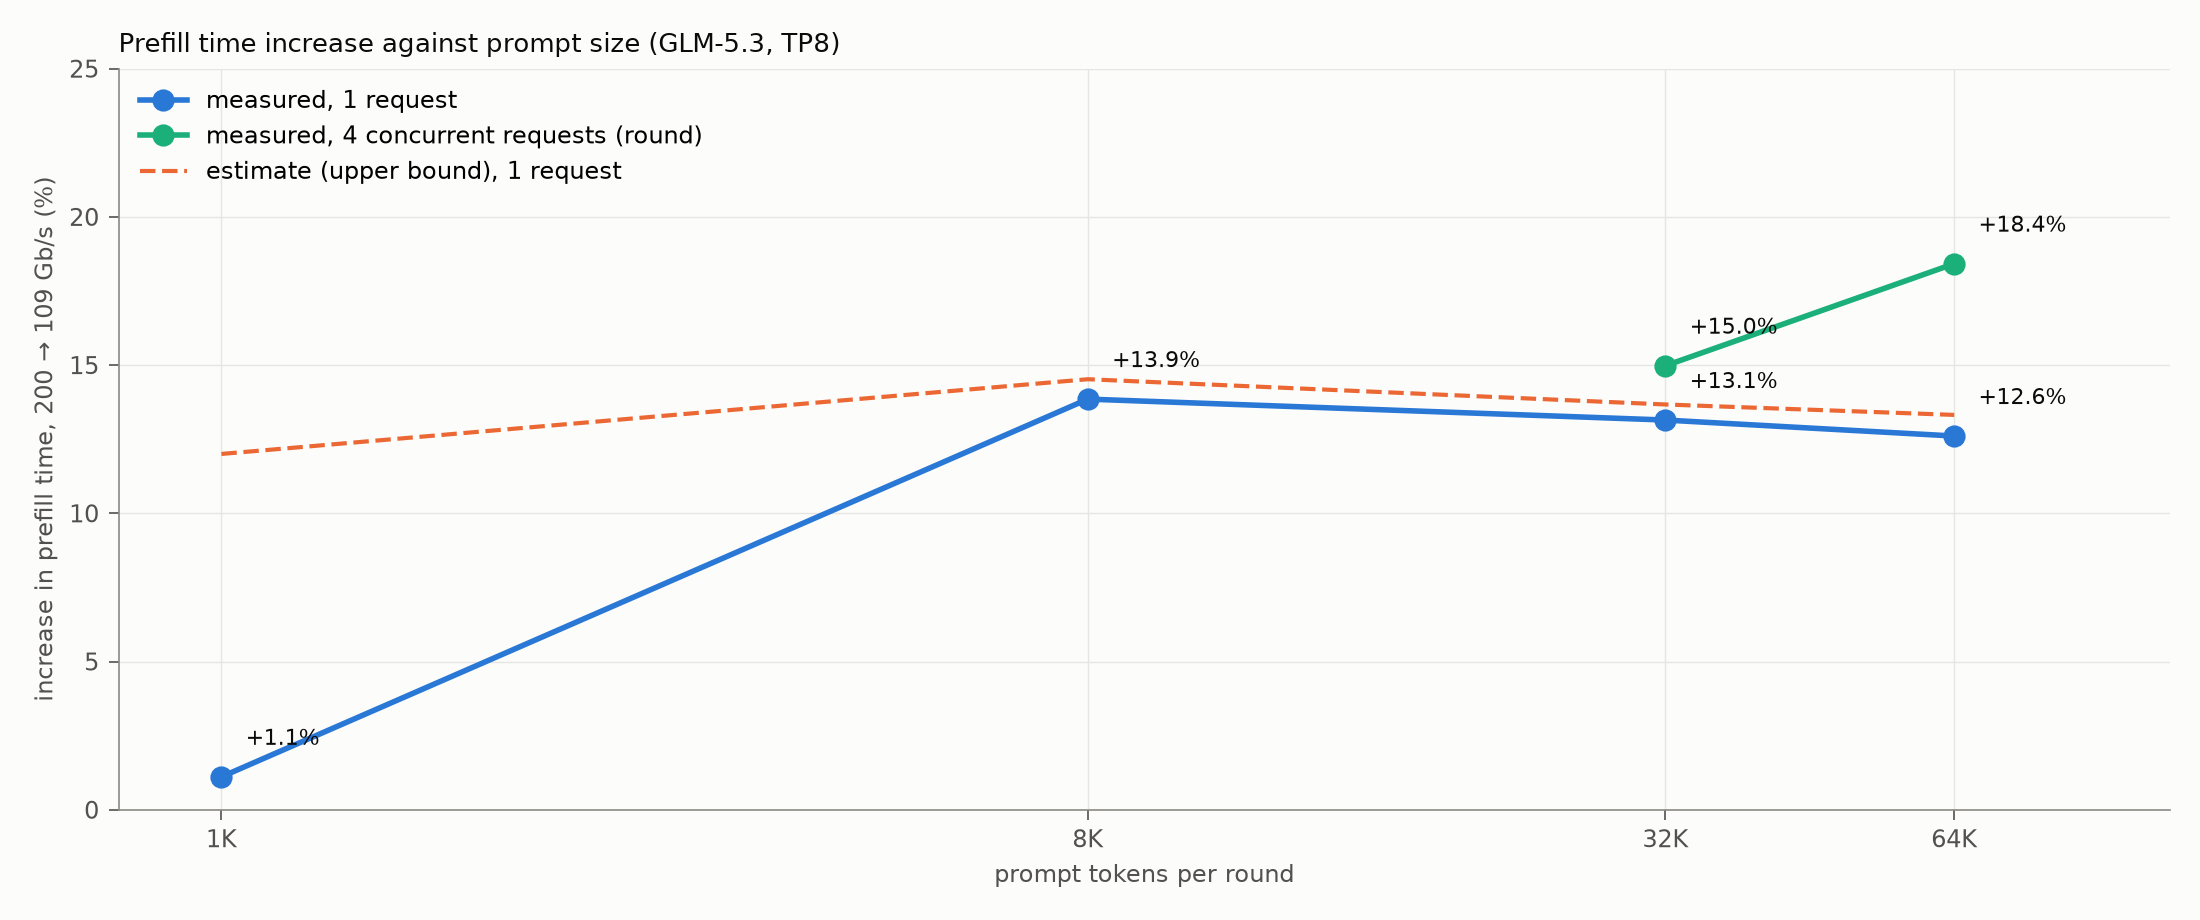
Şekil 12: Prompt boyutuna göre prefill süresindeki artış, ölçülen ve tahmin edilen.
Tek bir prompt için yüzde, 8K’dan 64K token’a kadar neredeyse sabit kalır (%13.9, %13.1 ve %12.6); Bölüm 6.1’in seyrek attention’lı bir model için beklediği de budur. Hafif düşüş, attention işinin baytlardan hâlâ daha hızlı büyüyen kısmından kaynaklanır. Birkaç prompt aynı anda geldiğinde yüzde, aynı toplam prompt boyutu için daha yüksektir: dört 8K’lık prompt için %15.0, dört 16K’lık prompt için %18.4; Bölüm 6.2’nin beklediği gibi.
8.5. Decode hızı
| Test | 200 Gb/s | 100 Gb/s (emüle edilmiş) | Değişim |
|---|---|---|---|
| P1: 1K | 22.4 token/s | 22.5 token/s | +%0.5 |
| P2: 8K | 21.1 token/s | 20.6 token/s | −%2.3 |
| P3: 32K | 18.7 token/s | 19.1 token/s | +%2.0 |
| P4: 4 × 8K | istek başına 10.8 token/s | istek başına 11.2 token/s | +%4.3 |
| P5: 64K | 21.1 token/s | 21.0 token/s | −%0.4 |
| P6: 4 × 16K | istek başına 10.5 token/s | istek başına 10.2 token/s | −%2.1 |
Değişimler iki yöne de işaret ediyor ve turlar arasındaki değişkenliğin içinde kalıyor: Bölüm 4.2’nin beklediği gibi decode hızı bağlantı hızına bağlı değildir.
8.6. Ölçümün tahminden ayrıldığı yerler
1K’lık prompt. Tahmin en fazla +0.12 s’ye izin veriyor, ölçüm ise +0.01 s gösteriyor. 1K’lık bir prompt’un her all-reduce’u Spark başına yalnızca yaklaşık 22 MB gönderir ve patlamalar 200 Gb/s’de bile yalnızca yaklaşık 100 Gb/s’ye ulaşır (Şekil 5); bu, emüle edilmiş bağlantının taşıyabildiğinin altındadır. Bölüm 6.1’in öngördüğü gibi sınır, kısa prompt’larda etkiyi abartır.
Aynı anda gelen dört 16K’lık prompt. Burada ölçülen artış tahmini yaklaşık 1 s aşıyor. Tahmin, baytları göndermeye harcanan süreyi kapsar. Bu testte motor prompt’ları çiftler halinde işledi ve ikinci çift hâlâ prefill’deyken ilk çiftin decode’una başladı (Bölüm 8.2); bu yüzden decode işi, kalan prefill’in ileri yayılımlarını paylaştı. O prefill ne kadar uzun sürerse içine o kadar çok decode işi düşer ve son ilk token’a kadar geçen süre, yalnızca ek aktarım süresinin getireceğinden fazla uzar. Motorun zamanlamasının bu etkisi tahminin dışında kalır ve birkaç uzun prompt aynı anda geldiğinde kaybı artırabilir.
Aynı anda gelen dört 8K’lık prompt. Son ilk token’a kadar geçen süre tahminin içinde kaldı, ancak motorun dört ilk token’ı verme sırası iki bağlantı hızında farklıydı. Bu tür testlerde tek tek isteklerin TTFT’si bu yüzden yalnızca bağlantıya değil, kısmen zamanlamaya da bağlıdır.
9. Emüle Edilmiş Bağlantıdan Gerçek 100G Kabloya
Emüle edilmiş bağlantı en fazla 109 Gb/s taşır; gerçek bir 100 Gb/s bağlantı ise en fazla 100 taşır. Sınırı bu farka uygulamak, gerçek bir kablonun ölçülen sonuçlara ekleyebileceği en büyük değeri verir:
ek prefill süresi ≤ ölçülen prefill baytı × (1/100 − 1/109)
| Test | Emüle edilmiş 100 Gb/s (ölçülen) | Gerçek 100 Gb/s kablo, en fazla |
|---|---|---|
| P1: 1K | +%1.1 | +%3.6 |
| P2: 8K | +%13.9 | +%16.9 |
| P3: 32K | +%13.1 | +%16.0 |
| P4: 4 × 8K, son ilk token | +%15.0 | +%18.3 |
| P5: 64K | +%12.6 | +%15.4 |
| P6: 4 × 16K, son ilk token | +%18.4 | +%21.8 |
Gerçek bir 100 Gb/s kablo bu yüzden ölçülen sonuçlardan en fazla 2.5–3.5 puan daha kötü olur ve decode hızı yine etkilenmez. Saniye cinsinden Bölüm 5.1, 1,000 prompt token’ı başına en fazla 0.135 s verir. Gerçek bir 100 Gb/s bağlantı, paket ek yükü hesaba katıldığında 100 Gb/s’den biraz daha az veri taşır; bu yüzden gerçek değer biraz daha yüksek olabilir.
10. Öngörü: Kayıp TP Boyutuyla Nasıl Değişir
TP8 ve 200 Gb/s’de ölçülen 8K prefill temel alınarak ve hesaplamanın Spark’lara eşit bölündüğü varsayılarak, Bölüm 5’teki sınır gerçek bir 100 Gb/s bağlantı için şunu öngörür:
| TP boyutu | 100 Gb/s’de öngörülen TTFT artışı, 8K prompt |
|---|---|
| TP2 | ≤ %3 |
| TP4 | ≤ %8 |
| TP8 | ≤ %17 (emüle edilmiş bağlantıda ölçülen: %13.9; gerçek kablo: ≤ %16.9) |
| TP16 | ≤ %31 |
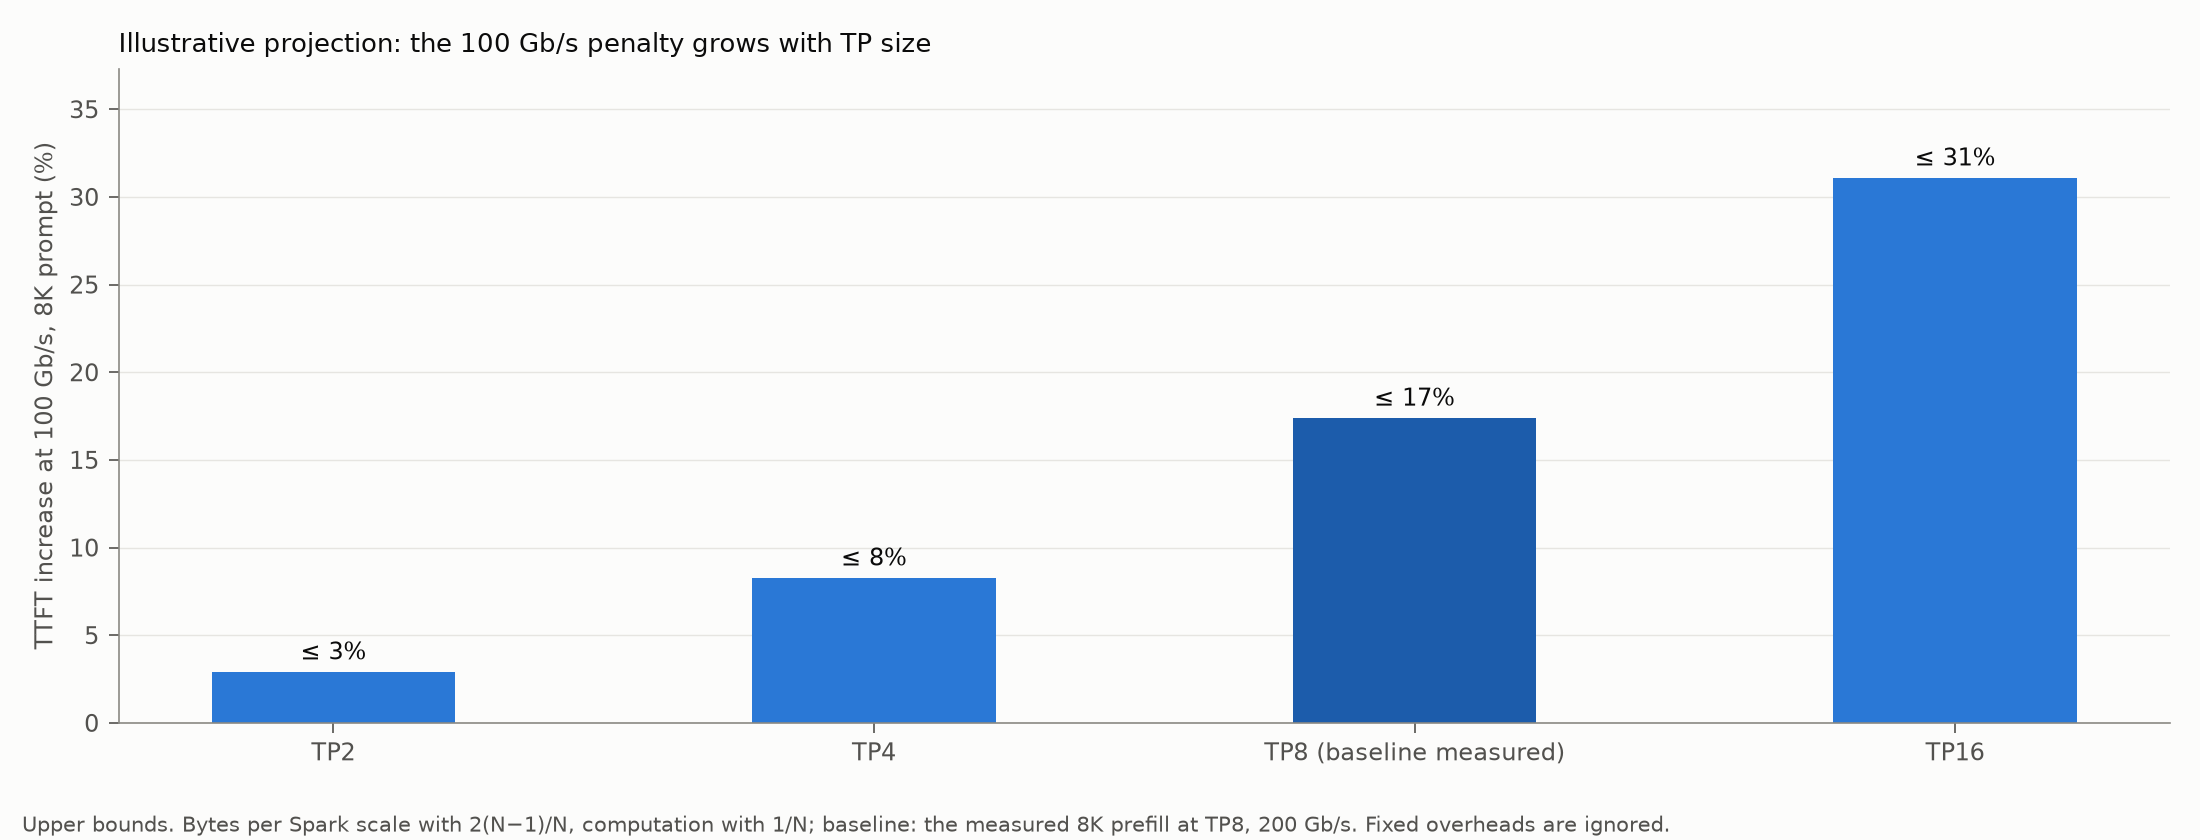
Şekil 13: TP boyutuna göre 100 Gb/s’nin öngörülen TTFT kaybı (açıklayıcı).
Bu bir ölçüm değil, bir öngörüdür: GLM-5.3 2 ya da 4 Spark’a sığmaz ve sabit ek yükler göz ardı edilmiştir. Etkinin yönünü ve kabaca büyüklüğünü gösterir: TP16’da kayıp, TP8’dekinin yaklaşık iki katı olur. 100 Gb/s’de 16 Spark ile iki TP8 cluster’ın her biri bu çalışmada ölçülen kaybı korur; tek bir TP16 cluster ise kaybı kabaca ikiye katlar.
11. 100 Gb/s’de 8 Spark Makul mü?
Evet. 8 Spark’lık bir TP8 cluster’ı 200 Gb/s’den 100 Gb/s bağlantılara geçirildiğinde:
İlk token çok uzun bir prompt’ta en fazla yaklaşık %20, birkaç çok uzun prompt aynı anda geldiğinde en fazla yaklaşık %30 daha geç gelir. Kısa ve orta uzunluktaki prompt’larda değişiklik olmaz. Cevap bir kez başladığında aynı hızda akar.
| İş yükü | Ölçülen (emüle edilmiş 100 Gb/s) | Gerçek 100 Gb/s kablo, en fazla |
|---|---|---|
| Kısa ve orta uzunlukta prompt’lu sohbet (1K token civarı) | ölçülebilir fark yok | yaklaşık +%4 |
| Çok uzun bir prompt: RAG, uzun belgeler (8K–64K token) | TTFT +%12.6–13.9 | TTFT +%17 (1,000 prompt token’ı başına en fazla 0.135 s) |
| Aynı anda gelen birkaç çok uzun prompt | istek başına TTFT +%17.9–22.5 | istek başına TTFT +%27 |
| Her durumda decode hızı | değişmiyor | değişmiyor |
Bunlar ölçülen durumlar için üst sınırlardır; karma bir iş yükünde isteklerin çoğu daha kısadır ya da tek başına gelir ve daha az etkilenir.
100 Gb/s’de bir CRS812, tek bir TP8 cluster’a yetecek kadar, 8 Spark bağlar; bedeli, yukarıda anlatılan uzun prompt’larda ilk token için daha uzun beklemedir; cevabın akış hızı değişmez.
100 Gb/s’de bir CRS804 16 Spark bağlar. İki TP8 cluster olarak çalıştırıldığında her biri bu çalışmada ölçülen Spark başına bağlantıyı görür; bu yüzden yukarıdaki sonuçlar her birine uygulanır, yeter ki switch tüm portlarda aynı anda tam hızda trafik iletebilsin (doğrulanmalıdır). Tek bir TP16 cluster kaybı kabaca ikiye katlar (Bölüm 10) ve 100 Gb/s’de önerilmez.
Sıkı TTFT hedefleri olan uzun prompt’ların iş yüküne hâkim olduğu, çok sayıda kullanıcının aynı anda uzun prompt gönderdiği ya da bir modelin sekizden fazla Spark’a yayılması gereken durumlarda 200 Gb/s daha iyi seçim olmaya devam eder.
12. Sınırlar ve Dikkat Edilmesi Gerekenler
Ölçümler tek bir modeli (GLM-5.3), tek bir çıkarım motoru ve sürümünü (vLLM) ve tek bir TP boyutunu (TP8) kapsar. Başka modeller, motorlar ve ayarlar farklı miktarda veri gönderir ve farklı hızlarda hesap yapar; tahmin yöntemi uygulanabilir, ama sayıların yeniden hesaplanması gerekir. 100 Gb/s durumu 100G kablolarla kurulmadı, tek bir ağ arayüzüyle emüle edildi; Bölüm 9 farkı sınırlar. Bölüm 10’daki TP boyutu öngörüsü bir ölçüm değil, bir hesaptır.
100 Gb/s’yi seçmeden önce, switch’in planlanan yapılandırmada QSFP-DD portlarında 4 × 100G breakout’u desteklediğini, DGX Spark’ın ConnectX-7’sinin seçilen breakout kablosuyla 100 Gb/s’de bağlantı kurduğunu ve 16 Spark için switch’in tüm portlarda aynı anda tam hızda trafik iletebildiğini doğrulayın.
Cluster ağını boyutlandırırken yaygın hatalar
- ✗ Yanlış sayaçları okumak: standart Linux araçları (
ip -s link,nload,sar) RDMA trafiğini görmez; bu yüzden çıkarım sırasında neredeyse boşta bir bağlantı gösterir. - ✗ Bağlantı kullanımını ortalamalardan değerlendirmek: bir saniyelik ya da switch portu ortalamaları, TTFT’yi belirleyen milisaniyelik patlamaları gizler.
- ✗ Yarı bağlantı hızının yarı çıkarım hızı demek olduğunu varsaymak: yalnızca prefill sırasındaki patlamalar yavaşlar; decode yavaşlamaz.
- ✗ 100 Gb/s’de bir modeli gerekenden fazla Spark’a yaymak: kayıp TP boyutuyla büyür.
8 ya da 16 Spark’lık bir cluster ağı planlamak için kontrol listesi
- ☐ Model örneği başına TP boyutu belirlendi mi (TP8 ya da 16 Spark’ta iki TP8 örneği)?
- ☐ Beklenen prompt uzunluğu biliniyor mu (sohbet, RAG, uzun belgeler)?
- ☐ Uzun prompt’lar için bir TTFT hedefi var mı?
- ☐ 100 Gb/s kaybı tahmin edildi mi (prompt token’ı başına bayt × prompt token’ı ÷ 200 Gb/s, Bölüm 5)?
- ☐ Breakout desteği ve ConnectX-7’nin planlanan hızda bağlantı kurması doğrulandı mı?
- ☐ RDMA trafiği, milisaniye çözünürlüğünde RDMA sayaçlarıyla izleniyor mu?
13. Sonuç
DGX Spark sistemleri üzerinde tensör paralel çıkarım ağı çok farklı iki biçimde kullanır. Bir prompt işlenirken her all-reduce Spark başına onlarca megabayt gönderir; bu, 200 Gb/s’lik bir bağlantıyı bir seferde birkaç milisaniye dolduran patlamalar halinde olur. Cevap üretilirken all-reduce’lar birkaç yüz kilobayt ya da daha azdır ve trafik 100 Gb/s’nin çok altında kalır. Bağlantı hızını yarıya indirmek bu yüzden decode hızını değiştirmez ve ilk token için beklemeye öngörülebilir bir miktar ekler.
Bu miktar yalnızca modelin mimarisinden, motorun prefill parçası boyutundan ve bağlantı hızından tahmin edilebilir: GLM-5.3 ile TP8 için 100 Gb/s’de 1,000 prompt token’ı başına en fazla 0.135 s. Emüle edilmiş 100 Gb/s bağlantılı 8 Spark üzerinde ölçüldüğünde, 8K–64K token’lık tekil prompt’lar ilk token’larına %12.6–13.9 daha geç ulaştı, tahmine yakın; başka uzun prompt’larla birlikte gelen istekler %17.9–22.5 daha geç; kısa prompt’lar ve decode hızı etkilenmedi. Gerçek bir 100G kablo buna en fazla 2.5–3.5 puan daha ekler.
100 Gb/s bağlantılı 8 Spark’lık bir TP8 cluster için ilk token’ın çok uzun bir prompt’ta en fazla yaklaşık %20, birkaç çok uzun prompt birlikte geldiğinde en fazla yaklaşık %30 daha geç gelmesi; kısa ve orta uzunluktaki prompt’larda değişiklik olmaması ve cevabın akış hızında değişiklik olmaması beklenmelidir. Kayıp TP boyutuyla büyüdüğü için 100 Gb/s’de 16 Spark en iyi iki TP8 cluster olarak çalıştırılır.
Ek A: RDMA Trafiğini Ölçmek
RDMA işletim sisteminin ağ yığınını atladığı için olağan arayüz istatistikleri onu saymaz. Bu çalışmadaki trafik, iki RDMA cihazının her biri için ConnectX-7’nin RDMA port sayaçlarından (/sys/class/infiniband/ altında port_xmit_data ve port_rcv_data, 4 baytlık birimlerle) okundu ve port için toplandı. Adaptörün kendi bayt sayaçlarıyla yapılan çapraz kontrol %0.2 içinde uyuştu.
Küçük bir örnekleyici sayaçları tek bir Spark’ta her 1 ms’de okudu ve her okumayı, benchmark’ın istekleri için kullandığı saatle aynı saatte, tek tek zaman damgaladı. 1 ms ve daha uzun aralıklardaki hızlar, her örnekleme aralığının baytları kapsadığı ortalama alma aralıklarına yayılarak hesaplandı. Bayt sayıları kesindir, ancak her okumanın zamanı yalnızca yaklaşık ±0.1–0.2 ms hassasiyetle bilinir; bu yüzden tek bir 1 ms değerinin belirsizliği yaklaşık ±%15–25’tir. Şekillerdeki bazı 1 ms değerlerinin bağlantı hızının biraz üzerinde görünmesinin nedeni budur. 5 ms ve daha uzun aralıklardaki ortalamalar birkaç yüzde içinde doğrudur.
Bölüm 8.1’in gösterdiği gibi, ortalama alma aralığının seçimi bir ölçümün raporladığı en yüksek değeri değiştirir: aynı trafik 1 ms aralıklarla 181 Gb/s’de, 5 ms aralıklarla 96 Gb/s’de ve 100 ms aralıklarla 44 Gb/s’de tepe yapar; ortalaması ise hepsinde aynıdır. Bir tepe değeri ancak ortalama alma aralığıyla birlikte anlamlıdır.
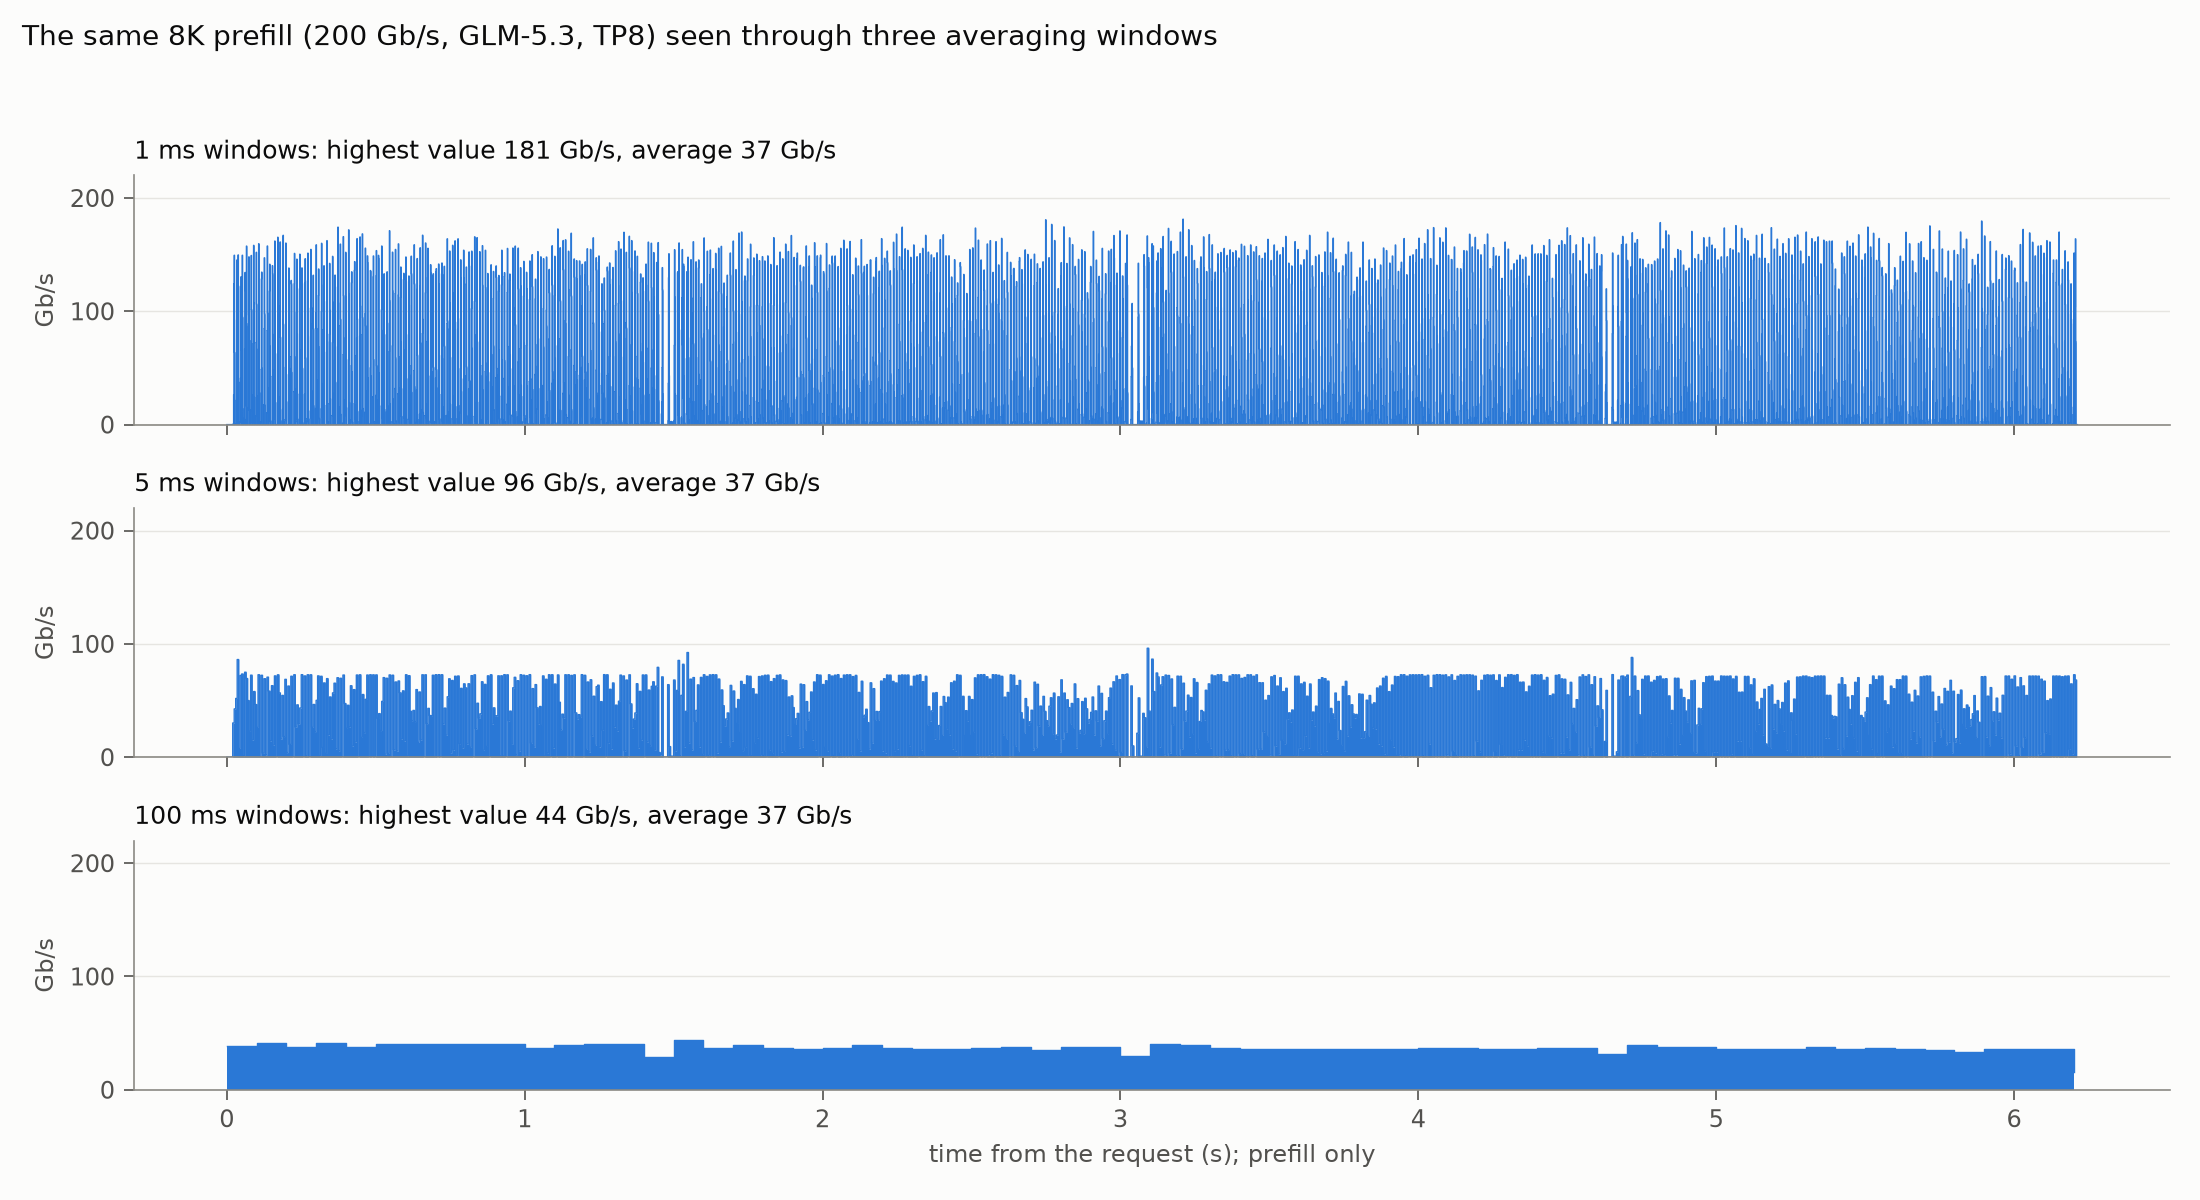
Şekil A1: 1 ms, 5 ms ve 100 ms aralıklarla ortalaması alınmış aynı prefill trafiği.
Ölçümün kendisi ağı etkilemedi: örnekleyici çalışırken ve dururken yapılan bant genişliği (bandwidth) ve gecikme testleri (ib_write_bw, ib_write_lat) aynı bant genişliğini (109.07, 109.08 ve 109.15 Gb/s) ve gecikmede en fazla yaklaşık %1 fark gösterdi. Örnekleyici ve benchmark sürücüsü birlikte Spark’ın 20 CPU çekirdeğinden birinin çok altında kullandı.
Ek B: Tekrarlanabilirlik
| Öğe | Değer |
|---|---|
| Test sürücüsü | test isteklerini motora akış (streaming) istekleri olarak gönderir, her cevabın ilk token’ını ve ardından gelen her token’ı zaman damgalar ve RDMA sayaçlarını aynı saatte yanında kaydeder (Bölüm 7.4–7.6, Ek A) |
| Model | Inferact/GLM-5.3-NVFP4 |
| Motor | vLLM 0.1.dev20133+gb5f995e73, container vllm-node-b12x, NCCL 2.28.3 |
| Servis ayarları | --tensor-parallel-size 8, --max-num-batched-tokens 4096, --long-prefill-token-threshold 2048, --max-num-seqs 8, --max-model-len 262144, --kv-cache-dtype fp8, --gpu-memory-utilization 0.726, --enable-chunked-prefill, --enable-prefix-caching; spekülatif kod çözme: MTP, 4 token, taslak bölünmez |
| NCCL | iki RDMA cihazıyla NCCL_IB_HCA (200 Gb/s); ikinci cihaz dışarıda (100 Gb/s emülasyonu); RoCE v2, GID indeksi 3 |
| Plan | P1–P6 testleri (Bölüm 7.4), 1 ısınma ve 3 ölçüm turu, sabit tohum, 1,024 çıktı token’ı |
Sözlük (Terimler)
- Aktivasyonlar: Her token’ı modelin katmanlarından geçerken temsil eden vektörler.
- All-reduce: Her cihazda parçalar halinde tutulan veriyi toplayan ve her cihaza toplamın tamamını veren kolektif işlem.
- Bant genişliğiyle sınırlı / gecikmeyle sınırlı: Bir aktarımın süresi bağlantının baytları ne kadar hızlı taşıdığıyla belirleniyorsa bant genişliğiyle sınırlıdır (büyük aktarımlar), sabit gecikmelerle belirleniyorsa gecikmeyle sınırlıdır (küçük aktarımlar).
- Breakout kablosu: Hızlı bir switch portunu (örneğin 400 Gb/s) birkaç daha yavaş bağlantıya (örneğin 4 × 100 Gb/s) bölen kablo.
- ConnectX-7: DGX Spark’a yerleşik NVIDIA ağ adaptörü.
- Decode: Cevabı, her seferinde bir ileri yayılımla üreten aşama.
- Decode hızı: Cevabın ne kadar hızlı aktığı: ilk token’dan sonra saniye başına çıktı token’ı.
- Emülasyon: Bir koşulu (burada 100 Gb/s’lik bir bağlantıyı) yazılımda modellemek yerine gerçek donanım üzerinde yeniden üretmek.
- İleri yayılım: Modelin katmanlarının o anda işlenen token’lar üzerinde bir kez çalıştırılması.
- Gizli boyut: Model içinde her token’ı temsil eden vektörün uzunluğu (GLM-5.3 için 6,144).
- MTP (multi-token prediction, çok token’lı tahmin): Modelin birkaç token taslağı çıkardığı ve bunların tek bir ileri yayılımda kontrol edildiği bir spekülatif kod çözme biçimi.
- NCCL: NVIDIA’nın GPU’lar arası iletişim kütüphanesi; çıkarım motoru all-reduce için bunu kullanır.
- Ağ arayüzü: İşletim sisteminin bir ağ adaptörü bağlantısından gördüğü şey; burada her ConnectX-7 portu, her PCIe bağlantısı için bir tane olmak üzere iki arayüz olarak görünür.
- Prefill süresindeki ağ payı: Prefill baytlarını 200 Gb/s’de göndermek için gereken sürenin prefill süresine bölümü.
- Nominal bağlantı hızı: Bir bağlantının protokol ek yükünden önceki anma hızı (burada 200 Gb/s).
- NVFP4: NVIDIA’nın 4 bitlik kayan nokta sayı formatı; her 16 değerlik grup bir ölçekleme faktörünü paylaşır.
- Prefill: İlk çıktı token’ından önce prompt’u işleyen aşama.
- Prefill parçası: Bir prompt’un tek bir ileri yayılımda işlenen kısmı (burada en fazla 4,096 token).
- RDMA: Remote direct memory access (uzak doğrudan bellek erişimi): ağ adaptörü uygulama belleğini doğrudan okur ve yazar; veri işletim sisteminin ağ yığınından geçmez.
- Halka all-reduce: Cihazların verinin segmentlerini bir halka etrafında aktardığı all-reduce; her cihaz toplamda verinin 2 × (N − 1) / N katını gönderir.
- RoCE v2: RDMA over Converged Ethernet, sürüm 2: standart Ethernet üzerinde UDP/IP içinde taşınan RDMA paketleri.
- Tensör paralelliği (TP): Bir modelin her ağırlık matrisini, her adımdan sonra kısmi sonuçlarını birleştiren birkaç cihaza bölmek.
- TTFT (time to first token, ilk token süresi): Bir isteğin gönderilmesinden cevabın ilk token’ının alınmasına kadar geçen süre.
Kaynaklar
Donanım:
- NVIDIA DGX Spark — https://www.nvidia.com/en-us/products/workstations/dgx-spark/
- NVIDIA ConnectX-7 adaptör dokümantasyonu — https://docs.nvidia.com/networking/display/connectx7vpi/introduction
- MikroTik CRS804 DDQ — https://mikrotik.com/product/crs804_ddq
- MikroTik CRS812 DDQ — https://mikrotik.com/product/crs812_ddq
Model ve yazılım:
- GLM-5.3 NVFP4 checkpoint’i — https://huggingface.co/Inferact/GLM-5.3-NVFP4
- vLLM — https://github.com/vllm-project/vllm
- NCCL — https://github.com/NVIDIA/nccl
- perftest (
ib_write_bw,ib_write_lat) — https://github.com/linux-rdma/perftest
İlgili çalışmalar:
- DGX Spark 8-Node AI Cluster Kurulum Rehberi
- Qwen3.6-27B DGX Spark Cluster Scaling
- Yerel LLM Kullanım Rehberi
Notlar
- Tahminler: Bölüm 3–6 yalnızca modelin yapılandırmasını, motorun ayarlarını ve bağlantı hızını kullanır; sınırlar üst sınırlardır. TP boyutu öngörüsü (Bölüm 10) ölçülen TP8 temel değerini kullanır ve açıklayıcıdır.
- Ölçümler: Tüm performans değerleri, Bölüm 7’de anlatıldığı gibi, GLM-5.3 ile TP8’de 8× DGX Spark üzerinde ölçüldü; ağ trafiği tek bir Spark’ın ConnectX-7 RDMA sayaçlarından okundu (Ek A).
- Emülasyon: 100 Gb/s, iletişim her ConnectX-7 portunun iki ağ arayüzünden en fazla 109 Gb/s taşıyan birine sınırlanarak emüle edildi; Bölüm 9 gerçek bir 100G kabloyla farkı sınırlar.
- Güncellik: Motor sürümleri ve ayarları hızla değişir; sonuçlar Ekim 2026 itibarıyla listelenen sürümler için geçerlidir.
DGX Spark cluster ağınızı birlikte planlayalım. Model boyutunu, tensör paralelliğini ve bağlantı hızını hesaba katan bir boyutlandırma için OpenZeka ile iletişime geçin: support@openzeka.com · openzeka.com