Hazırlayan: Openzeka Teknoloji A.Ş. — NVIDIA Türkiye & MEA Resmî Embedded Compute Distribütörü ve NVIDIA Elite Partner
Donanım Mimarisi, Format ve Güvenilirlik Üzerine Teknik Rehber
Hedef kitle: LLM servis eden geliştiriciler, MLOps ekipleri ve uygulayıcılar Yayın: Ekim 2026
İçindekiler
- 1. Kısa Özet
- 2. Quantization Ne Kazandırır?
- 3. Quantization Performansı Neden Artırır?
- 4. GPU Mimarisi ve Quantization Formatı
- 5. Quantization Formatları
- 6. “4-bit = 4-bit” Değildir
- 7. NVFP4 Neden Farklı?
- 8. GPU Mimarisi × Format Eşleşmesi
- 9. Ampere: INT4 ile FP8’i Karıştırmamak
- 10. Ada ve Hopper: FP8’in Güçlü Konumu
- 11. Blackwell: FP8 mi, NVFP4 mü?
- 12. Mixed-Precision Quantization
- 13. Calibration Neden Önemli?
- 14. Güvenilir Quantized Checkpoint Nasıl Seçilir?
- 15. İyi Bir Model Card Neleri Açıklamalı?
- 16. Benchmark Nasıl Okunmalı?
- 17. Vaka Örnekleri
- 18. PTQ mi, QAT mi?
- 19. Quantization Seçim Akışı
- 20. Sık Yapılan Hatalar
- 1. Donanım orijinal model için yeterliyken gereksiz yere 4-bit’e geçmek
- 2. Orijinal model benchmark’ını quantized modele mal etmek
- 3. “4-bit = 4-bit” demek
- 4. Native hardware acceleration ile software support’u karıştırmak
- 5. Sadece tokens/s ölçmek
- 6. KV Cache’i unutmak
- 7. Calibration bilgisini göz ardı etmek
- 8. Sadece genel benchmark’a güvenmek
- 21. Özet Karar Tablosu
- 22. Hızlı Komut Referansı
- 23. Quantization Kalitesini Değerlendirme
- 24. Terimler Sözlüğü
- 25. Sonuç
- 26. Referanslar
1. Kısa Özet
Quantization, LLM ağırlıklarının ve gerektiğinde activation/KV cache verilerinin daha düşük precision (sayısal gösterim hassasiyeti, yani bit genişliği) ile temsil edilmesini sağlayarak bellek tüketimini, bellek bant genişliği ihtiyacını ve uygun donanımda hesaplama maliyetini azaltır.
Eskiden çoğunlukla “model belleğe sığmadığında başvurulan bir taviz” olarak görülürken, günümüzde FP8 ve FP4 gibi formatlar modern GPU’larda donanımsal olarak hızlandırılmaktadır. Ayrıca birçok model geliştiricisi doğrudan resmî, önceden quantize edilmiş checkpoint’ler yayınlamaktadır.
Ancak quantization tek başına “daha düşük bit = daha hızlı” anlamına gelmez.
Doğru seçim şu dört faktörün kesişiminde yapılmalıdır:
İş yükü × Quantization formatı × GPU mimarisi × Checkpoint güvenilirliği
Üç temel kural
1. Model sahibinin resmî quantize checkpoint’i varsa önce onu değerlendir.
Bu, otomatik olarak en kaliteli checkpoint olduğu anlamına gelmez; ancak quantization yöntemi, formatı ve hedef runtime’ı açısından genellikle en güvenilir başlangıç noktasıdır.
2. Format ile GPU mimarisi eşleşmelidir.
Örneğin:
- Ampere → INT4/INT8 tabanlı yöntemler
- Ada → FP8
- Hopper → FP8
- Blackwell → FP8 / NVFP4 / MXFP4
Native Tensor Core desteği olmayan bir formatın yalnızca “çalışıyor olması”, o formatın hızlı çalıştığı anlamına gelmez.
3. Orijinal modelin benchmark’ı quantize checkpoint’in benchmark’ı değildir.
BF16 modelin skoru, aynı modelin FP8 veya FP4 checkpoint’i için otomatik olarak geçerli kabul edilmemelidir.
Quantized checkpoint için:
- kullanılan quantization yöntemi,
- calibration süreci,
- benchmark sonuçları,
- runtime,
- GPU,
- generation ayarları
ayrıca kontrol edilmelidir.
2. Quantization Ne Kazandırır?
Quantization’ın üç temel etkisi vardır:
- Model ağırlıklarının küçülmesi
- Bellek bant genişliği ihtiyacının azalması
- Uygun donanımda düşük-precision Tensor Core hesaplamasının hızlandırılması
Bunların etkisi workload’a göre değişir.
2.1 Bellek tüketimi
İdeal durumda ağırlık belleği yaklaşık olarak:
Parametre sayısı × bytes/parameter
şeklinde hesaplanabilir.
Örneğin:
| Precision (bit genişliği) | Bit | 7B | 70B | 405B |
|---|---|---|---|---|
| BF16 / FP16 | 16 | ~14 GB | ~140 GB | ~810 GB |
| FP8 / INT8 | 8 | ~7 GB | ~70 GB | ~405 GB |
| 4-bit | 4 | ~3.5 GB | ~35 GB | ~202 GB |
Bunlar yalnızca ideal ağırlık boyutlarıdır.
Gerçek GPU belleği:
Ağırlıklar + KV Cache + activations + runtime overhead + quantization metadata
toplamından oluşur.
Özellikle MoE modellerinde toplam parametre sayısı ile aktif parametre sayısının farklı olduğunu da unutmamak gerekir.
2.2 KV Cache quantization ayrı bir karardır
Ağırlık quantization (weight quantization) ile KV cache quantization aynı şey değildir.
Örneğin:
BF16 weights + BF16 KV
BF16 weights + FP8 KV
FP8 weights + FP8 KV
NVFP4 weights + FP8 KV
NVFP4 weights + NVFP4 KV
tamamen farklı deployment profilleridir.
Uzun context ve yüksek concurrency’de KV Cache ciddi miktarda GPU belleği tüketebilir. Bu nedenle:
Weight quantization
        +
KV Cache quantization
birlikte ele alınmalıdır.
FP8 KV Cache, uygun runtime ve model mimarisinde KV belleğini (KV cache belleği) yaklaşık yarıya indirebilir; ancak bunun attention kalitesine etkisi model ve implementation’a göre doğrulanmalıdır.
“Uzun context’te önemli bir bellek optimizasyonudur; model başarım etkisi kontrol edilmelidir.”
3. Quantization Performansı Neden Artırır?
Quantization’ın temel amacı model ağırlıklarını daha düşük precision ile temsil ederek bellek tüketimini ve veri hareketini azaltmak, uygun donanım ve kernel desteği olduğunda ise hesaplama throughput’unu (verim) artırmaktır.
Bir LLM’in inference (çıkarım) performansı kabaca iki temel kaynak tarafından sınırlandırılabilir:
- Memory bandwidth (bellek bant genişliği): GPU’nun model ağırlıklarını ve diğer verileri ne kadar hızlı taşıyabildiği
- Compute throughput: GPU’nun Tensor Core gibi hızlandırıcı birimleriyle ne kadar hızlı matris işlemi gerçekleştirebildiği
Quantization her iki noktada da avantaj sağlayabilir.
3.1 Memory Bandwidth Avantajı
Model ağırlıkları daha düşük precision ile tutulduğunda model boyutu küçülür.
Örneğin yaklaşık 70B parametreli bir model için:
| Precision (bit genişliği) | Yaklaşık ağırlık boyutu |
|---|---|
| FP16 / BF16 | ~140 GB |
| FP8 / INT8 | ~70 GB |
| 4-bit | ~35 GB |
Bu küçülme yalnızca VRAM kapasitesine fayda sağlamaz. Inference sırasında GPU’nun model ağırlıklarını bellekte taşıması gerektiğinden, daha küçük ağırlıklar daha az memory traffic anlamına gelir.
Özellikle düşük concurrency (eşzamanlılık) ve decode ağırlıklı workload’larda bu önemli olabilir. Çünkü tek bir token üretirken modelin ağırlıkları üzerinde yapılan hesaplama miktarına kıyasla ağırlıkların bellekte okunması önemli bir maliyet oluşturabilir.
Basitleştirilmiş olarak:
Daha düşük bit → daha küçük model → daha az veri transferi → memory-bound workload’larda daha yüksek throughput potansiyeli
Ancak gerçek throughput; kernel yapısı, batch size, KV cache, GPU mimarisi ve runtime’a bağlıdır. Bu nedenle teorik memory-bandwidth hesabı gerçek inference throughput’u olarak değerlendirilmemelidir.
3.2 Compute Throughput Avantajı
Modern GPU’larda düşük precision formatların avantajı yalnızca daha az veri taşımak değildir.
GPU’nun Tensor Core’ları belirli precision formatlarında yüksek hızlı matris işlemleri gerçekleştirebilir. Eğer kullanılan quantization formatı GPU tarafından donanım seviyesinde hızlandırılıyorsa, daha düşük precision aynı zamanda daha yüksek hesaplama throughput’u sağlayabilir.
Örneğin:
- FP16/BF16 → yüksek precision Tensor Core işlemleri
- FP8 → daha düşük precision ve yüksek Tensor Core throughput
- FP4/NVFP4 → Blackwell gibi mimarilerde çok yüksek düşük-precision Tensor Core throughput
Bu nedenle workload compute-bound olduğunda bile FP8 veya FP4 önemli avantaj sağlayabilir.
Özetle:
Quantization yalnızca modeli küçültmez; uygun donanım desteği varsa GPU’nun daha yüksek düşük-precision compute kapasitesinden de yararlanır.
3.3 Concurrency ve Batch Size Etkisi
Concurrency ve batch size arttıkça aynı model üzerinde daha fazla token paralel olarak işlenir. Böylece GPU’nun Tensor Core’ları daha iyi beslenebilir ve compute throughput’un toplam performanstaki etkisi artabilir.
Bu nedenle quantization avantajının kaynağı workload’a göre değişebilir:
| Workload | Quantization’ın başlıca avantajı |
|---|---|
| Tek kullanıcı / düşük concurrency | Memory traffic azaltma |
| Orta-yüksek concurrency | Memory + compute avantajı |
| Büyük batch / yüksek throughput | Tensor Core compute throughput daha önemli |
| Compute-bound workload | Düşük precision Tensor Core throughput |
| Memory-bound workload | Daha az veri taşıma |
Quantization, uygun donanım ve yazılım desteğiyle hem memory bandwidth ihtiyacını azaltabilir hem de GPU’nun düşük-precision compute kapasitesinden yararlanarak inference throughput’unu artırabilir.
4. GPU Mimarisi ve Quantization Formatı
Quantization formatı tek başına değerlendirilmemelidir. Aynı precision formatının farklı GPU mimarilerindeki performansı önemli ölçüde değişebilir.
Bunun temel nedeni, GPU’ların düşük precision formatlarını farklı seviyelerde desteklemesidir.
4.1 Donanım Desteği Neden Önemli?
Bir formatın model ağırlıklarını daha küçük hâle getirmesi tek başına yüksek performans garantisi değildir.
İki farklı durum düşünelim:
Durum A — Donanım tarafından doğrudan hızlandırılıyor
Quantized weights
       ↓
Native GPU Tensor Core
       ↓
High throughput
Durum B — Ek dönüşüm / özel kernel gerekiyor
Quantized weights
       ↓
Dequantization / conversion
       ↓
FP16/BF16 compute
       ↓
Extra cost
İkinci durumda model daha az VRAM kullanabilir ancak beklenen compute avantajının tamamı elde edilemeyebilir.
Bu nedenle quantization seçiminde yalnızca:
“Kaç bit?”
sorusu değil,
“Bu format benim GPU’mda nasıl hesaplanıyor?”
sorusu da sorulmalıdır.
4.2 GPU Nesline Göre Genel Yaklaşım
| GPU mimarisi | Öne çıkan precision desteği | Genel yaklaşım |
|---|---|---|
| Ampere | FP16/BF16, INT8/INT4 | INT4/INT8 quantization ve optimize kernel’ler güçlü seçenekler |
| Ada Lovelace | FP16/BF16, FP8 | FP8 ve düşük-bit quantization değerlendirilebilir |
| Hopper | FP16/BF16, FP8 | FP8 güçlü bir native acceleration seçeneğidir |
| Blackwell | FP16/BF16, FP8, FP4/NVFP4 | FP8 ve özellikle NVFP4 önemli seçeneklerdir |
Buradaki amaç “eski GPU’da yeni format çalışmaz” demek değildir. Yazılım/runtime desteği farklı formatların kullanılmasına izin verebilir. Ancak native Tensor Core desteği, performans açısından belirleyici bir avantaj sağlayabilir.
4.3 FP8: Bellek ve Compute Arasında Dengeli Seçenek
FP8, özellikle Hopper ve Blackwell gibi mimarilerde iki önemli avantajı bir araya getirir:
- FP16/BF16’ya göre daha düşük model belleği
- Donanım destekli yüksek Tensor Core throughput
Bu nedenle FP8 yalnızca modelin VRAM’e sığdırılması için kullanılan bir format değildir.
Özellikle yüksek concurrency ve throughput odaklı inference sistemlerinde:
Daha düşük memory footprint + daha yüksek düşük-precision compute throughput
birlikte değerlendirilebilir.
FP8’in önemli avantajlarından biri de 4-bit formatlara göre daha yüksek numeric precision sunmasıdır. Bu nedenle kalite korunumu kritik olduğunda ve model FP8 ile iyi uyum gösterdiğinde güçlü bir tercih olabilir.
4.4 FP4 / NVFP4: Blackwell’de Donanım Avantajı
Blackwell mimarisi ile birlikte FP4 sınıfı formatlar daha önemli hâle gelmiştir.
Özellikle NVFP4, yalnızca “4-bit model” olarak değerlendirilmemelidir. Formatın amacı düşük bit genişliğinin sağladığı bellek avantajını, Blackwell’in düşük-precision Tensor Core desteğiyle birleştirmektir.
Bu nedenle NVFP4 iki yönden avantaj sağlayabilir:
Memory tarafı
FP16 → FP8 → FP4
 ↓       ↓      ↓
Less model memory
Less data movement
Compute tarafı
FP16/BF16
    ↓
FP8
    ↓
FP4 / NVFP4
    ↓
Blackwell low-precision Tensor Core throughput
Dolayısıyla Blackwell üzerinde NVFP4 değerlendirilirken yalnızca:
“Model 4-bit olduğu için daha az VRAM kullanıyor.”
denmemelidir.
Asıl önemli nokta:
NVFP4, düşük bellek tüketimini Blackwell’in native düşük-precision compute kapasitesiyle birleştirerek hem memory-bound hem de compute-bound workload’larda avantaj sağlayabilir.
4.5 Quantization Seçiminde Temel Kural
Bir quantization formatını seçerken dört faktör birlikte değerlendirilmelidir:
1. Model kalitesi
Quantization sonrasında modelin accuracy, perplexity ve görev bazlı performansı ne kadar korunuyor?
2. Memory footprint
Model ve KV cache GPU belleğine ne kadar yük getiriyor?
3. Hardware acceleration
GPU bu precision formatını Tensor Core veya başka bir özel hızlandırıcıyla native olarak destekliyor mu?
4. Runtime / kernel desteği
vLLM, SGLang, TensorRT-LLM, llama.cpp veya kullanılan diğer inference stack bu formatı ne kadar verimli çalıştırıyor?
Bu nedenle en düşük bit sayısına sahip format otomatik olarak en hızlı format değildir.
Doğru seçim:
Model kalitesi + memory footprint + native hardware acceleration + runtime/kernel desteğinin birlikte değerlendirilmesiyle yapılır.
5. Quantization Formatları
| Format / yöntem | Tipik kullanım | Ana avantaj |
|---|---|---|
| GGUF | llama.cpp / CPU+GPU | Esneklik, geniş donanım desteği |
| GPTQ | NVIDIA inference | Yaygın weight-only quantization |
| AWQ | NVIDIA inference | Activation-aware weight quantization |
| EXL2 | NVIDIA / ExLlama | Değişken bpw ile kalite-hız dengesi |
| INT8 / SmoothQuant | Inference | Düşük precision’a geçişte güçlü seçenek |
| NF4 / bitsandbytes | QLoRA / fine-tuning | Training/fine-tuning ekosistemi |
| FP8 | Ada / Hopper / Blackwell | Native low-precision acceleration |
| NVFP4 | Blackwell | Çok düşük bellek + native FP4 acceleration |
| MXFP4 | Blackwell ve destekleyen platformlar | Açık MX standardı ve taşınabilirlik hedefi |
6. “4-bit = 4-bit” Değildir
Aynı nominal bit genişliğine sahip iki quantization yöntemi aynı kaliteyi veya performansı vermeyebilir.
Örneğin:
INT4
AWQ
GPTQ
NF4
MXFP4
NVFP4
aynı “4-bit” sınıfında olsa da:
- sayı gösterimi,
- scaling,
- block size,
- calibration,
- weight-only / weight+activation yaklaşımı,
- kernel,
- hardware acceleration
farklı olabilir.
Bu nedenle:
“4-bit model”
tek başına yeterli bir teknik tanım değildir.
Daha doğru tanım:
“NVFP4, 16-elemanlık micro-block FP8 scaling kullanan Blackwell-optimized 4-bit floating-point format”
gibi formatın ayrıntılarını da içermelidir.
7. NVFP4 Neden Farklı?
NVIDIA NVFP4, Blackwell için tasarlanmış 4-bit floating-point formatıdır.
Temel yaklaşım:
FP4 values
    +
FP8 micro-scale
    +
FP32 tensor-level scale
şeklindedir.
NVFP4’te FP4 değerleri 16 elemanlık micro-block’lar üzerinden FP8 scale ile ölçeklenir. Ayrıca tensor seviyesinde FP32 scale kullanılır.
Bu yaklaşım, basit bir FP4 gösterimine göre quantization error’unu azaltmayı amaçlar.
NVIDIA’nın yayımladığı verilere göre NVFP4, FP8’e göre yaklaşık 1.8× ve FP16’ya göre yaklaşık 3.5× daha küçük model footprint’i sağlayabilir; gerçek checkpoint boyutu ise metadata ve kullanılan mixed-precision recipe’ye bağlıdır.
Dolayısıyla:
NVFP4 = sadece “4 bit” değildir.
Asıl fark:
4-bit representation + fine-grained scaling + hardware acceleration
kombinasyonudur.
8. GPU Mimarisi × Format Eşleşmesi
En önemli karar noktalarından biri budur.
| GPU mimarisi | Öncelikli seçenekler | Not |
|---|---|---|
| Pascal | GGUF Q4/Q5/Q6 | Modern FP8/FP4 Tensor Core özellikleri yok |
| Turing | INT8 / INT4 tabanlı yöntemler | FP8 native Tensor Core desteği yok |
| Ampere | INT4 / INT8, AWQ/GPTQ | A100 native INT4/INT8 Tensor Core destekler |
| Ada | FP8, INT4 | FP8 native Tensor Core desteği vardır |
| Hopper | FP8 | FP8 + Transformer Engine güçlü tercih |
| Blackwell | NVFP4 / FP8 / MXFP4 | FP4 ve FP8 native acceleration |
Buradaki “öncelikli” ifadesi, formatın her modelde otomatik olarak en iyi olduğu anlamına gelmez.
Model, runtime ve workload ayrıca değerlendirilmelidir.
9. Ampere: INT4 ile FP8’i Karıştırmamak
Ampere özellikle şu açıdan önemlidir:
A100 / RTX 30
        ↓
Native INT4 / INT8 Tensor Core
        ↓
AWQ / GPTQ / Marlin-style INT4 deployments
A100’de INT4 Tensor Core desteği bulunur.
Buna karşılık FP8, Hopper ile belirgin şekilde öne çıkan ve Ada’da da desteklenen bir precision’dır.
Bu nedenle Ampere üzerinde:
“FP8 dosyası var, o hâlde daha hızlıdır.”
şeklinde bir varsayım yapılmamalıdır.
Runtime FP8 checkpoint’i farklı bir biçimde çalıştırabilir; ancak native hardware acceleration ile yazılım seviyesinde destek aynı şey değildir.
Ampere için 4-bit deployment’ta:
AWQ/GPTQ + uygun optimized kernel
çoğu durumda daha mantıklı başlangıç noktasıdır.
10. Ada ve Hopper: FP8’in Güçlü Konumu
Ada Lovelace, FP8 Tensor Core acceleration sunar.
Hopper ise FP8’i Transformer Engine ile daha ileri taşır.
Bu nedenle:
Ada
 → FP8 is a serious option

Hopper
 → FP8 is a strong default for production inference
olabilir.
Ancak:
“FP8 her zaman FP16’dan 2× hızlıdır.”
denmemelidir.
2× gibi rakamlar belirli kernel/throughput koşullarındaki teorik veya peak avantajları ifade edebilir. Gerçek LLM throughput’u model mimarisi, batch, sequence length ve runtime’a göre değişir.
11. Blackwell: FP8 mi, NVFP4 mü?
Blackwell’de artık temel soru yalnızca:
“Modeli 4-bit’e indirebilir miyim?”
değildir.
Daha doğru soru:
“Bu model için kalite, bellek ve throughput açısından FP8 mi yoksa FP4 mü daha uygun?”
şeklindedir.
FP8
Avantajları:
- daha yüksek numerical precision
- genellikle daha düşük quantization error
- native Blackwell acceleration
- kalite kritik workload’larda güçlü seçenek
NVFP4
Avantajları:
- daha düşük weight footprint
- daha düşük memory traffic
- native Blackwell FP4 acceleration
- büyük modelleri daha küçük GPU kümelerine sığdırma avantajı
Pratik yaklaşım
FP8
 ↓
Benchmark
 ↓
NVFP4
 ↓
Benchmark
 ↓
Compare quality + latency + throughput + VRAM
Sonuç:
Quality difference acceptable
        → NVFP4

Quality critical
        → FP8
olabilir.
Bu karar model bazında verilmelidir.
12. Mixed-Precision Quantization
Modern quantized checkpoint’ler çoğu zaman bütün ağırlıkları aynı formatta saklamaz.
Örneğin:
MLP                 → NVFP4
Attention           → FP8
lm_head             → NVFP4 / higher precision
critical layers     → higher precision
gibi bir recipe kullanılabilir.
Bu yaklaşımın temel mantığı:
Her katmanın quantization error’a duyarlılığı aynı değildir.
Dolayısıyla iyi bir quantization pipeline:
Model
  ↓
Calibration
  ↓
Layer sensitivity analysis
  ↓
Mixed-precision recipe
  ↓
Quantization
  ↓
Benchmark
şeklinde ilerleyebilir.
Bu nedenle yalnızca:
“Model 4-bit.”
demek yeterli değildir.
Asıl önemli bilgiler:
- hangi katmanlar quantize edildi?
- hangi precision kullanıldı?
- block size nedir?
- scaling nasıl yapıldı?
- calibration dataseti nedir?
- calibration algoritması nedir?
sorularıdır.
13. Calibration Neden Önemli?
PTQ (Post-Training Quantization, eğitim sonrası quantization) sırasında calibration (kalibrasyon) dataset’i modelin gerçek kullanım dağılımını temsil etmelidir.
Örneğin:
General chat model
    → general text calibration

Coding model
    → coding-weighted calibration

Agent model
    → tool-use / instruction / reasoning calibration
gibi seçimler daha anlamlı olabilir.
Calibration süreci quantization error’un nerede ve nasıl oluşacağını etkileyebilir.
Bu nedenle:
Aynı model + aynı 4-bit format ≠ aynı kalite
olabilir.
14. Güvenilir Quantized Checkpoint Nasıl Seçilir?
Quantized model seçerken kaynak güvenilirliği kritik önemdedir.
Tercih sırası
1. Model sahibinin resmî checkpoint’i
En iyi başlangıç noktasıdır.
2. Donanım / inference üreticisinin yayınladığı checkpoint
Örneğin NVIDIA Model Optimizer tabanlı, benchmark ve calibration ayrıntıları açıkça verilen checkpoint’ler.
3. Framework / inference topluluğu tarafından hazırlanmış quant’lar
İyi sonuç verebilir; ancak metadata ve benchmark kalitesi ayrıca kontrol edilmelidir.
4. Topluluk Tarafından Üretilmiş Quantization
Topluluk tarafından hazırlanmış quantization dosyaları production ortamında kaynağı ve üretim süreci doğrulanmadan kullanılmamalıdır.
Buradaki risk yalnızca quantization kalitesinin düşük olması değildir. Quantized model dosyası:
- Kim tarafından üretildiği,
- Hangi temel modelden türetildiği,
- Hangi quantization yöntemi ve araçla oluşturulduğu,
- Hangi calibration verisinin kullanıldığı,
- Model dosyasının bütünlüğünün korunup korunmadığı,
- Kullanılan runtime ve kernel’lerle uyumlu olup olmadığı
doğrulanmadan güvenilir kabul edilmemelidir.
Özellikle production sistemlerinde kaynağı belirsiz model ve quantization artefact’ları bir tedarik zinciri riski oluşturabilir. Model ağırlıkları ve ilgili dosyalar çalıştırılan inference pipeline’ın temel girdileri olduğundan, yalnızca benchmark sonucuna bakarak güvenilirlik kararı verilmemelidir.
Bilinen yayımcılar — başlangıç listesi
Aşağıdaki hesaplar, üretim süreci ve model card şeffaflığıyla öne çıkan başlangıç noktalarıdır. Yayımcı adı kalite garantisi değil, aramaya nereden başlanacağının göstergesidir:
| Yayımcı | Tip | Tipik formatlar | Link(ler) |
|---|---|---|---|
| NVIDIA (Model Optimizer) | Donanım / production üreticisi | NVFP4, FP8 (mixed recipe) | HF nvidia · TensorRT-Model-Optimizer |
| RadixArk | SGLang ekosistemi | NVFP4, blockwise FP8, MLX 4-bit, DSpark draft | HF RadixArk · cookbook.sglang.ai |
| Inferact | vLLM ekosistemi | NVFP4, MXFP4, W4A4, EAGLE3 / DSpark draft | HF Inferact · inferact.ai |
| Red Hat AI | Inference sağlayıcı | FP8, INT4 (AWQ/GPTQ) | HF RedHatAI |
| Intel | Donanım / runtime üreticisi | INT8 / INT4 | HF OpenVINO · HF Intel · neural-compressor · openvino |
| ggml-org | Format ekosistemi (llama.cpp) | GGUF | HF ggml-org |
| ISTA-DASLab | Üniversite araştırma lab’ı — GPTQ, SparseGPT, AQLM, QuIP# kaynağı | GPTQ / MatGPTQ, NVFP4 (MoESQ), GGUF (GSQ-RCO), 2-bit (AQLM / QuIP#) | HF ISTA-DASLab · github.com/IST-DASLab |
LM Studio (lmstudio-community) |
Yerel inference runtime’ının resmî model havuzu | GGUF, MLX (4/6/8-bit) | HF lmstudio-community · lmstudio.ai |
| bartowski | Bilinen topluluk yayımcısı | GGUF, EXL2 | HF bartowski |
| unsloth | Training + quant ekosistemi | 4-bit dinamik quant, GGUF | HF unsloth |
Üç kural:
- Sıra değişmez: model sahibinin resmî quant’u → donanım / inference üreticisi → bilinen yayımcı → kendi quant’un (yukarıdaki tercih sırasıyla aynı).
- Checklist sabittir: yayımcı ne kadar bilinir olursa olsun §15 model card listesi doğrulanmadan production’a girmez.
- Liste güncelliği: bu bir anlık başlangıç listesidir; yayımcıların o anki aktifliğini ve kart şeffaflığını her seferinde teyit edin.
Not: Aynı model farklı yayımcılar tarafından yayınlanabilir (ör.
Qwen3.8-27B-NVFP4hem NVIDIA hem RadixArk hem Inferact’ta vardır). Bu durumda yayımcılar arası kıyaslama §23’teki kalite çerçevesiyle yapılmalıdır. RadixArk ve Inferact yalnızca quant değil, speculative decoding draft’ları (DSpark / EAGLE3) da yayınlamaktadır.
15. İyi Bir Model Card Neleri Açıklamalı?
İyi bir quantized checkpoint aşağıdaki bilgileri mümkün olduğunca vermelidir. Ancak bu ayrıntıların hepsi aynı ağırlıkta değildir; kontrole şu üç kademeden başlanmalıdır.
Kritik — doğrulanması gereken temel bilgiler
Not: İki quant’ı ayıran şey nominal bit sayısı değil; yöntem + scaling + calibration + recipe’dir (§6, §13). Bu farkın ölçülmüş özeti “orijinal model ile benchmark karşılaştırması”dır — listedeki en değerli kalemdir ve koşullarıyla birlikte (§16) verilmedikçe anlam ifade etmez.
- Base model
- Üretici / yayımcı kimliği
- Quantization yöntemi (weight/activation precision belirtilmiş şekilde)
- Orijinal model ile benchmark karşılaştırması (koşullarıyla birlikte: iki quant arasındaki kalite farkının tek ölçülebilir kanıtı — §16)
Karar verdirici — şüphede kalan noktayı bunlar çözer
Quantization teknik detayları:
- Calibration dataset + algoritma + örnek sayısı (QAT modellerinde yerine eğitim / post-training recipe’si ve quantization simülasyonu — bkz. §17.4)
- Weight precision
- Activation precision
- KV Cache precision (yalnızca benchmark veya önerilen deployment belirli bir KV precision ile koşulduysa şarttır — başlı başına checkpoint özelliği değil, deployment kararıdır: §2.2)
- Mixed-precision recipe
- Block / group size
Benchmark koşulları:
- Evaluation dataset’leri
- Generation ayarları
- Context length
- Test edilen GPU + runtime
Uyumluluk / ölçek:
- Desteklenen GPU mimarileri
- Tensor parallelism
Tamamlayıcı — teknik kaliteyi belirlemez ama eksikleri pratik iş çıkarır
- Quantization library + version
- Dosya bütünlüğü (commit hash / checksum) + yayın tarihi
- Lisans
Bu bilgiler ne kadar eksikse quantized checkpoint’in bağımsız olarak değerlendirilmesi o kadar zorlaşır.
16. Benchmark Nasıl Okunmalı?
Bir quantized modelin benchmark’ını değerlendirirken sadece skorun kendisine bakılmamalıdır.
Örneğin:
BF16     → 88.92
NVFP4    → 88.01
tek başına çok anlamlı değildir.
Şunların da aynı olması gerekir:
- benchmark version
- prompt format
- system prompt
- temperature
- top_p
- max_new_tokens
- context length
- reasoning mode
- tool configuration
Aksi hâlde iki benchmark doğrudan karşılaştırılamaz.
En güvenilir yaklaşım:
BF16 baseline
      ↓
same benchmark
      ↓
same generation settings
      ↓
same runtime
      ↓
quantized model
      ↓
same benchmark
şeklindedir.
17. Vaka Örnekleri
Vakalar, quantize formun nerede doğduğuna göre dört temel senaryoyu temsil eder:
- Çift yayın — orijinal BF16; üretici kendi resmî FP8’ini de yayınlar.
- Doğrudan low-bit yayın — orijinal model zaten quantized olarak çıkar.
- Üçüncü parti quant — donanım / inference üreticisi, BF16 yayınlanan modeli quantize eder.
- QAT ile 4-bit — quantization eğitim aşamasına girer.
Bu senaryolar §14’teki tercih sırasının karşılıklarıdır: 1 ve 2 → model sahibinin resmî checkpoint’i, 3 → donanım / inference üreticisinin checkpoint’i, 4 → model sahibi (QAT’lı üretim).
17.1 Senaryo 1 — Orijinal BF16 + resmî FP8: Qwen3.8-27B
Qwen/Qwen3.8-27B, 27B parametreli bir modeldir.
Bunun yanında Qwen tarafından:
Qwen/Qwen3.8-27B-FP8
checkpoint’i de yayınlanmıştır.
FP8 checkpoint:
- fine-grained FP8
- block size 128
- BF16 + FP8 tensor yapısı
kullanır.
Qwen model kartı performans metriklerinin orijinal modele yakın olduğunu belirtmektedir.
Ders:
Aynı model ailesinde BF16 baseline ile resmî FP8 deployment checkpoint’ini karşılaştırmak, quantization değerlendirmesi için güçlü bir başlangıçtır.
17.2 Senaryo 2 — Doğrudan FP8 yayın: GLM-5.3
zai-org/GLM-5.3, 753B sınıfında bir modeldir ve model repository’sinde BF16, F8_E4M3 ve F32 tensor tipleriyle birlikte FP8 olarak etiketlenmiştir.
Buradaki önemli nokta:
Quantization artık yalnızca topluluk tarafından sonradan yapılan bir işlem değildir.
Model üreticileri doğrudan low-precision checkpoint yayınlayabilmektedir.
Ders:
Modelin yayınlandığı precision, deployment mimarisinin bir parçası hâline gelmektedir.
17.3 Senaryo 3 — Üçüncü parti quant (NVIDIA): Qwen3.8-27B-NVFP4
nvidia/Qwen3.8-27B-NVFP4, NVIDIA Model Optimizer ile hazırlanmış bir deployment checkpoint’idir.
Model kartında:
- Model Optimizer v0.48.0
- mixed NVFP4/FP8
- NVFP4 → MLP +
lm_head - FP8 → self-attention + linear-attention
- 2.048 calibration sample
- Local-Hessian calibration
- Nemotron-Post-Training-Dataset-v3
- vLLM
- Grace Blackwell GB300
bilgileri açıkça belirtilmiştir.
Ayrıca BF16 ve NVFP4 sonuçları aynı benchmark setinde karşılaştırılmıştır.
| Benchmark | BF16 | NVFP4 |
|---|---|---|
| GPQA Diamond | 88.92 | 88.01 |
| Terminal-Bench | 75.56 | 74.02 |
| AA-LCR | 72.63 | 73.38 |
| MMMU-Pro | 75.14 | 74.86 |
| SciCode | 47.93 | 48.41 |
| IFBench | 80.07 | 78.93 |
Buradaki asıl ders skorların tek tek değerinden daha önemlidir:
Quantization recipe + calibration + evaluation methodology açıkça belgelenmiştir.
Bu nedenle checkpoint bağımsız olarak incelenebilir ve yeniden üretilebilir.
17.4 Senaryo 4 — QAT ile 4-bit: Kimi K3
moonshotai/Kimi-K3:
- 2.8T total parameters
- 104B activated parameters
- 1M context
- MXFP4 weights
- MXFP8 activations
- Quantization-Aware Training (SFT aşamasından itibaren)
kullanır.
Kartın önerdiği inference runtime’leri: vLLM, SGLang ve TokenSpeed.
Asıl nokta:
Model üreticisi, quantization’ı sonradan uygulamak yerine SFT aşamasından itibaren quantization-aware eğitimle üretip MXFP4 / MXFP8 olarak yayınlamaktadır. Burada quantization, eğitim tamamlandıktan sonra uygulanan bir “sıkıştırma işlemi” değil; modelin yayıma hazırlık sürecinin tasarım kararıdır.
Bu örnek çoğu varsayımı aynı anda değiştirir:
1. “Orijinal = BF16, quantize edilmiş = türev” varsayımı geçersizleşir.
Bu modelin resmî yayını zaten 4-bit‘tür. “BF16’ya geri dönüp kaliteyi kurtarmak” diye bir durum yoktur; referans checkpoint’in kendisi quantized’dır.
2. Quantization artık yalnızca son çare değildir; kimi modelde tek resmî formdur.
§19 seçim akışındaki “resmî FP8/FP4 yayın var mı?” adımının en güçlü örneği budur: modelin üretilmiş quantize formu, modelin aslının kendisidir.
3. Konu yalnızca weight quantization değildir.
MXFP4 weights + MXFP8 activations birlikte ele alındığında weight+activation (tam-tensor) quantization’dır; §6’daki weight-only / weight+activation ayrımının uç örneği, AWQ/GPTQ’nun weight-only yaklaşımından farklıdır.
4. MXFP4 açık OCP standardıdır.
§5’te bahsedilen taşınabilirlik hedefinin örneğidir: tek üreticiye bağlı olmayan açık bir format ailesi kullanılır. Moonshot AI’nin gerekçesi de birebir budur; kart, MXFP4 / MXFP8 seçimini “geniş donanım uyumluluğu” için yapıldığını belirtir.
5. Kalite doğrulaması ters yönde okunur.
Soru “4-bit kaç kaybetti?” değil, “üreticinin eğittiği 4-bit çalışma koşulu benim workload’umda yeterli mi?” olmalıdır. Yanıt, §16’daki gibi okunan model kartı benchmark’ı ve kendi production workload testinle verilir.
Ders:
PTQ ve QAT aynı şey değildir.
PTQ:
BF16 model
   ↓
training completed
   ↓
quantization
QAT:
Quantized operating conditions
        ↓
part of the training / post-training process
        ↓
quantized model
şeklinde düşünülebilir.
İki ek ders daha çıkar:
Düşük bit her zaman “ödün” değildir. QAT’ta 4-bit, hedef çalışma koşuludur; kalite bu koşula göre optimize edilir. “Düşük bit = kabul edilmiş kayıp” algısı bu model sınıfı için geçerli değildir.
Model card kontrol listesi (§15) QAT modellerinde farklı okunur. “Calibration dataset” yerine eğitim/post-training recipe’si ve eğitimde kullanılan quantization simülasyonu aranır; §13’teki calibration akışı PTQ’ya özgüdür.
18. PTQ mi, QAT mi?
| Özellik | PTQ | QAT |
|---|---|---|
| Eğitim sonrası uygulanabilir | Evet | Hayır / training gerekir |
| Maliyet | Daha düşük | Daha yüksek |
| Deployment için hızlı | Evet | Daha uzun süreç |
| Calibration ihtiyacı | Genellikle evet | Recipe’ye bağlı |
| Çok düşük precision | Daha zor | Daha avantajlı olabilir |
| Model kalitesini optimize etme | Sınırlı | Daha güçlü |
| Mevcut model için pratik | Çok uygun | Daha maliyetli |
Production deployment’ta çoğu kullanıcı için PTQ daha pratik başlangıç noktasıdır.
Ancak çok düşük precision veya frontier model deployment’ında QAT önemli bir seçenek hâline gelebilir.
19. Quantization Seçim Akışı
Pratik karar süreci şu şekilde olmalıdır:
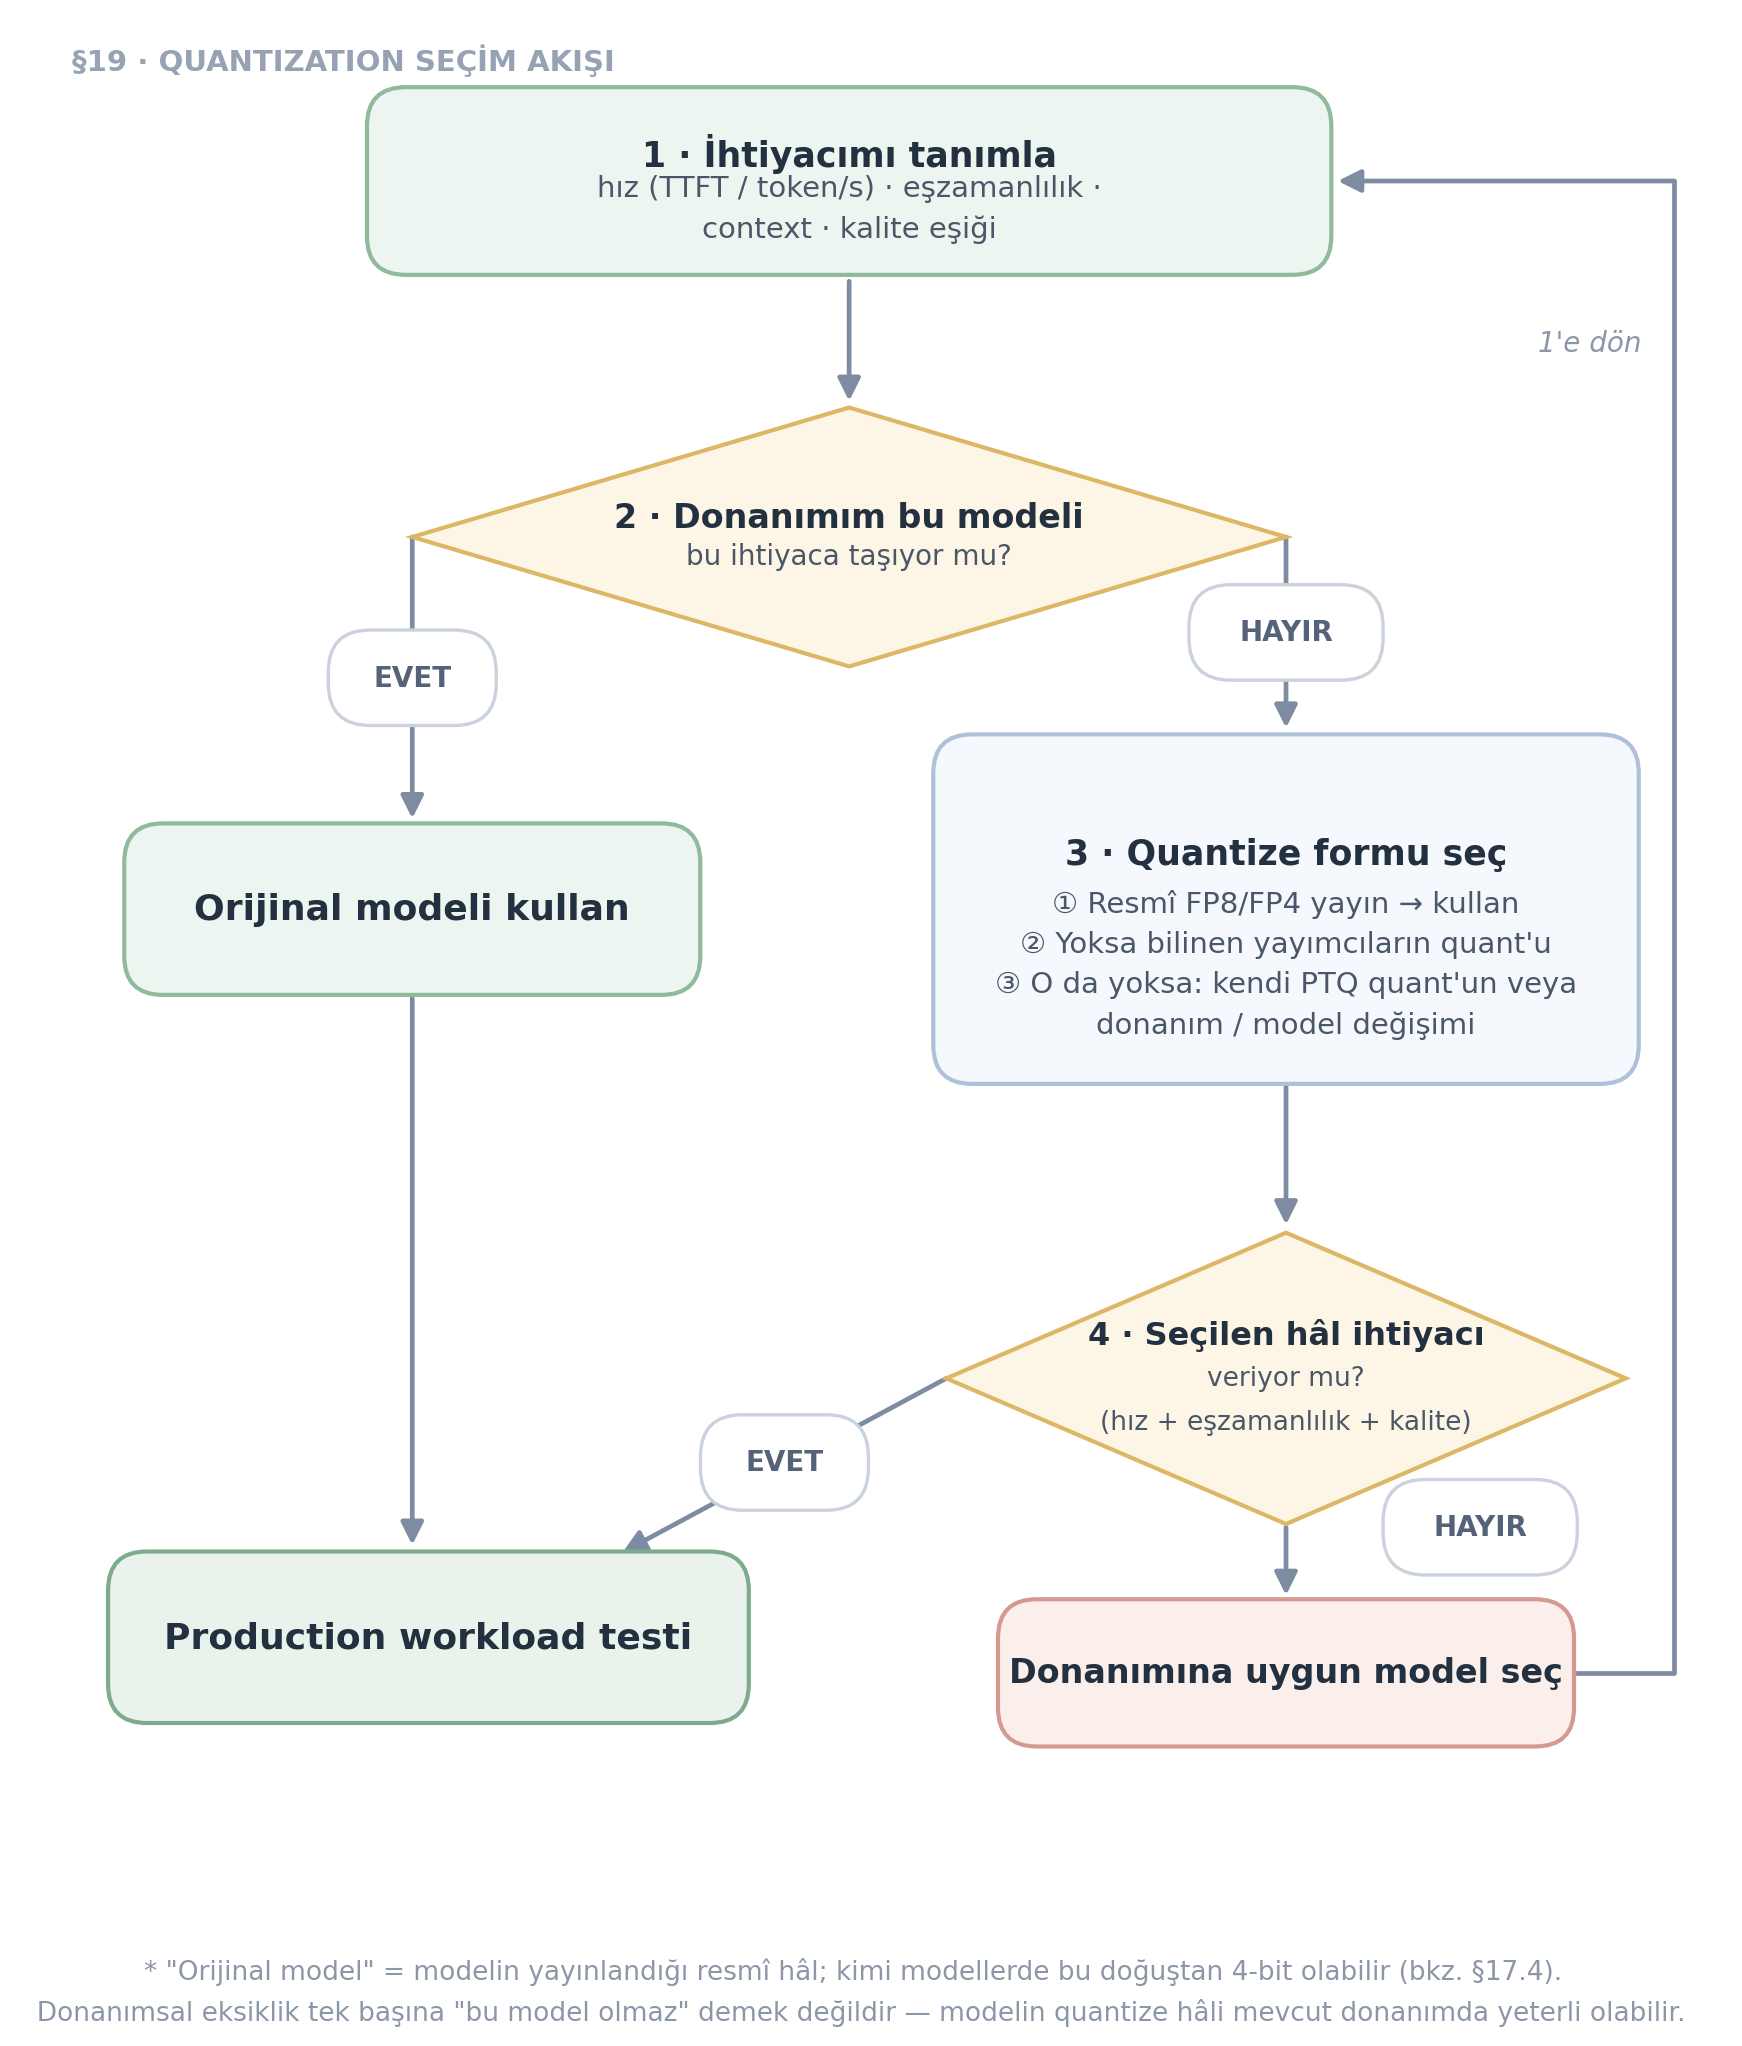
- İhtiyacımı tanımla: gerekli hız (TTFT / token/s), eşzamanlılık, context, kalite eşiği.
- Donanımım bu modeli bu ihtiyaca taşıyor mu?
- Evet → orijinal modeli kullan → production workload testi.
- Hayır → 3. adıma geç.
- Quantize formu seç:
- Modelin resmî FP8/FP4 yayın varsa → onu kullan.
- Yoksa bilinen yayımcıların (NVIDIA, bilinen framework / topluluklar) quant’unu kullan (bkz. §14).
- O da yoksa → kendi quant’un (PTQ) veya donanım / model değişimi.
- Seçilen hâl ihtiyacı veriyor mu? (hız + eşzamanlılık + kalite)
- Evet → production workload testi.
- Hayır → donanımına uygun model seç ve 1. adımdan tekrar başla.
Not: “Orijinal model” = modelin yayınlandığı resmî hâl; kimi modellerde bu doğuştan 4-bit olabilir (bkz. §17.4).
Temel prensip:
Donanımsal eksiklik tek başına “bu model olmaz” demek değildir. Modelin quantize hâli mevcut donanımda gerekli hız ve eşzamanlılığı verebilir; amaç en düşük bit’i seçmek değil, ihtiyacı donanımın güçlü olduğu precision’da karşılamaktır.
Ancak yüksek throughput veya kapasite hedefleniyorsa daha düşük precision ekonomik olarak daha iyi olabilir.
20. Sık Yapılan Hatalar
1. Donanım orijinal model için yeterliyken gereksiz yere 4-bit’e geçmek
Daha düşük precision her zaman daha iyi değildir. Eğer donanımımız orijinal model için yeterliyse — hız, eşzamanlılık vs. — boşu boşuna quantization’a geçmemek gerekir (bkz. §19).
2. Orijinal model benchmark’ını quantized modele mal etmek
BF16 sonucu:
BF16 checkpoint’in sonucudur.
Quantized checkpoint ayrıca doğrulanmalıdır.
3. “4-bit = 4-bit” demek
AWQ, GPTQ, NF4, MXFP4 ve NVFP4 aynı şey değildir.
4. Native hardware acceleration ile software support’u karıştırmak
Bir runtime’ın bir formatı kabul etmesi, GPU’nun o formatı native olarak hızlandırdığı anlamına gelmez.
5. Sadece tokens/s ölçmek
Daha yüksek throughput, daha iyi deployment anlamına gelmez.
TTFT, ITL, latency ve concurrency (gecikme ve eşzamanlılık) de ölçülmelidir.
6. KV Cache’i unutmak
Özellikle uzun context’te ağırlık quantization kadar KV Cache precision da önemlidir.
7. Calibration bilgisini göz ardı etmek
Aynı formatın farklı calibration recipe’leri farklı sonuçlar verebilir.
8. Sadece genel benchmark’a güvenmek
Modelin gerçek kullanım alanı coding ise coding; agent ise agent; RAG ise uzun-context retrieval performansı test edilmelidir.
21. Özet Karar Tablosu
| Senaryo | Başlangıç tercihi |
|---|---|
| Kalite kritik | BF16 / FP8 |
| Ada | FP8’i mutlaka değerlendir |
| Hopper production serving | FP8 + uygun KV Cache precision |
| Ampere 4-bit | AWQ/GPTQ + optimized INT4 kernel |
| Blackwell, maksimum kapasite/throughput | NVFP4’i değerlendir |
| Blackwell, kalite önceliği | FP8 |
| Multi-vendor deployment | MXFP4 / desteklenen ortak formatlar |
| Uzun context | Weight quantization + KV Cache precision birlikte değerlendir |
| Fine-tuning / QLoRA | NF4 / uygun training precision |
| Kritik production deployment | Resmî checkpoint + kendi workload benchmark’ın |
Not: Önce donanım × ihtiyaç denklemi kurulur (bkz. §19): donanımınız modeli ihtiyacınızla taşıyorsa orijinal modeli kullanın; taşımıyorsa quantize formlara bakın.
22. Hızlı Komut Referansı
FP8
vllm serve <model> \
  --quantization fp8 \
  --kv-cache-dtype fp8
NVIDIA NVFP4
vllm serve <model-nvfp4> \
  --kv-cache-dtype fp8_e4m3
AWQ / GPTQ
vllm serve <model-awq-or-gptq>
GGUF
llama-server \
  -m model-Q4_K_M.gguf \
  -ngl 99
Quantization karşılaştırması
BF16 baseline
        ↓
FP8
        ↓
NVFP4 / INT4
        ↓
same benchmark
        ↓
same production workload
23. Quantization Kalitesini Değerlendirme
Tek bir evrensel eşik kullanılmamalıdır.
Örneğin:
“MMLU’da %1’den fazla düşüş varsa quantization başarısızdır.”
şeklinde genel bir kural doğru değildir.
Bazı workload’larda %1 kayıp kabul edilebilirken, bazı kritik coding veya reasoning uygulamalarında çok küçük bir düşüş bile önemli olabilir.
Daha doğru yaklaşım:
Quality loss
      ×
Business impact
      ×
Performance gain
      ×
Memory saving
birlikte değerlendirilmelidir.
Örneğin:
FP8
Quality = 100
VRAM = 100
Speed = 1.0

NVFP4
Quality = 99.2
VRAM = 55
Speed = 1.7
gibi bir sonuçta NVFP4 daha mantıklı olabilir.
Ancak:
Quality = 95
oluyorsa aynı deployment için FP8 tercih edilebilir.
Dolayısıyla doğru eşik:
İş yükünün kabul edebileceği minimum kalite + gerekli performans + mevcut VRAM
üçlüsünden çıkarılmalıdır.
24. Terimler Sözlüğü
BF16 / FP16 Genellikle yüksek precision referans çalışma formatlarıdır.
FP8 8-bit floating-point format ailesidir. E4M3 ve E5M2 gibi varyantları bulunur.
NVFP4 NVIDIA Blackwell için tasarlanmış 4-bit floating-point formatıdır. Fine-grained scaling kullanır.
MXFP4 OCP Microscaling format ailesinin 4-bit floating-point formatıdır.
MXFP8 OCP Microscaling format ailesinin 8-bit floating-point formatıdır. Daha yüksek numeric precision gereken activation gibi verilerde tercih edilir; örneğin MXFP4 weights + MXFP8 activations kombinasyonu (bkz. §17.4).
AWQ Activation-aware Weight Quantization. Özellikle weight-only INT4 deployment’larında yaygındır.
GPTQ Post-training weight quantization yöntemidir.
EXL2 ExLlama ekosisteminde kullanılan değişken bit-per-weight yaklaşımıdır.
GGUF llama.cpp ekosisteminde kullanılan model dosya formatıdır.
KV Cache Attention sırasında önceki token’ların Key/Value temsilini saklayan cache’tir.
PTQ Post-Training Quantization. Eğitim tamamlandıktan sonra quantization uygulanmasıdır.
QAT Quantization-Aware Training. Eğitim sürecinde quantization etkilerinin modele dahil edilmesidir.
Calibration Quantization parametrelerini belirlemek için temsilî verilerle yapılan ölçüm sürecidir.
Block size / group size Quantization scaling veya parameter grouping’in hangi granülerlikte uygulandığını belirler.
Perplexity Dil modelinin tahmin performansını ölçen temel metriklerden biridir.
Precision Sayısal değerlerin (ağırlık, activation, KV cache) kaç bit ile temsil edildiğini belirten gösterim biçimidir: “yüksek precision” = daha çok bit. Türkçede “hassasiyet” olarak da anılır; ancak modelin doğruluğu (accuracy) ile karıştırılmamalıdır. Düşük precision daha az bit kullanır, mutlaka daha yanlış model demek değildir.
MMLU / GSM8K / GPQA Farklı yetenek alanlarını ölçmek için kullanılan benchmark’lardır.
25. Sonuç
Quantization’ı ne küçümsemek ne de “her zaman daha hızlıdır” şeklinde değerlendirmek gerekir.
Modern LLM deployment’ta quantization:
Bellek kapasitesi, bellek bant genişliği (memory bandwidth), Tensor Core throughput ve deployment maliyeti arasında optimizasyon yapan temel bir mühendislik aracıdır.
Doğru seçim yalnızca bit sayısına bakılarak yapılamaz.
Şu dört soru birlikte sorulmalıdır:
1. At which precision was the model released?

2. Which precision does the GPU accelerate natively?

3. How was the quantization produced, with which calibration recipe?

4. What do quality and performance look like in my real workload?
Bunların sonucunda ideal deployment şu şekilde seçilir:
İhtiyacı karşılayan, GPU tarafından verimli biçimde hızlandırılan ve kalite kaybı ölçülmüş en düşük maliyetli precision.
Bu nedenle quantization için en doğru yaklaşım:
“En düşük bit sayısını seç.”
değil,
“İş yüküm için gerekli kaliteyi koruyarak donanımın güçlü olduğu precision’ı seç ve gerçek deployment üzerinde doğrula.”
olmalıdır.
26. Referanslar
- Z.ai — GLM-5.3 Model Card
- Qwen — Qwen3.8-27B Model Card
- Qwen — Qwen3.8-27B-FP8 Model Card
- NVIDIA — Qwen3.8-27B-NVFP4 Model Card
- NVIDIA Model Optimizer — Local-Hessian Quantization
- NVIDIA — Introducing NVFP4 for Efficient and Accurate Low-Precision Inference
- NVIDIA — Hopper Architecture
- NVIDIA — Ada Lovelace Architecture
- NVIDIA — A100 Architecture / Specifications
- NVIDIA TensorRT-LLM — Quantization Hardware Support
- Moonshot AI — Kimi K3 Model Card
- OCP Microscaling Formats — MXFP4 / MXFP8