Hazırlayan: Openzeka Teknoloji A.Ş. — NVIDIA Türkiye & MEA Resmî Embedded Compute Distribütörü ve NVIDIA Elite Partner
Test platformu: 8× NVIDIA DGX Spark (GB10) · Model: DeepSeek-V4.1-Flash (763B) · Rapor tarihi: Eylül 2026
İçindekiler
- 1. Giriş
- 2. Donanım
- 3. Docker İmajları
- 4. TP8 Optimizasyonları
- 5. Yapılandırma
- 6. Bellek Analizi
- 7. Performans Sonuçları
- 8. Karşılaştırmalı Analiz
- 9. SLO ve Kapasite
- 10. Öğrenilen Dersler
- 11. Sonuç
- Ek A: Doğrulama Komutları
1. Giriş
Bu rapor, DeepSeek-V4.1-Flash (763B MoE) modelinin 8× NVIDIA DGX Spark (GB10) üzerinde tensor-parallel (TP=8) dağıtımını belgeler. 4× DGX Spark TP4 dağıtım raporunun devamıdır; model mimarisi, vLLM build zinciri ve SM 12.1a patch’leri orada açıklandığı için burada tekrar edilmemiştir.
İki yapılandırma test edilmiştir:
- TP8-300K (Engram bellekte): 300K bağlam; Engram tabloları orijinal (stock) vLLM ile sabitlenmiş (pinned) host belleğine yüklenir, GMU 0.80, AutoTuner kapalı.
- TP8-1M (Engram diskte): 1M bağlam; Engram tabloları Engram-on-disk patch’i ile yerel NVMe’de tutulur, GMU 0.75, AutoTuner açık.
Her iki yapılandırma da DSpark k=5 speculative decoding, CUDA graphs (FULL_AND_PIECEWISE modu) ile görüntü (vision) ve araç çağırma (tool calling) desteğini kullanır.
Neden iki yapılandırma? Engram-on-disk patch’i satırları forward öncesinde GPU belleğine stage eder ve CUDA graph capture’ı etkinleştirir. Ancak 300K bağlamda 8 rank’in birleşik belleği, Engram’ı sabitlenmiş host belleğinde tutmak için yeterlidir. 300K-bellek yapılandırması, bağlam sınırlıyken orijinal yolun daha hızlı olup olmadığını test eder; 1M-disk yapılandırması ise yapılandırılan bağlam sınırını yükseltir. Benchmark kısa prompt’lar kullanır; azami bağlam uzunluğunu test etmez.
2. Donanım
| Bileşen | Değer |
|---|---|
| GPU | Blackwell mimarisi (GB10), SM 12.1a (CC 12.1), 48 SM |
| GPU belleği | Düğüm başına 128 GB unified LPDDR5X (CPU+GPU paylaşımlı) |
| Bellek bant genişliği | Düğüm başına ~273 GB/s (unified) |
| FP4 tepe performansı (seyreklik ile) | Düğüm başına ~1 PFLOP |
| CPU | Düğüm başına 20 çekirdekli Arm (10× Cortex-X925 + 10× Cortex-A725) |
| Düğümler arası bağlantı | NVIDIA ConnectX-7, 200 Gb/s RDMA (QSFP) |
| Depolama | 8× NVMe SSD (1× 1 TB + 7× 4 TB; 8 düğüm genelinde toplam) |
| Ağ topolojisi | 200 GbE switch (NVLink yok; all-reduce Ethernet üzerinden) |
8 düğüm × 128 GB = küme genelinde 1024 GB toplam birleşik bellek.
Kritik mimari gerçek: DGX Spark’lar arasında NVLink yoktur. Bu rapordaki TP=8, ConnectX-7 200 GbE ağı üzerinden çok düğümlü tensor parallelism‘dir — her all-reduce işlemi 200 GbE switch üzerinden Ethernet ağını geçer.
3. Docker İmajları
İki imaj kullanılır; ikisi de TP4 dağıtımıyla aynı temel imajdan türetilir. Birincisi (vllm-dsv41:latest) bu temel imajın kendisidir; ikincisi (vllm-dsv41:engram-mem) onun üzerine inşa edilir.
3.1 vllm-dsv41:latest (7 patch, Engram-on-disk)
TP8-1M yapılandırması tarafından kullanılır. TP4 imajıyla aynıdır — Engram-on-disk dahil 7 SM 12.1a patch’inin tamamı gömülüdür. Tam patch listesi ve build talimatları için TP4 dağıtım raporu, Bölüm 4‘e bakınız.
3.2 vllm-dsv41:engram-mem (4 patch, Engram bellekte)
TP8-300K yapılandırması tarafından kullanılır. vllm-dsv41:latest üzerine, üç Engram patch dosyası orijinal vLLM sürümüne geri döndürülerek üretilir:
FROM vllm-dsv41:latest
COPY vllm/vllm/models/deepseek_v4_1/common/engram.py /usr/local/lib/python3.12/dist-packages/vllm/models/deepseek_v4_1/common/engram.py
COPY vllm/vllm/model_executor/model_loader/weight_utils.py /usr/local/lib/python3.12/dist-packages/vllm/model_executor/model_loader/weight_utils.py
COPY vllm/vllm/models/deepseek_v4_1/nvidia/model_state.py /usr/local/lib/python3.12/dist-packages/vllm/models/deepseek_v4_1/nvidia/model_state.py
ENTRYPOINT []
Kalan 4 patch (attention, FlashInfer sparse, SWA, sparse indexer) korunur. Orijinal Engram işleyişiyle tablolar sabitlenmiş host belleğine yüklenir ve forward her adımda bir host round-trip yapar — CUDA graph’ler Engram lookup’ı capture edemez.
| İmaj | Engram.py | model_state.py | weight_utils.py | attention.py | flashinfer_sparse.py | sparse_swa.py | sparse_attn_indexer.py |
|---|---|---|---|---|---|---|---|
vllm-dsv41:latest |
patch’li | patch’li | patch’li | patch’li | patch’li | patch’li | patch’li |
vllm-dsv41:engram-mem |
orijinal | orijinal | orijinal | patch’li | patch’li | patch’li | patch’li |
4. TP8 Optimizasyonları
TP=8, 8-rank NCCL iletişimi sunar ve bu, TP=4’te gerekmeyen optimizasyonlar gerektirir.
4.1 NCCL Kanal Azaltma
TP=8’de NCCL default olarak 64 kanal kullanır — rank başına yaklaşık 37 GB overhead. Üç environment variable bunu azaltır:
| Ayar | Değer | Etki |
|---|---|---|
NCCL_MAX_NCHANNELS |
8 |
64 → 8 kanal (rank başına ~26 GB tasarruf) |
NCCL_BUFFSIZE |
1048576 |
4 MiB → 1 MiB buffer |
NCCL_NVLS_ENABLE |
0 |
GB10’da NVLink SHARP yok |
4.2 Container Limitleri
| Ayar | Değer | Sebep |
|---|---|---|
ulimit: nofile |
1048576:1048576 |
NCCL 2.30 8-rank socket accept limiti |
ulimit: memlock |
-1:-1 |
RDMA memory pinning (ibv_reg_mr) |
ulimit: stack |
67108864 |
64 MB stack |
cap_add: IPC_LOCK |
— | RDMA memory pinning capability |
memory_limit |
112g |
OS için 9 GB bırak (121 GB toplam) |
memlock=-1:-1 ve IPC_LOCK olmadan NCCL init ibv_reg_mr_iova2 failed with error Cannot allocate memory hatasıyla başarısız olur.
4.3 NCCL Environment
NCCL_IB_ROCE_VERSION_NUM: '2'      # RoCE v2
NCCL_IB_ADDR_FAMILY: 'AF_INET'     # IPv4
NCCL_NVLS_ENABLE: '0'              # GB10'da NVLink SHARP yok
NCCL_IB_MERGE_NICS: '0'           # NIC merge kapalı
NCCL_CROSS_NIC: '1'               # Çapraz NIC
NCCL_IGNORE_CPU_AFFINITY: '1'     # CPU affinity ignore
NCCL_CUMEM_ENABLE: '0'            # NCCL cumem kapalı
TORCH_NCCL_ASYNC_ERROR_HANDLING: '1'
NCCL_DEBUG: 'WARN'
5. Yapılandırma
5.1 TP8-300K (Engram bellekte)
| Parametre | Değer | Açıklama |
|---|---|---|
| İmaj | vllm-dsv41:engram-mem |
Orijinal Engram işleyişi |
tensor_parallel |
8 | 8 düğüm × 1 GPU |
gpu_memory_utilization |
0.80 | %80 GMU |
max_model_len |
300000 | 300K bağlam |
max_num_seqs |
8 | Maksimum 8 eşzamanlı dizi |
max_num_batched_tokens |
8192 | Prefill batch boyutu |
block_size |
128 | KV önbellek blok boyutu |
distributed-executor-backend |
mp | Multiprocess backend |
| AutoTuner | kapalı (VLLM_FLASHINFER_AUTOTUNE: '0') |
OOM spike’ı önler |
5.2 TP8-1M (Engram diskte)
| Parametre | Değer | Açıklama |
|---|---|---|
| İmaj | vllm-dsv41:latest |
Engram-on-disk patch aktif |
tensor_parallel |
8 | 8 düğüm × 1 GPU |
gpu_memory_utilization |
0.75 | %75 GMU (1M KV için daha düşük) |
max_model_len |
1048576 | 1M bağlam |
max_num_seqs |
8 | Maksimum 8 eşzamanlı dizi |
max_num_batched_tokens |
8192 | Prefill batch boyutu |
block_size |
128 | KV önbellek blok boyutu |
distributed-executor-backend |
mp | Multiprocess backend |
DSV41_ENGRAM_DISK |
1 | Engram satırları yerel NVMe’de |
| AutoTuner | açık (default) | Yeterli bellek boşluğu |
5.3 Speculative Decoding (her ikisi)
{
  "method": "dspark",
  "num_speculative_tokens": 5,
  "draft_sample_method": "probabilistic",
  "rejection_sample_method": "block",
  "enable_adaptive_verification": false
}
5.4 Çalıştırma Komutu
# TP8-300K (Engram bellekte)
sparkrun run /home/nvidia/.cordatus-sparkrun/recipes/deepseek-v41-flash-tp8.yaml \
  --hosts 192.168.1.153,192.168.1.147,192.168.1.157,192.168.1.158,192.168.1.161,192.168.1.162,192.168.1.166,192.168.1.148 \
  --foreground

# TP8-1M (Engram diskte)
sparkrun run /home/nvidia/.cordatus-sparkrun/recipes/deepseek-v41-flash-tp8-1m.yaml \
  --hosts 192.168.1.153,192.168.1.147,192.168.1.157,192.168.1.158,192.168.1.161,192.168.1.162,192.168.1.166,192.168.1.148 \
  --foreground
6. Bellek Analizi
6.1 TP8-300K (Engram bellekte)
| Bileşen | GB/rank |
|---|---|
| Model (GPU) | 49.55 |
| Engram (sabitlenmiş host) | 23.60 |
| NCCL (8 kanal) | ~11 |
| CUDA graphs | ~1.5 |
| Toplam | ~85.5 |
| GMU=0.80 bütçe | 96.8 |
| KV önbellek | ~8.7 GB (1.46M token) |
6.2 TP8-1M (Engram diskte)
| Bileşen | GB/rank |
|---|---|
| Model (GPU, Engram’sız) | 38 |
| NCCL (8 kanal) | ~11 |
| AutoTune spike | ~10 |
| CUDA graphs | ~1.5 |
| Toplam | ~60.5 |
| GMU=0.75 bütçe | 90.75 |
| KV önbellek | ~30 GB |
| 1M bağlam gereksinimi | ~3.7 GB |
| Boş headroom | ~26 GB |
Engram-on-disk yapılandırmasında KV cache’e daha fazla bellek ayrıldığı (~30 GB vs ~8.7 GB) ve bağlam sınırının 1M olarak ayarlandığı raporlanmıştır. Tablo yerleşimi, bellek ayarları ve yürütme yolları birlikte değiştiğinden ölçülen hız farkı yalnızca disk I/O maliyeti olarak yorumlanamaz. Mekanizma ve aynı donanımdaki karşılaştırma için LLM Çıkarımında Engram Offloading rehberine bakınız.
7. Performans Sonuçları
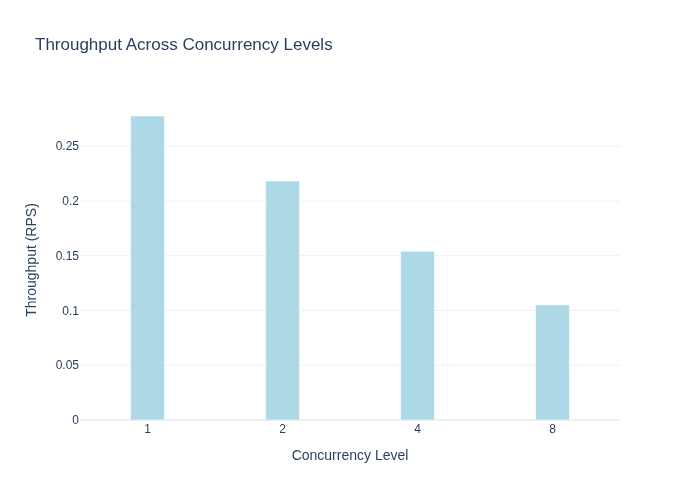
7.1 TP8-300K (Engram bellekte)
Ölçümler CordatusAI/llm-benchmark aracı ile alınmıştır.
| Concurrency | TTFT (ms) | ITL (ms) | TPS (tok/s) | Latency (s) | Throughput (RPS) |
|---|---|---|---|---|---|
| 1 | 213.19 | 26.67 | 35.98 | 3.60 | 0.28 |
| 2 | 279.55 | 33.87 | 28.21 | 4.58 | 0.22 |
| 4 | 370.36 | 48.16 | 20.10 | 6.49 | 0.15 |
| 8 | 488.22 | 71.12 | 13.63 | 9.52 | 0.11 |
7.2 TP8-1M (Engram diskte)
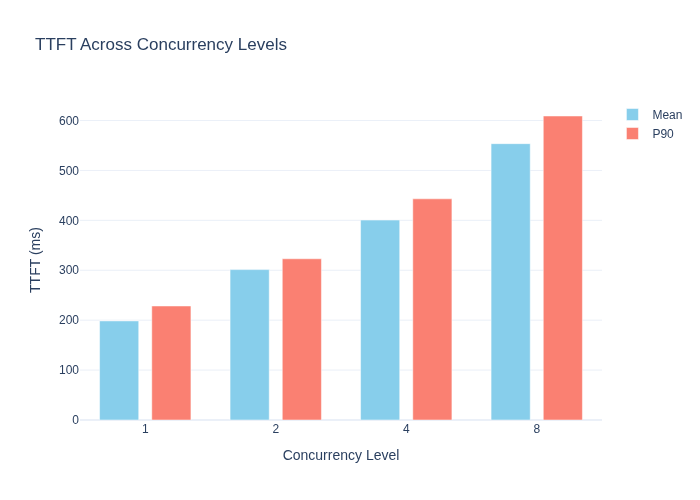
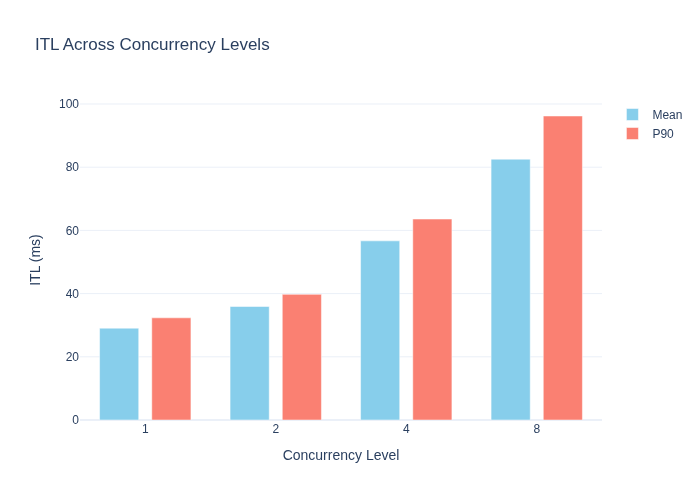
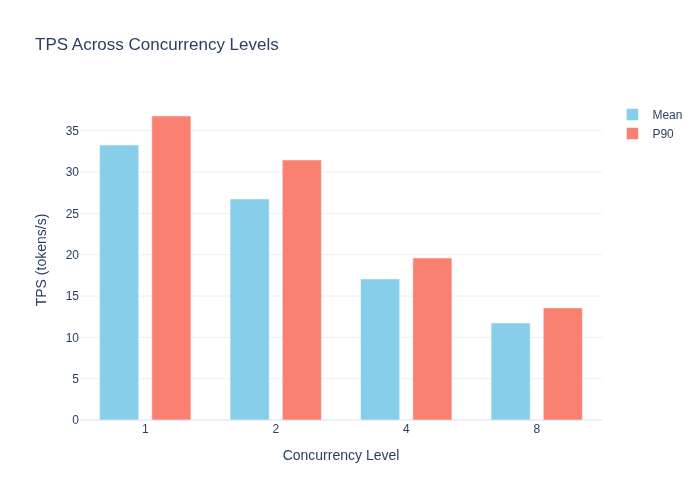
| Concurrency | TTFT (ms) | ITL (ms) | TPS (tok/s) | Latency (s) | Throughput (RPS) |
|---|---|---|---|---|---|
| 1 | 198.54 | 29.06 | 33.28 | 3.89 | 0.26 |
| 2 | 301.32 | 35.92 | 26.76 | 4.86 | 0.21 |
| 4 | 400.58 | 56.68 | 17.07 | 7.60 | 0.13 |
| 8 | 553.68 | 82.54 | 11.74 | 11.04 | 0.09 |
7.3 Grafikler — TP8-300K (Engram bellekte)
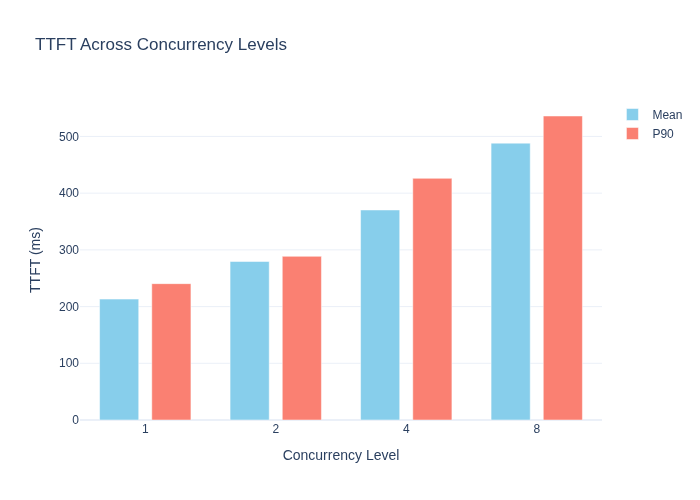
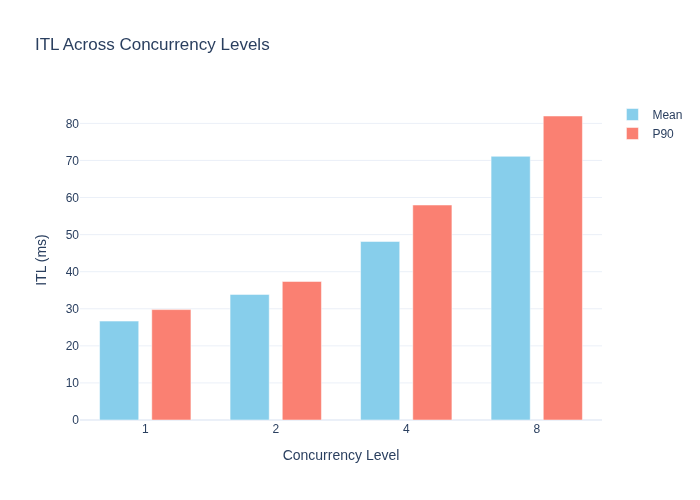
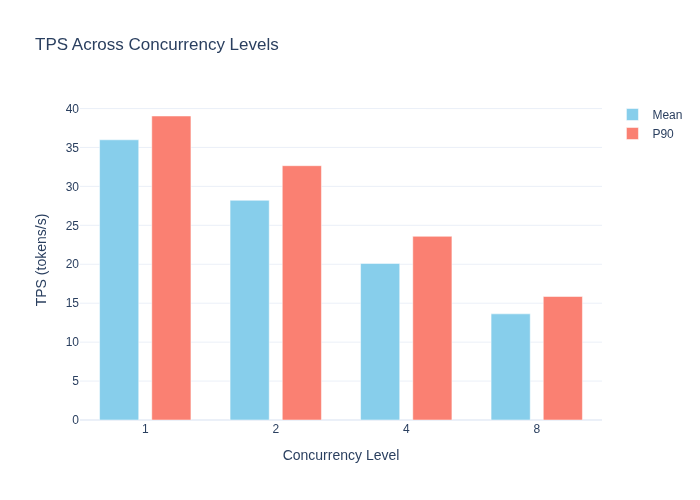
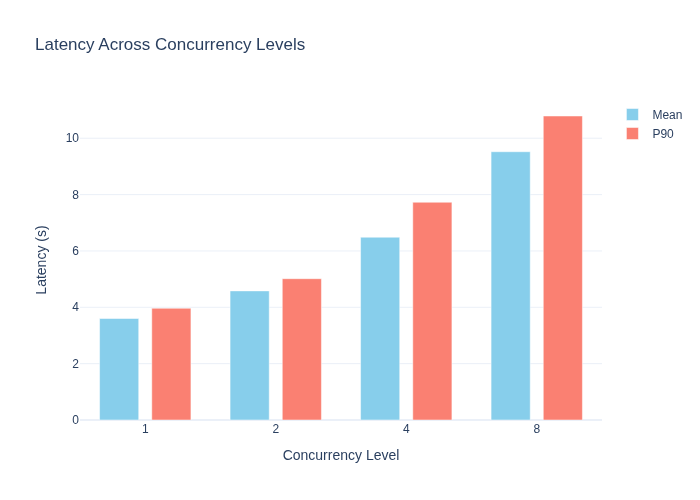
7.4 Grafikler — TP8-1M (Engram diskte)
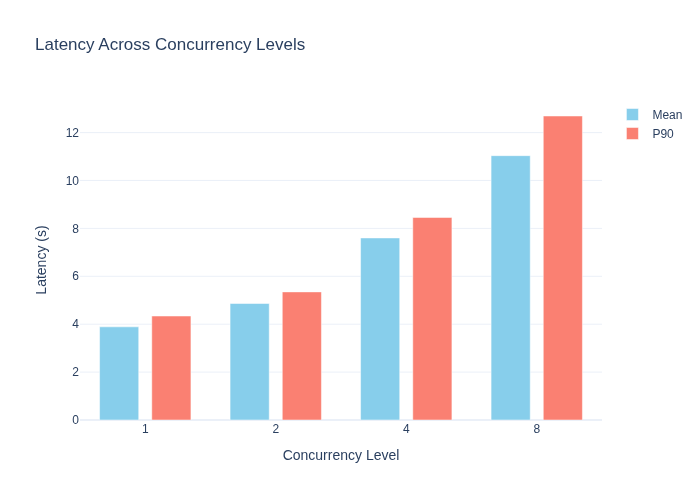
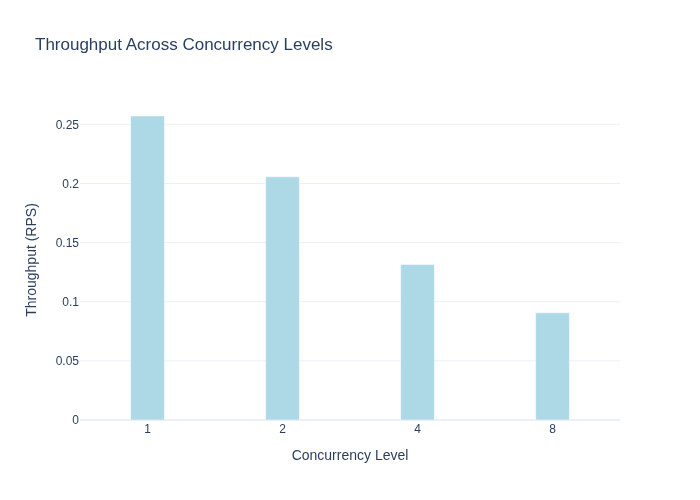
7.5 Değerlendirme
- TP8-300K, test edilen her eşzamanlılık seviyesinde TP8-1M’den daha yüksek TPS sağlar (C=1’de 35.98 vs 33.28). Karşılaştırma, yapılandırmaların bütününü kapsar; tablo yerleşimi, bağlam ayarları, CUDA graph ve AutoTuner etkileri ayrı ölçülmemiştir.
- C=1’de TTFT, 1M yapılandırmasında daha düşüktür (199 ms vs 213 ms). Yürütme yolları farklıdır; bu ölçüm tek başına farkın nedenini belirlemez.
- Max C = 4 TP8-300K için, 2 TP8-1M için (Benchmark Gezgini’nin varsayılan hedeflerinde: TTFT≤1000ms, TPS≥20). TP8-300K, TP4 kapasitesinin (Max C=2) iki katıdır; TP8-1M C=4’te 17.07 tok/s ile TPS hedefinin hemen altında kalır.
- TPS düşüşü C=1’den C=8’e: %62 (300K), %65 (1M) — küme doygunluğa yaklaşırken bellek bant genişliği çekişmesi.
8. Karşılaştırmalı Analiz
8.1 TP4 vs TP8 vs B300
| Concurrency | TP4 TPS | TP8-300K TPS | TP8-1M TPS | B300 TPS |
|---|---|---|---|---|
| 1 | 29.48 | 35.98 | 33.28 | 284.54 |
| 2 | 21.32 | 28.21 | 26.76 | 294.56 |
| 4 | 13.09 | 20.10 | 17.07 | 252.60 |
| 8 | 8.79 | 13.63 | 11.74 | 209.41 |
TP8-300K, C=1’de TP4’ten %22 daha hızlıdır (35.98 vs 29.48) ve C=8’de %55 daha hızlıdır (13.63 vs 8.79). Ölçekleme sublineerdir çünkü model bellek bant genişliği sınırlıdır ve TP=8, 8 düğüm arası all-reduce overhead’i ekler.
B300, C=1’de TP8-300K’den hâlâ ~8× daha hızlıdır (284.54 vs 35.98) — HBM3e bant genişliği farkı (~8 TB/s vs 273 GB/s) baskın gelir.
8.2 TTFT Karşılaştırması
| Concurrency | TP4 TTFT (ms) | TP8-300K TTFT (ms) | TP8-1M TTFT (ms) |
|---|---|---|---|
| 1 | 271.63 | 213.19 | 198.54 |
| 2 | 395.75 | 279.55 | 301.32 |
| 4 | 577.41 | 370.36 | 400.58 |
| 8 | 805.89 | 488.22 | 553.68 |
TP8, tüm concurrency seviyelerinde TTFT’yi %21-39 oranında düşürür — prefill hesaplama sınırlıdır (compute-bound) ve 8 rank daha fazla toplam FLOPS sağlar.
9. SLO ve Kapasite
Benchmark Gezgini’nin varsayılan hedeflerinde (TTFT≤1000ms, TPS≥20 tok/s), TP8-300K Max C = 4 verir — TP4 kapasitesinin (Max C=2) iki katı — TP8-1M ise Max C = 2:
| SLO | Eşik | TP8-300K C=4 | TP8-1M C=4 |
|---|---|---|---|
| TTFT | ≤ 1000 ms | 370 ms ✓ | 401 ms ✓ |
| TPS | ≥ 20 tok/s | 20.10 ✓ | 17.07 ✗ |
Uyarı: C=8’de TPS, her iki yapılandırma için de 20 tok/s eşiğinin altına düşer (13.63 ve 11.74); TP8-1M ise eşiği C=4’te zaten kaçırır. İnteraktif sohbet servisleri için 4 eşzamanlı kullanıcı (TP8-300K) ya da 2 (TP8-1M) önerilir; daha yüksek yük için veri merkezi donanımı (B300/GB300) tercih edilmelidir.
10. Öğrenilen Dersler
- NCCL 8-rank overhead’i büyüktür. Default 64 kanal, rank başına ~37 GB tüketir.
NCCL_MAX_NCHANNELS=8veNCCL_BUFFSIZE=1048576bunu ~11 GB’a düşürür — olmadan model belleğe sığmaz. memlock=-1veIPC_LOCK8-rank RDMA için zorunludur. Olmadan NCCL initibv_reg_mr_iova2 failed with error Cannot allocate memoryhatasıyla başarısız olur.nofile=1048576NCCL 2.30 için gereklidir. 8-rank socket accept, container’ın default 1024 soft limitini aşar.- Disk yapılandırmasında ölçülen C=1 TTFT daha düşüktür (199 ms vs 213 ms). Satırlar forward pass öncesinde hazırlanır; ancak karşılaştırma bu değişikliğin etkisini diğer yapılandırma farklarından ayırmaz.
- AutoTuner OOM’a sebep olabilir.
VLLM_FLASHINFER_AUTOTUNE: '0'FlashInfer autotune’u kapatır ama DeepGEMM/CUTLASS mxfp8_gemm autotune’ını kapatmaz; bu da profiling sırasında ~10 GB tüketir. 1M yapılandırmasında yeterli headroom vardır; 300K yapılandırmasında kapatılır. - sparkrun cluster yönetimi.
sparkrun cluster set-default <name>aktif cluster’ı değiştirir;sparkrun cluster defaultyalnızca görüntüler. - Docker
ENTRYPOINT []zorunludur. Orijinalvllm/vllm-openaiimajındaENTRYPOINT ["vllm","serve"]vardır ve sparkrun komutunu append etmeyi engeller. Son imajda entrypoint temizlenmelidir.
11. Sonuç
- DeepSeek-V4.1-Flash (763B), 8× DGX Spark üzerinde TP=8 ile çalışır — daha büyük cluster, kullanılabilir concurrency’yi ikiye katlar (TP4’te Max C=2, TP8’de Max C=4) ve TPS’yi %22-55 oranında artırır.
- İki yapılandırma farklı kullanım senaryolarına hizmet eder. TP8-300K (Engram bellekte), ölçülen kısa prompt iş yükünde daha yüksek TPS sağlar. TP8-1M (Engram diskte) ise KV cache için daha fazla bellek bırakır ve 1M bağlam sınırıyla yapılandırılır. Bu azami bağlam uzunluğundaki performans ölçülmemiştir.
- NCCL optimizasyonu TP8’in kritik deltasıdır. Kanal azaltma ve uygun ulimit’ler olmadan, 8-rank overhead’i modelin belleğe sığmasını engeller.
- TP8, veri merkezi donanımının yerini almaz. B300, C=1’de hâlâ ~8× daha hızlıdır, ancak TP8, 763B modeli TP4 üzerinden 2× kapasite artışına taşır — geliştirme, prototipleme ve sınırlı ekip production senaryoları için yeterli.
Ek A: Doğrulama Komutları
API Sağlığı
curl http://192.168.1.153:8000/v1/models
Basit Test
curl http://192.168.1.153:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"deepseek-v4.1-flash","max_tokens":50,
       "messages":[{"role":"user","content":"Count from 1 to 10."}]}'
Openzeka Teknoloji A.Ş. — openzeka.com · Tel: +90 312 266 2055
Üniversiteler Mah. Şehit Mustafa Tayyarcan Cad. Tepe Binası No:5 İç Kapı No:315, 06800 Çankaya/Ankara, Türkiye
Bu rapor CordatusAI/llm-benchmark aracı ile üretilen ölçümlerden oluşturulmuştur. Dağıtım reçetesi tonyd2wild/DeepSeek-V4.1-Flash-vLLM-DGX-Spark boot10 config’inden ve im0xMagnus/deepseek-v4.1-flash-uncensored-8x-dgx-spark TP8 port’undan uyarlanmıştır. Rapor tarihi: Eylül 2026